文獻筆記・
生成式 AI 如何可靠支援自律學習
研究有三個明確問題。RQ1 問多代理/單代理 LLM 解析器能否可靠辨識生成鷹架實際支援的 SRL 過程;RQ2 問 LLM-as-a-Judge 能否在兩個候選鷹架間選出較少幻覺、較符合品質要求…
- 論文
- Towards reliable generative AI-driven scaffolding: Reducing hallucinations and enhancing quality in self-regulated learning support
- 作者
- Keyang Qian, Shiqi Liu, Tongguang Li, Mladen Raković, Xinyu Li, Rui Guan, Inge Molenaar, Sadia Nawaz, Zachari Swiecki, Lixiang Yan, Dragan Gašević(2026)
- 期刊
- Computers & Education, 240, 105448
- DOI
- 10.1016/j.compedu.2025.105448
- 分類
- AI 應用
1. 基本資訊
本文關注的不是「讓 LLM 直接替老師教學」,而是如何在個人化自律學習(self-regulated learning, SRL)鷹架送達學生前,先自動檢查生成內容是否真的對準學生需要、是否含有幻覺或不相關建議。作者以 Winne 與 Hadwin 的 COPES 模型作為 SRL 分析骨架,提出兩層檢核:以多代理 LLM 解析鷹架所支援的 SRL 過程,以及用 LLM-as-a-Judge 從多個候選鷹架中挑出較佳版本。研究材料是澳洲兩所中學 66 名 12–15 歲學生完成多來源閱讀寫作任務時留下的行為軌跡,模型再依據軌跡模擬產生個人化鷹架。
2. 研究問題
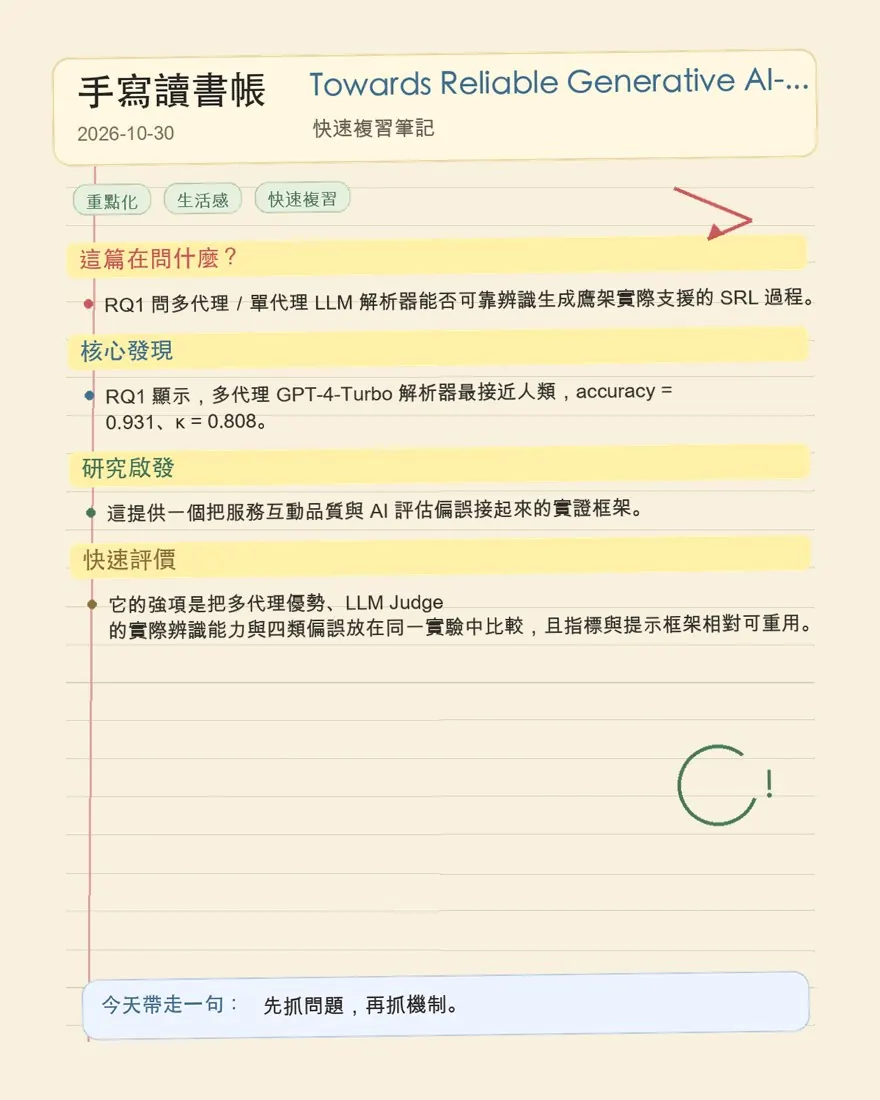
研究有三個明確問題。RQ1 問多代理/單代理 LLM 解析器能否可靠辨識生成鷹架實際支援的 SRL 過程;RQ2 問 LLM-as-a-Judge 能否在兩個候選鷹架間選出較少幻覺、較符合品質要求者;RQ3 問此評審機制是否存在位置偏誤、自我增強偏誤、連續 API 呼叫偏誤與冗長偏誤。三題合在一起,實際上是在測試一個「生成—驗證—重生或選擇」的教育 AI 品質控制迴路,而非只測量模型輸出看起來是否流暢。
3. 理論基礎
核心理論是自律學習與 COPES:Conditions、Operations、Products、Evaluations、Standards。學生的任務條件、操作策略、產出、評估與標準會循環影響下一步調整;因此鷹架不能只給泛泛的鼓勵,而要針對特定可觀察的 SRL 過程,例如查看任務要求、檢查計時器、搜尋註記、整理資料或將閱讀內容轉寫進文章。方法上,本文也借用回饋與 LLM-as-a-Judge 文獻,將「生成品質」拆成可靠性(是否支援被指定的過程)與品質選擇(多個候選中哪個較有用)。這個拆分很重要,因為語言通順不等於理論對準。
4. 研究架構
研究流程是:先以 66 名學生的閱讀—寫作操作軌跡推算各時段不足的 SRL 過程,再於第 15、22、29 分鐘為每位學生產生三段約 100 字鷹架。鷹架由 GPT-4-Turbo、GPT-3.5-Turbo 與 Gemini-Pro 各產生 198 段,共 594 段。第一層以三種模型分別建構單代理與多代理解析器,辨識 15 類 SRL 過程;第二層把含幻覺與不含幻覺的候選配對,交由三種 LLM Judge 比較。人類專家標註作為基準,並另以微調 BERT 作為傳統機器學習基線。這形成「生成器—解析器—評審器—人類驗證」的模組化架構。
5. 假設邏輯
本文沒有用傳統問卷研究的形式提出方向性假設,而是以三個研究問題與可檢驗的比較邏輯替代。其命題邏輯是:若把生成與驗證分開,專責解析的多代理結構應比同一模型自我檢查更可靠;若讓較強的 LLM Judge 比較同一提示下的多個輸出,應能提高挑出低幻覺鷹架的機率;但 LLM 評審的判斷可能受輸入位置、輸出長度、模型自我偏好及前次 API 結果影響。這些預期不是把 LLM 當作中立測量工具,而是把其偏誤本身納入研究對象。
6. 方法
樣本為兩所澳洲中學的 66 名學生(平均 13.44 歲),完成 45 分鐘、200–300 字的 AI 醫療未來主題多來源閱讀寫作任務。系統蒐集時間戳、點擊流、按鍵與導航紀錄,再依理論驅動的 15 類 SRL 過程庫轉碼。人類標註者先共同建立規準,第一輪整體一致性達 κ = 0.879;RQ1 使用 72 段鷹架作人類基準,RQ2 使用 432 段鷹架,其中辨識出 48 段表面幻覺,形成 80 組配對並交換順序。RQ3 以 1,188 次 Judge 比較檢驗位置、自我增強、序列 API 與冗長偏誤。指標包括 accuracy、Cohen’s kappa、精確率、錯誤率、無關率、卡方檢定與 logistic regression。
7. 結果
RQ1 顯示,多代理 GPT-4-Turbo 解析器最接近人類,accuracy = 0.931、κ = 0.808;Gemini-Pro 多代理為 0.854、κ = 0.603;GPT-3.5-Turbo 多代理為 0.803、κ = 0.526。單代理平均只有 accuracy = 0.813、κ = 0.475,而 BERT 基線 accuracy = 0.613、κ = −0.100。可是生成本身仍不穩定:GPT-4-Turbo 的精確率只有 0.613、無關率 0.227;Gemini-Pro 精確率 0.355、無關率 0.551。RQ2 中只有 GPT-4-Turbo Judge 穩定高於機率基準,accuracy = 0.70、κ = 0.40;GPT-3.5-Turbo 為 0.48,Gemini-Pro 為 0.52。RQ3 發現三者都有位置偏誤;GPT-4-Turbo 對自己生成的鷹架偏好約 76%,並有輕微序列依賴;GPT-3.5-Turbo 與 Gemini-Pro 的冗長偏誤更明顯。
8. 理論貢獻
第一,本文把 GenAI 鷹架的品質問題從單一「模型是否會產生幻覺」推進到理論對準問題:輸出即使沒有捏造事實,也可能支援錯誤的 SRL 過程,因而對學生無用。第二,研究把 COPES 這種學習理論轉成可供 LLM 解析與驗證的過程庫,示範理論如何嵌入生成式教育系統的評估管線。第三,研究把 LLM-as-a-Judge 的偏誤帶進教育回饋情境,顯示評審模型不是透明的測量尺,而是另一個需要驗證、去偏與人類監督的代理人。
9. 實務意涵
較可行的部署方式不是讓單一聊天模型直接把文字送給學生,而是採用分層閘門:生成多個候選後,先由獨立多代理解析器檢查是否對準指定 SRL 過程,再由 Judge 做品質排序,最後保留拒絕或送人工審核的出口。提示應明確寫出任務、學生狀態、可支援的過程及不可違反的格式;比較時應交換候選順序、控制字數、記錄 API 時序並避免讓生成器評審自己的作品。對教育機構而言,這能降低教師逐段檢查的負荷,但不能把 70% 的幻覺辨識率當成足以獨立放行的安全保證。
10. 研究限制
研究只使用兩所學校、66 名澳洲英語母語中學生,外部效度有限;鷹架是依離線軌跡模擬產生,沒有在真實課堂中測試是否改善學習成果、接受度、延遲或成本。人類標註者數量與機構來源也有限,尚未納入學生與教師的實際偏好。Judge 採一般品質提示,未充分為 SRL、個人化與教學清晰度設計專用規準。研究依賴 GPT-4 等專有 API,涉及學生資料隱私、可近用性與長期服務依賴。另需注意,本文 PDF 是 arXiv v2 預印本排版,但 DOI 已由 Crossref 登錄為 2026 年 Elsevier 期刊論文;本輪未逐項核驗期刊索引排名。
11. 對我研究的啟發
本文最可重用的角度,是把「人—GenAI 協作」的研究單位從一次互動回答改成一個可審計的協作迴路:人的任務狀態/行為軌跡 → AI 產生候選 → 另一個 AI 或規則檢查對準性 → 人決定採用。這可直接轉接到 AI × 認知風格、知識創造與創新機制研究:認知風格或知識尋求傾向可被視為協作條件,GenAI 個人化則是生成層,可靠性檢查與人類判斷是治理層,最後再觀察新穎性、實用性或知識整合品質。若延伸到觀光、旅宿或服務設計,客服機器人也不應只以「回答正確」評估,而可檢查它是否對準旅客當下的決策階段、資訊需求與體驗目標;這提供一個把服務互動品質與 AI 評估偏誤接起來的實證框架。
12. 整體評價
值得收進核心文獻,最適合當作 AI 教育可靠性與人機協作治理的 empirical support / methods reference,也可作為設計「生成—驗證—人工介入」架構的 framing paper。它的強項是把多代理優勢、LLM Judge 的實際辨識能力與四類偏誤放在同一實驗中比較,且指標與提示框架相對可重用;最重要的警示則是,較強模型也只達中度品質一致性,生成內容的無關率仍高,評審器還可能偏愛自己。本文不是證明 GenAI 鷹架已能安全自動化,而是證明可靠部署必須把驗證與去偏設計成系統的一部分。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。