文獻筆記・
用 AI 幫忙除錯,學生的批判思考會變差嗎
第一,系統化整合 LLAMA 是否影響 CS1 學生在除錯任務中的批判思考能力?第二,學生如何看待 LLAMA 作為除錯助手對其理解、問題解決與批判思考的影響?作者的核心缺口是:既有研究多看短期表…
- 論文
- Evaluating the Effect of Generative AI-Assisted Debugging on Students’ Critical Thinking
- 作者
- Yazid Albadarin, Mohammed Saqr, Nicolas Pope, Markku Tukiainen(2026)
- 期刊
- Technology, Knowledge and Learning
- DOI
- 10.1007/s10758-026-09998-z
- 分類
- 教育
1. 基本資訊
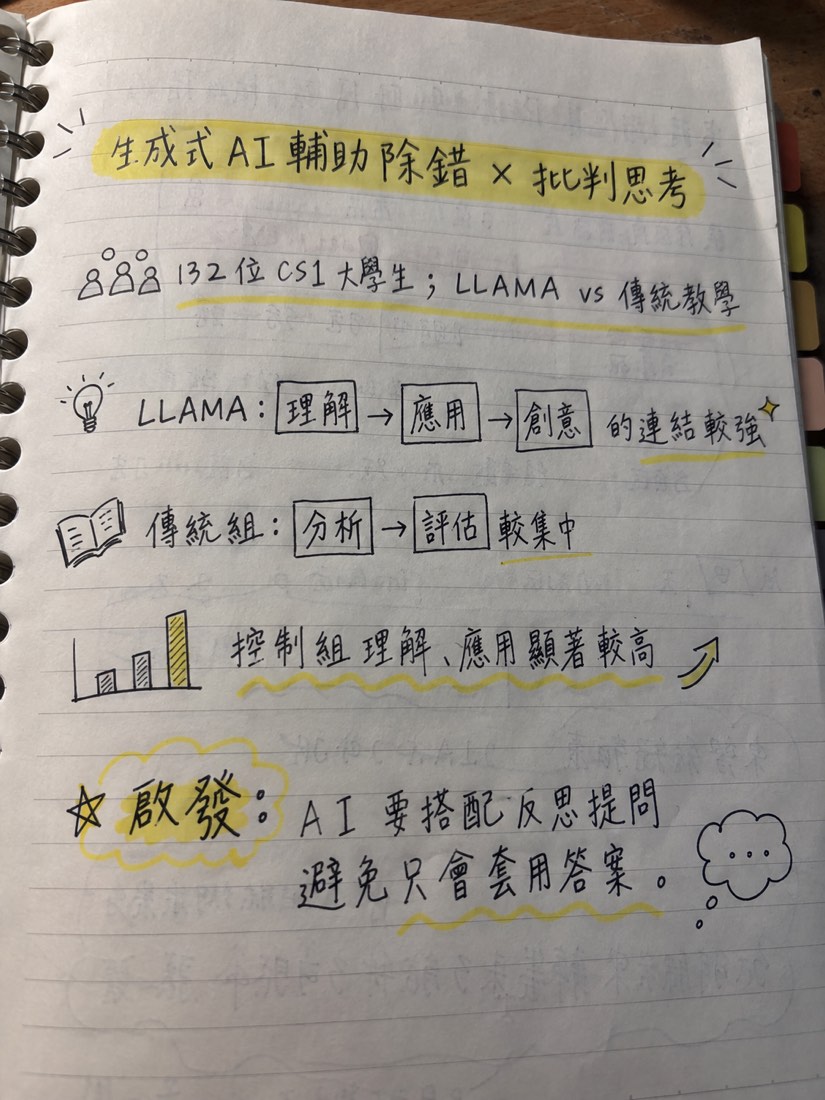
本文研究 Java CS1 課程中,結構化的生成式 AI 輔助除錯是否改變學生的批判思考。研究以開源 LLAMA 3.1(8B)作為除錯支援,將 132 位一年級學生依課程班級分成實驗組 68 人與控制組 64 人,歷時六週。研究不是只比較「有沒有寫對程式」,而是把批判思考拆成理解(Comprehension)、應用(Application)、分析(Analysis)、評估(Evaluation)與創意(Creativity),並檢視這些能力之間的條件關聯。
2. 研究問題
第一,系統化整合 LLAMA 是否影響 CS1 學生在除錯任務中的批判思考能力?第二,學生如何看待 LLAMA 作為除錯助手對其理解、問題解決與批判思考的影響?作者的核心缺口是:既有研究多看短期表現或參與度,較少觀察 GenAI 如何改變思考能力彼此連結的結構。
3. 理論基礎
研究以 Bloom 認知分類與 Facione 的批判思考觀點為基礎,將除錯視為結合認知技能與反思傾向的活動。作者排除「記憶」,保留理解、應用、分析、評估、創意五項,並把它們轉成可觀察的除錯行為。這是一個實用的操作化架構,但不是完整的批判思考理論:後續反思調節、認識論判斷與理由辯護並未直接測量。
4. 研究架構
研究採準實驗設計。控制組接受教師引導的傳統除錯;實驗組先學習 LLAMA,再依「理解—辨識—修正—評估—創造」五步驟使用工具。兩組都完成語法、邏輯與執行期錯誤的作業、閉卷後測與獨立程式撰寫;實驗組另填寫 LLAMA 使用感受問卷。結果同時以個別技能分數、技能網絡的正則化偏相關、置換檢定與中心性分析呈現。
5. 假設邏輯
本文沒有明列傳統 H1/H2 假設,而是以兩個研究問題與探索性比較為主。其論證邏輯是:GenAI 若能提供即時解釋、替代方案與回饋,可能把理解連到應用,甚至促進創意;但若學生把工具當成答案機器,也可能跳過分析、評估與獨立推理。因此,工具效果預期取決於任務是否要求反思,以及教師是否提供足夠的教學鷹架。
6. 方法
132 位學生來自六個班級,由同一位教師、同一課綱與教材授課;三班為實驗組、三班為控制組。前測顯示兩組在程式與除錯自評、GenAI 熟悉度及先前使用比例沒有顯著差異。學生完成三類除錯作業、100 題閉卷測驗與獨立寫程式任務;評分規準以五點量尺對應五項技能。研究使用 Welch t 檢定並以 Holm 校正個別技能比較;技能關聯採 EBICglasso 網絡、1000 次置換檢定及 Benjamini–Hochberg FDR 校正。設計的優點是同時看「能力大小」與「能力如何連在一起」,但班級分派而非個人隨機分派,因果推論仍需保守。
7. 結果
控制組在理解(M=77.28 vs. 71.32)與應用(M=78.34 vs. 71.35)顯著高於 LLAMA 組,兩項 Holm-adjusted p=0.005、效果量 d=0.68。分析、評估與創意的個別分數則無顯著差異。網絡上,LLAMA 組的理解—應用關聯為 .56、應用—創意為 .47;控制組的理解—應用為 .36、分析—評估為 .41。應用—創意的組間差異經 FDR 校正後仍顯著(p=.018)。控制組的中心性較由評估驅動(.875),LLAMA 組則由應用驅動(1.613),且評估呈負向中心性(-.948)。實驗組問卷中,74% 認為有助理解,76% 認為更有系統解題,80% 認為 AI 解答使用前應先評估;但 38% 強烈同意過度使用可能削弱演算法思考。
8. 理論貢獻
本文把 GenAI 學習效果從單一成績差異推進到「認知技能網絡」層次:同樣的創意分數,可能由不同的思考路徑產生。LLAMA 似乎強化「理解—應用—延伸」的連結,卻未同步強化分析與評估,說明 AI 的認知作用不是簡單的增益或損害,而是重新配置能力間的耦合方式。這也把 cognitive offloading 與 cognitive scaffolding 放進同一個可檢驗的教學脈絡。
9. 實務意涵
教師不宜把 GenAI 直接當作答案供應器。較可行的設計是先讓學生獨立提出診斷,再使用 AI 比較、質疑與修正;每次 AI 建議後要求回答「為什麼這個修正正確?」「還有什麼替代方案?」「在另一種錯誤情境是否仍成立?」。課程可交替安排手動除錯與 AI 輔助除錯,以保留基礎理解與應用能力,再利用 AI 擴展方案與回饋。評量也應加入口頭解釋、除錯歷程與理由辯護,而不是只評最後程式是否能跑。
10. 研究限制
閉卷選擇題難以完整捕捉開放式、真實情境中的批判思考;感知問卷只由實驗組填寫,無法與控制組直接比較。創意雖有程式碼例子補充,仍缺少學生逐步口述思考歷程。研究沒有直接測量後設認知調節或認識論判斷,因而不能把「評估」分數等同完整反思能力。最後,樣本來自單一課程、單一教育情境、初學者與 Java,且班級分派可能帶來選擇與教師情境混淆,外推到其他學科、語言或高階學習者需謹慎。
11. 對我研究的啟發
對 AI × 知識創造與 Human–GenAI collaboration 研究而言,最可重用的角度不是問「AI 是否提升創意」,而是追問 AI 如何改變理解、應用、分析、評估與創意之間的流程連結。可把「應用—創意」與「分析—評估」視為兩條不同的知識創造路徑,進一步研究認知風格、AI 素養或任務結構是否決定我停留在套用答案,或能把 AI 輸出轉化為可辯護的新知。研究設計上,可把 AI 互動紀錄、反思提問與最終成果結合,避免只用成果分數推論協作品質。
12. 整體評價
值得收進 AI 輔助學習、Human–GenAI collaboration 與認知機制的核心文獻,較適合當作 empirical support 與研究設計參考,不宜單獨作為完整理論 framing paper。它最有價值的證據是:LLAMA 組的技能關聯改變,不等於個別技能變好;控制組在理解與應用反而較強。主要疑點是準實驗、單一課程、結果導向測量與未直接觀察思考過程,因此結論應表述為「在本研究條件下的關聯與模式」,而非 GenAI 必然造成認知退化。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。