文獻筆記・
哪個模型最能解釋 AI 理財機器人的採用
研究問的是:TPB、UTAUT-2 與自我效能價值採用模型(SVAM)哪一套較能解釋 AI 財務 robo-advisor 的採用意圖與使用行為?不同程度的人類介入——全自動與混合式 robo-a…
- 論文
- Assessing the utility of advanced adoption models for AI-based financial services: insights into automated and hybrid robo-advisors
- 作者
- Balraj Verma, Laxmi Remer, Divya Goswami, Somesh Kumar Sinha(2026)
- 期刊
- Frontiers in Artificial Intelligence, 9, 1854196
- DOI
- 10.3389/frai.2026.1854196
- 分類
- AI 應用
1. 基本資訊
Verma, B., Remer, L., Goswami, D., & Sinha, S. K. (2026). Assessing the utility of advanced adoption models for AI-based financial services: insights into automated and hybrid robo-advisors. Frontiers in Artificial Intelligence, 9, 1854196. DOI: 10.3389/frai.2026.1854196。文章為開放取用原創研究;正式期刊、卷期、DOI 與全文可確認,最新 SSCI/SCI/Scopus 索引與排名未明確確認。
2. 研究問題
研究問的是:TPB、UTAUT-2 與自我效能價值採用模型(SVAM)哪一套較能解釋 AI 財務 robo-advisor 的採用意圖與使用行為?不同程度的人類介入——全自動與混合式 robo-advisor——是否會改變採用機制?這個問題重要,因為 robo-advisor 不只是被動工具,而是逐漸參與、甚至代替使用者做決策的演算法行動者。
3. 理論基礎
文章比較三種互補取向:TPB 強調態度、主觀規範與知覺行為控制;UTAUT-2 強調績效期待、努力期待、社會影響、促成條件、享樂動機、價格價值與習慣;SVAM 則補進知覺價值、費用與自我效能。作者的核心判讀是,AI 採用不宜只被當作一般科技「好不好用」的問題;當使用者要把部分決策權交給 AI 時,個人能否理解、評估並駕馭系統,以及系統是否創造足夠價值,會變得更關鍵。
4. 研究架構
研究分三階段:先比較 TPB、UTAUT-2、SVAM 的解釋力與預測力;再以 53 個量測題項進行探索性因素分析,整合概念相近的構念;最後以多群組分析比較全自動與混合式服務。整合模型包含態度、努力期待、享樂自動化、規範控制知覺、績效期待、知覺價值、自我效能、採用意圖與使用行為。其基本路徑是「多重心理/科技評估 → 行為意圖 → 使用行為」,並把 robo-advisor 類型視為重要邊界條件。
5. 假設邏輯
這篇採實證模型比較與路徑檢驗,不是逐條列出傳統假設清單。其命題邏輯是:態度、價值、期待、自我效能、規範控制與習慣性使用都會正向推動採用意圖,而採用意圖會轉化為實際使用;全自動情境因缺少人類補位,應更依賴使用者自我效能,混合式情境則較依賴態度、易用/努力與績效評估。這也把「自動化程度」從背景描述提升為理論上的調節條件。
6. 方法
研究採量化、橫斷面設計,以印度 397 名投資者的有效問卷分析(422 人同意參與,剔除不完整與不一致回覆後保留 397 份)。樣本以 purposive sampling 取得,包含混合式 robo-advisor 使用者 201 人(50.63%)與全自動使用者 196 人(49.37%)。量表改編自 TPB、UTAUT-2、SVAM,使用五點 Likert 量尺;分析包含 PLS-SEM、探索性因素分析、模型解釋/預測力比較、整合模型與多群組分析。作者也檢查非回覆偏誤、Harman 單因子與全共線性,並報告各構念具有可接受信度與收斂效度。
7. 結果
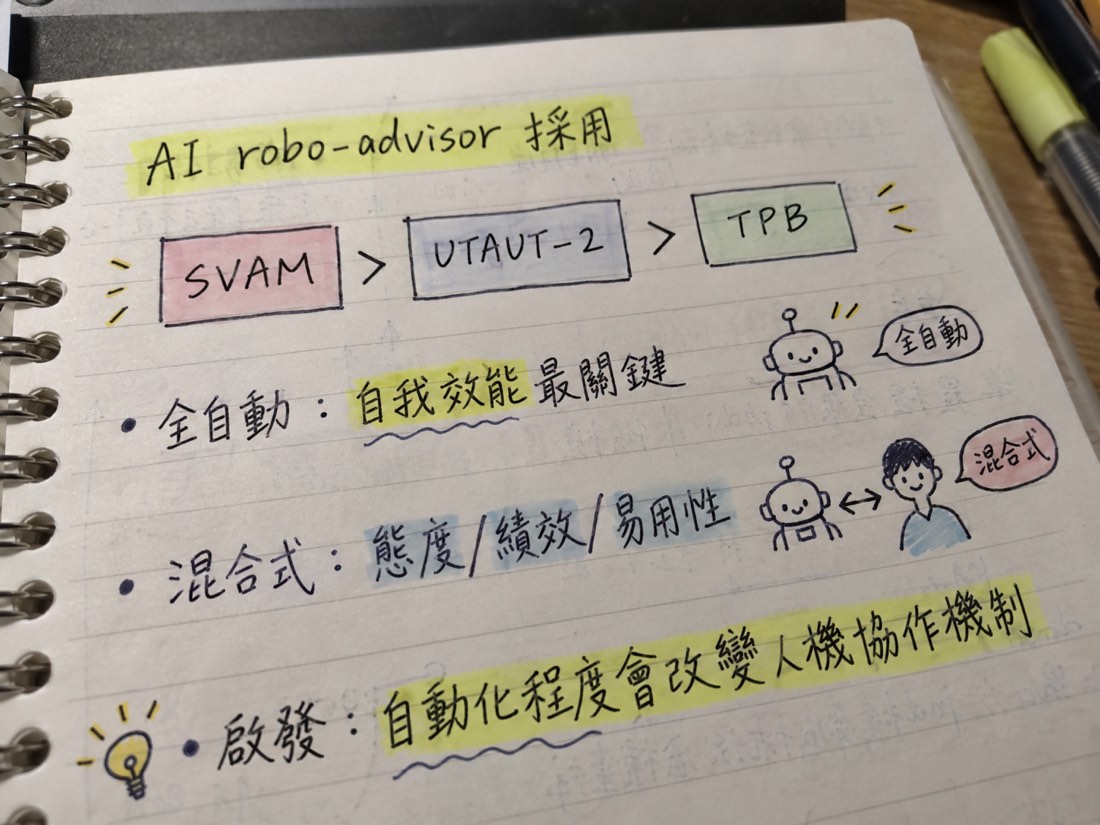
SVAM 的解釋力最高(調整後 R² = .734),優於 UTAUT-2(.708)與 TPB(.582);三者皆有高預測相關性,SVAM 的 Q² = .641 也高於 UTAUT-2 的 .635 與 TPB 的 .576。整合模型的解釋力進一步達 R² = .828、Q² = .821。整合模型中,態度(β = .249)、享樂自動化(β = .240)、知覺價值(β = .224)、績效期待(β = .188)與自我效能(β = .167)是較重要的採用意圖前因;採用意圖對使用行為的路徑很強(β = .655)。
多群組結果顯示,全自動服務的自我效能效果非常強(β = .663),混合式則不顯著(β = −.013);反過來,混合式的態度(β = .282)、努力期待(β = .125)與績效期待(β = .236)效果顯著較強。知覺價值、享樂自動化、規範控制與意圖到使用的路徑,在兩類服務間沒有顯著差異。換言之,人類介入程度會重新配置「誰需要更有能力」與「什麼評估最重要」,但不會改變所有採用機制。
8. 理論貢獻
第一,文章以同一情境直接比較多套採用理論,降低不同研究各自套用單一模型造成的碎片化。第二,SVAM 的優勢指出 AI 決策服務的採用,應同時納入價值創造與使用者能力,而不能只沿用效用/易用性框架。第三,整合模型把傳統採用研究推向「AI 介入決策」情境,提醒後續理論處理委派、自主性、控制感與演算法依賴。第四,全自動/混合式的差異證明自動化程度不是產品描述而已,而是會改變採用前因權重的邊界條件。
9. 實務意涵
全自動 robo-advisor 應投資於導覽、情境演練、AI 素養與可理解的推薦解釋,提升使用者理解與評估系統的自我效能;混合式服務則應把 AI 的分析效率與人類專業、信任和互動支援結合。產品設計不宜只增加功能,而要讓使用者理解推薦如何形成、能控制解釋深度,並透過個人化、進度追蹤與順暢操作建立可持續使用習慣。治理上則需重視透明、問責、投資者保護與演算法揭露。
10. 研究限制
橫斷面資料不能支持因果推論,也無法呈現使用者從採用前、初次使用到長期依賴的變化;自陳量測可能有知覺扭曲與共同方法偏誤。印度 purposive sample、且受試者偏向對 FinTech 有接觸者,限制跨國與一般人口的外部效度。理論比較也只涵蓋三套模型,未納入創新抗拒、擴散理論等視角。最後,研究聚焦 robo-advisor,不能直接推廣到教育、醫療、客服或生成式 AI 平台。
11. 對我研究的啟發
這篇最可重用的角度,是把「人類—AI 協作」具體化為自主性配置不同,能力與信任機制也不同。若延伸到旅遊/旅宿服務,可將全自動旅遊推薦、半自動客服或人機共創服務視為不同協作配置,不把 AI 採用當成單一同質結果。研究設計上可比較「AI 單獨建議」與「AI+員工/導遊補位」兩種情境,檢驗 AI 素養/自我效能、知覺價值、解釋透明度與控制感如何影響採用、信任、體驗與後續共創。對知識創造研究而言,文章也提示:不能只測 AI 使用頻率,應測我是否有能力理解、質疑與重新組合 AI 輸出;否則高採用可能只是委派決策,不等於高品質的人機共同創造。
12. 整體評價
值得收進「AI 採用、服務自動化與人機協作」核心文獻,尤其適合當作 empirical support 與模型比較參考;若研究要建立人機協作的 framing,則可搭配更直接處理信任、代理性或知識創造的理論文章。其優點是把 competing models 放進同一資料集比較,並提出清楚的自動化程度邊界條件;主要疑點是單一國家、非機率樣本與橫斷面自陳資料,使結果較像理論整合的初步證據,不能直接宣稱跨情境因果。期刊品質/索引與排名未明確確認,但正式發表資訊、DOI、開放全文與研究方法均可核對。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。