文獻筆記・
用網友評論估算消費者心智指標
論文追問:使用者生成內容(UGC)能否用來近似傳統問卷所測量的消費者心智指標(consumer mindset metrics, CMMs),以及研究者要如何把大量、非結構化且帶有情境脈絡的 UG…
- 論文
- Mining Consumer Mindset Metrics With User-Generated Content
- 作者
- Raoul V. Kübler, Susanne J. Adler, Lina Welke, Marko Sarstedt, Koen Pauwels(2025)
- 期刊
- Schmalenbach Journal of Business Research, 77(3), 497-525
- DOI
- 10.1007/s41471-025-00219-4
- 分類
- 行銷
2. 研究問題
論文追問:使用者生成內容(UGC)能否用來近似傳統問卷所測量的消費者心智指標(consumer mindset metrics, CMMs),以及研究者要如何把大量、非結構化且帶有情境脈絡的 UGC,轉成具有建構效度與管理價值的指標?作者關心的不是「能不能把文字分類」,而是 UGC 是否真正涵蓋品牌知名度、考慮、購買意圖、滿意度、推薦與品牌權益等潛在構念。
3. 理論基礎
核心基礎是消費者態度與行銷漏斗觀點:消費者的認知、情感與行動傾向,是解釋可觀察行為的 why,而非僅是點擊或銷售等結果。論文同時借用心理計量的建構效度、收斂效度與預測效度,主張 UGC 指標不能只追求預測準確率,還必須回到既有構念定義,說明資料到底代表構念的哪一部分。方法上則整合文字探勘、情緒分析、主題模型、詞向量、ABSA、電腦視覺與多模態機器學習。
4. 研究架構
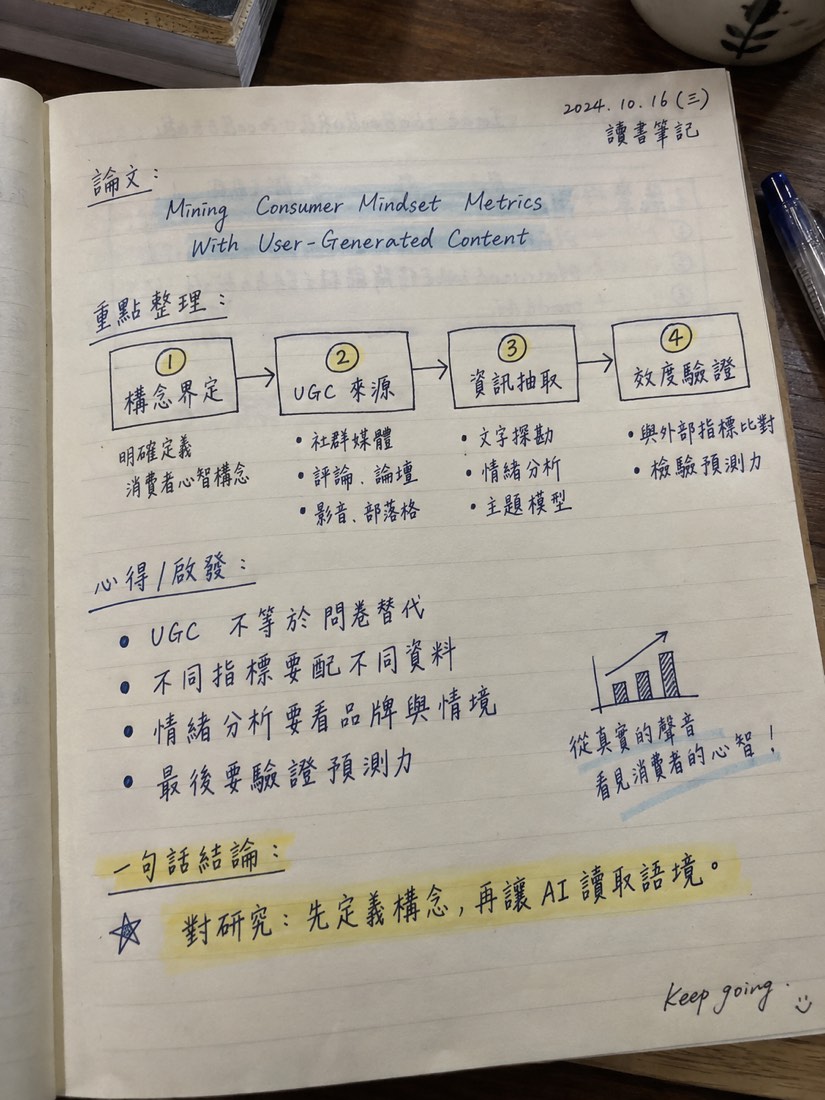
作者提出「UGC 心智指標測量」四步驟:(1)界定構念與關鍵面向:從已驗證量表與理論定義拆解 CMM;(2)選擇資料來源:依構念挑選社群媒體、評論、電商、搜尋紀錄、部落格、論壇、串流或 podcast;(3)抽取資訊並轉換成指標:依文字、影像、影片及結構化程度選擇適當工具;(4)驗證品質:檢查內容涵蓋、收斂/區辨效度與對下游結果的預測力。這是一個從構念到資料、方法再回到效度的閉環,而不是把單一 sentiment score 當作萬用 CMM。
5. 假設邏輯
本文是概念框架與研究議程,沒有硬編統計假設。其論證邏輯是:若先用理論量表界定 CMM 的面向,再選擇能觀察該面向的 UGC,並使用與資料型態匹配的抽取方法,最後以問卷或實際績效進行效度驗證,UGC 才可能成為可追蹤的心智指標。不同 CMM 位於決策漏斗的不同階段,應有不同資料與方法:知名度可由提及量或曝光代理,考慮集合需要比較脈絡,購買意圖需要未來導向語言,滿意度與推薦則需要情緒、理由與倡議內容。
6. 方法
研究採概念整合與方法論論證,系統整理 CMM、UGC、消費者研究與機器學習文獻,並以表格對照六類主要指標、資料來源及抽取工具。作者區分結構化資料(觀看、分享、評分、提及量)與非結構化資料(評論、貼文、影像、逐字稿),再提出從字典/計數、主題模型與 BERTopic,到情緒分析、ABSA、詞向量、物件辨識與影片分析的工具選擇原則。驗證上建議以問卷 CMM 做收斂效度,或在缺乏問卷時,以決策漏斗下游指標、潛在客戶、購買及回購檢查預測效度。
7. 結果
本文沒有傳統的係數、顯著性或單一樣本結果;主要產出是可操作的框架與方法對照。最重要的結論包括:第一,單純量化 UGC 數量通常只適合知名度等較粗粒度指標;第二,考慮、購買意圖、滿意度與推薦必須讀取品牌、競品、情緒與行動脈絡;第三,不同平台對不同 CMM 的適配度不同,評論/電商較適合滿意度與購買相關指標,搜尋較適合考慮與意圖,podcast 逐字稿則有豐富語境但較難支援知名度;第四,UGC 指標最終仍須以構念效度與可預測的商業結果驗證。
8. 理論貢獻
論文把「消費者心智」從問卷專屬的潛在變項,重新界定為可由多源行為與語言痕跡近似、但必須經效度檢驗的測量對象。其關鍵貢獻不是宣稱 UGC 取代問卷,而是建立兩者的橋接語言:量表項目先提供構念邊界,機器學習負責從資料辨識面向,心理計量再判斷測量是否站得住腳。這也把行銷 AI 研究從「模型準確率」推向「理論—測量—決策」的整合。
9. 實務意涵
企業可用 UGC 建立接近即時的品牌健康儀表板,但應按決策漏斗設計指標,而非只追蹤正負評。實務流程可以是:先把品牌知名度、考慮、意圖、滿意度與推薦拆成可觀察面向,再選擇評論、搜尋、社群或影音資料,最後用小規模問卷、客服紀錄、訂單、回購或活動前後變化校準。對 AI 服務、旅宿評論或目的地體驗而言,ABSA 與情境化情緒分析尤其重要,因為同一個「好」可能指向價格、服務、人員、房間或體驗,而不是整體滿意度。
10. 研究限制
第一,本文是概念與研究議程,沒有提供一個完整實證案例來證明四步驟在不同產業均有效。第二,UGC 並非自然代表性樣本:發文者、平台使用者、語言、演算法曝光與沉默的大多數都可能造成選擇偏誤。第三,內容可能是操弄、灌水、機器生成或受平台政策影響,且同一使用者的多筆內容不一定獨立。第四,情緒、反諷、否定、跨語言與多模態脈絡會使分類器失真。第五,從關聯性的 UGC 指標推論漏斗中的因果移動仍需縱貫、實驗或準實驗設計;隱私、平台 API 限制與資料合法性也不能被技術便利掩蓋。
11. 對我研究的啟發
這篇最適合轉成我的 AI × 消費者/旅遊體驗研究的測量設計原則:不要把「AI 生成內容的情緒分數」直接當成體驗結果,而要先界定體驗構念的面向,例如信任、擬人化、感知有用性、情緒價值、服務公平與推薦意願,再以評論或社群 UGC 的品牌/目的地提及、比較語句、具體服務面向與情緒脈絡建立可重複指標。若研究 Human–GenAI collaboration,可把人機互動紀錄與我敘事結合,檢驗 AI 語言風格或任務分工如何改變「感知品質 → 信任/滿意 → 推薦」鏈結;並以問卷量表與實際行為作三角驗證。這能避免只依賴單次實驗或自陳意向,也能把 AI 介入後的微觀語言線索連到旅宿、服務設計與品牌結果。
12. 整體評價
**值得收進核心文獻,但定位應是 measurement framing paper 與方法設計參考,不是 empirical support。**它清楚提出從理論構念、資料來源、抽取工具到效度驗證的完整思路,對 AI 消費者研究、UGC、旅遊評論與品牌體驗都很可重用。其明顯限制是尚未以一個嚴格、可重複的實證研究比較不同模型與資料源,也沒有解決 UGC 樣本偏誤、跨文化語義與因果識別。因此後續引用時應把它用來支撐「如何建構與驗證 UGC 心智指標」的 framing,並另配實證論文支撐具體模型效果。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。