文獻筆記・
組織如何用生成式 AI 創新
這篇不是用問卷檢驗因果假設的實證研究,而是處理一個管理上很實際的問題:組織面對 ChatGPT 與其他生成式 AI 時,如何判斷應該把 AI 用來做流程自動化、人的能力增強,或兩者同時推進?作者認…
- 論文
- How organizations can innovate with generative AI
- 作者
- Jonny Holmström, Noel Carroll(2025)
- 期刊
- Business Horizons, 68(5), 559-573
- DOI
- 10.1016/j.bushor.2024.02.010
- 分類
- 管理
2. 研究問題
這篇不是用問卷檢驗因果假設的實證研究,而是處理一個管理上很實際的問題:組織面對 ChatGPT 與其他生成式 AI 時,如何判斷應該把 AI 用來做流程自動化、人的能力增強,或兩者同時推進?作者認為,單純把「導入 AI」視為一個二元決策,無法說明不同部署方式的創新價值、風險與管理要求,因此提出一套可供策略選擇的類型學。
3. 理論基礎
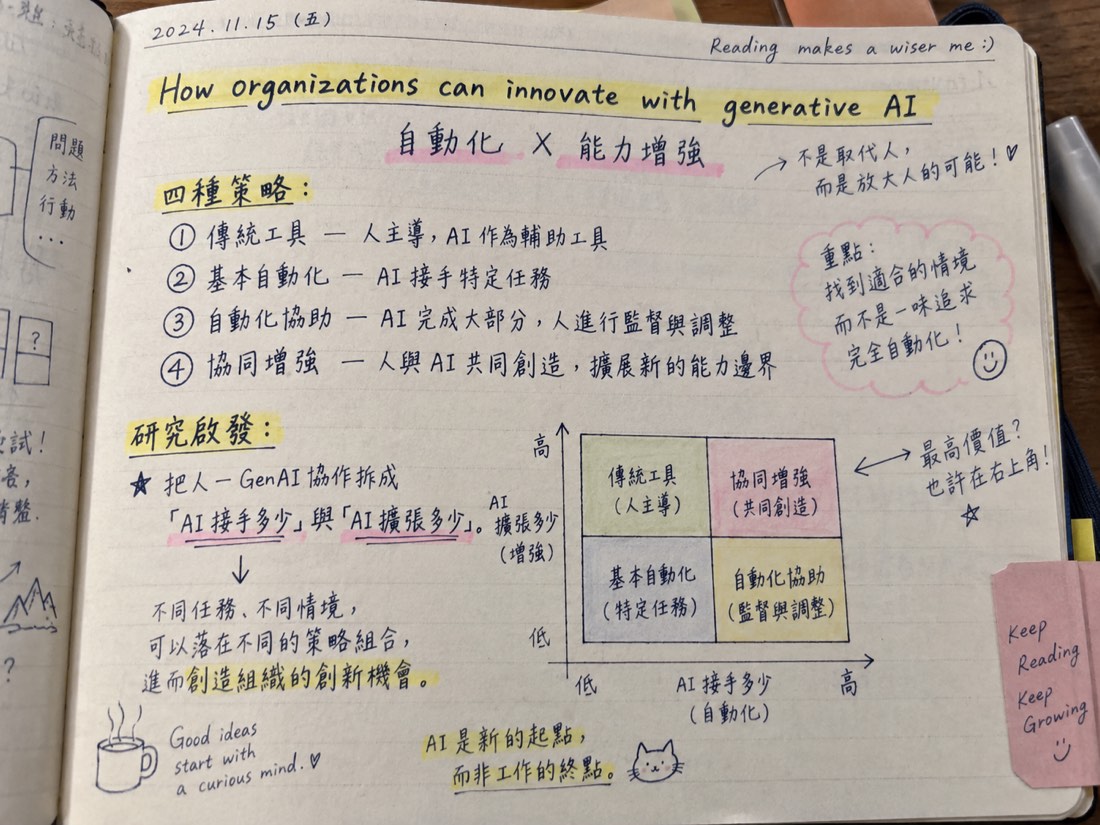
核心概念是 automation(自動化) 與 augmentation(增強)。前者指 AI 是否直接接手、加速或規模化原本由人完成的工作;後者指 AI 是否擴張人的創造、分析、問題解決與決策能力。作者把兩個維度各分成高/低,形成四種生成式 AI 創新策略。這是一種概念整合與管理分類框架,並非宣稱四類是互斥且固定的組織狀態;同一組織可能在不同任務、流程或成熟階段移動於不同象限。
4. 研究架構
框架可濃縮為:生成式 AI 的自動化程度 × 人類能力增強程度 → 創新策略與管理作法。四類為:
- Traditional Tool(低自動化、低增強):AI 僅作為文字編輯、筆記或基本問答工具。
- Basic Automation(高自動化、低增強):重點是例行流程、客服、報告、資料蒐集與工作流的效率化。
- Automated Assistance(低自動化、高增強):AI 像創新夥伴,支援人的構想、分析與協作,但不大量自主執行。
- Assisted Augmentation(高自動化、高增強):AI 同時深度參與流程執行與複雜創意/決策,形成更高階的人機混合創新。
5. 假設邏輯/論證邏輯
作為概念型論文,作者沒有硬編統計假設,而是提出一組策略論證:若組織只追求效率,容易落入高自動化、低增強的 Basic Automation;若只把 AI 當作腦力激盪輔具,則偏向低自動化、高增強的 Automated Assistance。真正的策略選擇應取決於任務是否需要創意、流程是否適合標準化、資料是否可靠,以及組織是否具備監督與治理能力。高高象限的 Assisted Augmentation 潛力最大,但也要求最嚴格的驗證、責任分工與人類監督,不能把「更自主」誤當成「更有創新」。
6. 方法
本文採概念建構與管理案例式說明,透過既有 AI、數位創新、自動化與增強研究,搭配 ChatGPT 在問題解決、市場研究、內容生成、決策支援、原型與設計等場景的應用,建立四象限類型學。文中以多個部門情境(如客服、CRM、報告、庫存、創意構想與原型)說明每一類策略,並列出相應的管理問題。它不是系統性文獻回顧,也沒有樣本、量表、實驗或模型估計。
7. 結果/主要命題
主要產出是四類策略及其管理對應。低低象限保留最大的人類判斷,但 AI 價值有限;高低象限可以降低成本、加快例行工作,卻未必提升突破式創新;低高象限適合共同構思、分析與設計,能提高人的想法廣度與深度;高高象限能讓 AI 同時產生方案、執行部分流程並增強人的思考,但也放大幻覺、錯誤自動化、偏誤、責任歸屬與技能流失風險。作者因此建議管理者先定義創新目標,再決定自動化與增強的組合,而非從工具功能反推策略。
8. 理論貢獻
第一,它把常被混用的「AI 自動化」與「AI 輔助/增強」拆成兩個可比較維度,讓生成式 AI 創新不再只用採用/不採用描述。第二,它指出生成式 AI 的創新價值具有矛盾性:組織同時需要穩定、準確、可控,也需要快速試錯、探索與更新。第三,四象限提供了後續實證研究的操作化起點:可將任務層級的 automation 與 augmentation 測量化,再檢驗它們對創意新穎性、實用性、效率、學習或組織績效的非線性與交互作用。
9. 實務意涵
組織導入 GenAI 時,應先問「要改善哪一種創新結果」,再選工具與流程。客服 FAQ、標準報告與資料整理可先採 Basic Automation;需要洞察、構想與設計的工作,應明確設計人機共同產出、反駁與驗證迴圈。進入 Assisted Augmentation 前,必須建立資料來源管理、輸出驗證、權限、人工覆核、績效指標與責任邊界。管理者也應區分 AI 只是生成文字,還是已經能觸發外部行動;後者的治理門檻顯著更高。
10. 研究限制
文章的主要限制是概念性強、驗證性弱。四類策略的高低切點沒有明確量化標準,實際組織可能同時包含多個象限;文中案例多為示意,未證明哪一類在何種條件下必然帶來較佳創新績效。作者對 ChatGPT 能力與 prompt engineering 的描述也帶有早期生成式 AI 時代色彩,未充分處理模型版本、領域資料品質、幻覺率、隱私與跨文化差異。因此,不能把這個 typology 直接當作已驗證的績效模型。
11. 對我研究的啟發
這篇最值得轉化成研究設計的地方,是把「人—GenAI 協作」從單一使用強度改寫成兩條機制軸:AI 接手了多少工作,以及 AI 擴張了多少人的認知能力。若研究創意或知識創造,可進一步檢驗低自動化/高增強是否最有利於新穎性與知識整合,而高自動化/高增強是否提高產量卻帶來過度依賴與技能退化。也可把認知風格、AI literacy、knowledge seeking、任務不確定性與驗證能力放成調節條件,形成「任務情境 × 協作配置 × 創新結果」模型。對觀光與旅宿研究而言,這套框架可用來區分 AI 旅遊推薦、客服機器人、行程設計與目的地內容創作:同樣是 AI 應用,前者可能偏自動化,後者則更適合研究人機共同創造體驗價值。
12. 整體評價
值得收進核心文獻,但定位應是 framing paper/概念框架參考,不是 empirical support,也不是成熟的方法參考。它的優點是簡潔地捕捉 GenAI 創新中「效率」與「能力增強」的張力,能幫助後續研究避免把所有 AI 使用都歸為同一種處理。明顯疑點則包括四象限邊界未操作化、缺乏資料驗證,以及部分技術敘述可能受早期 ChatGPT 熱潮影響。使用時應把它當作理論透鏡,再搭配人機協作、創意歷程、AI 依賴與組織學習的實證研究。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。