文獻筆記・
短影音行銷:視角、內容與旁白如何影響旅遊意願
核心問題有三層。第一,視覺視角與視覺內容是否存在交互作用,而非某一種視角永遠較好?第二,這種匹配是否透過「想像流暢性」(容易在心中形成旅遊畫面)提升旅遊意圖?第三,理性與情緒旁白是否會進一步調節這…
- 論文
- Short video marketing and travel intentions: The interplay between visual perspective, visual content, and narration appeal
- 作者
- Jianhong Gan, Si Shi, Raffaele Filieri, Wilson K.S. Leung(2023)
- 期刊
- Tourism Management, 99, 104795
- DOI
- 10.1016/j.tourman.2023.104795
- 分類
- 觀光
1. 基本資訊
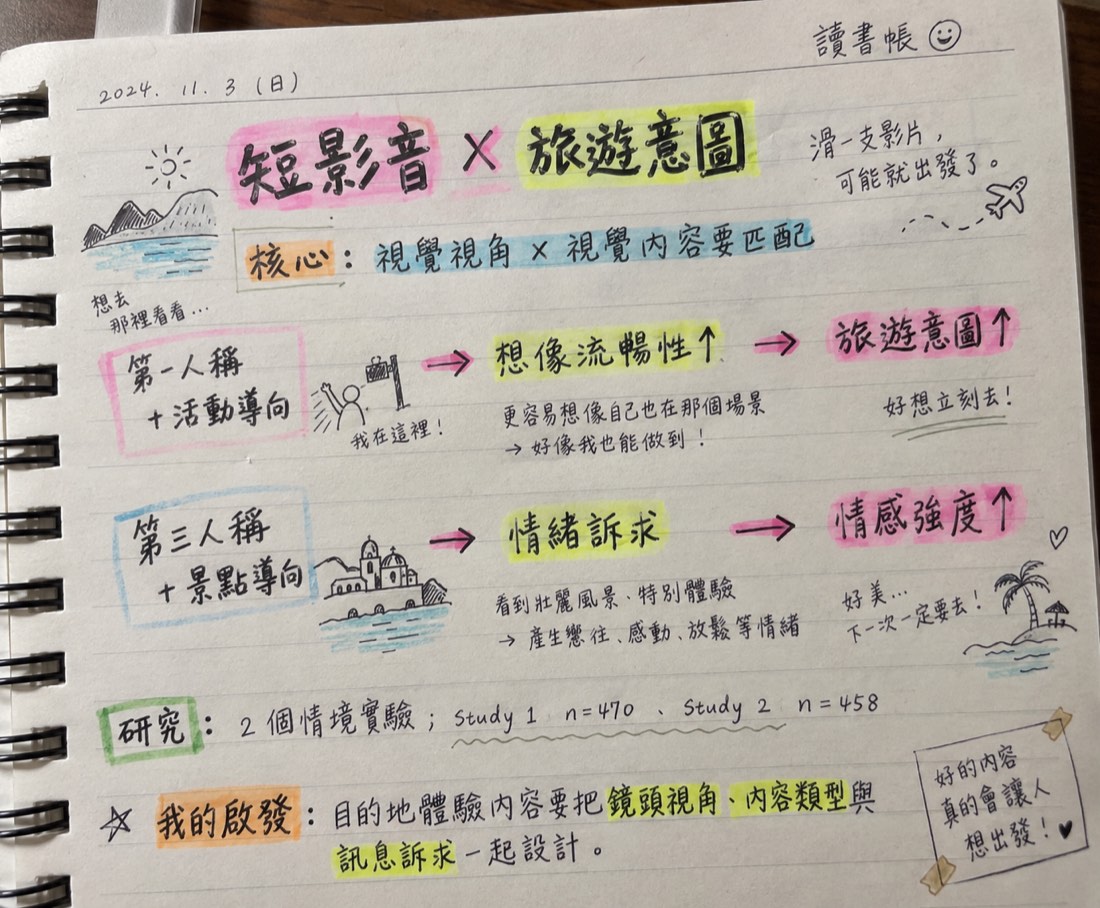
本文問的不是「短影音有沒有用」,而是短影音中的三種訊息元素如何搭配才有效:視覺視角(第一人稱/第三人稱)、視覺內容(活動導向/景點導向),以及旁白訴求(理性/情緒)。作者以建構層次理論(CLT)與精細化可能性模型(ELM)整合出一個「訊息一致性」觀點:第一人稱搭配活動導向,使旅客以較具體、接近自我經驗的方式處理;第三人稱搭配景點導向,則引導較抽象、象徵性與情緒性的處理。
2. 研究問題
核心問題有三層。第一,視覺視角與視覺內容是否存在交互作用,而非某一種視角永遠較好?第二,這種匹配是否透過「想像流暢性」(容易在心中形成旅遊畫面)提升旅遊意圖?第三,理性與情緒旁白是否會進一步調節這個效果,並分別透過回憶提取或情感強度發揮作用?這些問題把短影音從單一刺激效果,推進到多模態元素之間的組合效果。
3. 理論基礎
CLT 認為心理距離會影響人們採用具體或抽象的建構方式。第一人稱視角降低自我與目的地的心理距離,活動導向內容又提供身體行動與感官線索,因此偏向低層次建構;第三人稱與景點導向則拉開距離,較容易引發高層次、象徵與整體意義的處理。ELM 則區分中央路徑與周邊路徑:理性旁白需要較系統化的資訊分析,情緒旁白比較像啟發式線索。本文的理論亮點在於把「視覺建構層次」與「語言訊息處理路徑」放在同一個匹配框架中。
4. 研究架構
研究一以視覺視角 × 視覺內容的 2×2 實驗檢驗旅遊意圖,並以想像流暢性作為中介。研究二聚焦於兩種匹配組合:第一人稱+活動導向,以及第三人稱+景點導向,再加入理性/情緒旁白形成 2×2 設計;結果變項仍為旅遊意圖,機制則分別檢驗回憶與情感強度。控制變項包含旅遊頻率。整體可表示為:訊息元素匹配 → 建構層次/處理路徑一致 → 想像或情緒機制 → 旅遊意圖。
5. 假設邏輯
H1a/H1b 主張「第一人稱+活動導向」與「第三人稱+景點導向」各自比不匹配組合更能提高旅遊意圖。H2 主張視角與內容的一致性透過想像流暢性影響旅遊意圖。H3 主張旁白訴求會調節此一致性效果:活動導向的第一人稱畫面應搭配理性旁白,景點導向的第三人稱畫面應搭配情緒旁白。H4a/H4b 進一步預測理性條件經由回憶、情緒條件經由情感強度發生中介。值得注意的是,理論推演很完整,但 H4a 最後沒有獲得支持,顯示短影音的娛樂性可能讓受眾沒有足夠認知資源提取細節。
6. 方法
兩個研究都是隨機分派的情境實驗,使用虛構目的地以避免既有知識與熟悉度干擾。研究一以 52 秒短影音操弄第一/第三人稱與活動/景點導向,正式樣本 470 人;研究二正式樣本 458 人,加入理性/情緒旁白。兩個研究都先以 191 人進行操弄前測,並以 5 點量表測量各構念。研究一的想像流暢性 α=.81、旅遊意圖 α=.80;研究二的回憶 α=.68、情感強度 α=.83、旅遊意圖 α=.82。分析採 ANOVA 與 Hayes PROCESS、5,000 次 bootstrap;樣本來自 Credamo,主要為中國受試者與年輕短影音使用者。
7. 結果
研究一發現視角與內容有顯著交互作用(F(1,466)=20.13, p<.001)。活動導向內容下,第一人稱的旅遊意圖高於第三人稱(4.19 vs. 3.86);景點導向內容下,第三人稱高於第一人稱(4.01 vs. 3.74)。想像流暢性中介顯著,間接效果為 .08,95% CI [.04, .13]。研究二的旁白交互作用也顯著(F(1,454)=26.48, p<.001):第一人稱+活動導向時,理性旁白高於情緒旁白(4.15 vs. 3.82);第三人稱+景點導向時,情緒旁白高於理性旁白(4.05 vs. 3.68)。情緒旁白條件下,情感強度中介顯著(間接效果 .34,95% CI [.15, .53]);理性旁白條件下,回憶中介不顯著(間接效果 .02,95% CI [-.09, .14])。
8. 理論貢獻
第一,本文把 CLT 從文字框架延伸到短影音的視覺框架,說明第一/第三人稱不是脫離內容的普遍優劣,而是會受到活動/景點內容的邊界條件影響。第二,本文將 CLT 與 ELM 的匹配關係具體化:具體建構較適合系統化的功能資訊,抽象建構較適合情緒與象徵線索。第三,研究把想像流暢性由「內容本身造成」推進到「視角與內容匹配造成」,並辨識情感強度是景點型、情緒型短影音影響意圖的重要機制。這是一個可重用的多模態訊息設計模型。
9. 實務意涵
目的地行銷者不應只問「要不要用第一人稱」,而應先判斷要展示的是活動體驗還是景點意義。若展示滑水道、游泳、遊樂設施等活動,可用第一人稱、露出手腳或身體行動,並配合功能與實用資訊;若展示湖泊、建築、景觀與文化地標,可用第三人稱觀察視角,搭配故事、同理或情緒聲音。影像鏡頭、景深、色彩、版面、標籤與旁白應共同服務同一種心理建構,才能降低理解負擔並提高想像流暢性。對短影音 A/B test 而言,應測試「元素組合」而非單獨測試視角或文案。
10. 研究限制
第一,每支影片主要只使用一種視角,未處理第一人稱與第三人稱的混剪或切換效果。第二,只比較活動導向與景點導向,其他旅遊內容類型、橫/直式版面與不同旁白內容仍待研究。第三,研究聚焦主流目的地宣傳短影音,不能直接推論旅客 vlog、純風景片或使用者生成內容。第四,樣本來自單一地理脈絡,外部效度與跨文化穩定性仍有限。第五,結果變項主要是情境後的旅遊意圖,而非實際點擊、預約、到訪或長期目的地關係;此外,研究二回憶量表 α=.68,且理性旁白的回憶中介未支持原假設。
11. 對我研究的啟發
對我的觀光、旅宿與 AI × consumer experience 研究,最可重用的不是「短影音要用第一人稱」這個表層結論,而是「體驗設計的元素匹配」邏輯。未來若研究 AI 生成旅遊內容、AI 導覽或服務機器人採用,可以把內容表徵方式視為前因:AI 是在幫旅客預演具體活動、提供可操作的行程建議,還是在建構目的地的文化/情感意義?前者可測試第一人稱或沉浸式呈現、功能訊息與想像流暢性;後者可測試第三人稱、景觀/文化敘事與情感強度。這也能把「多模態 AI 內容品質」拆成可檢驗的視角—內容—旁白匹配,而不是只用整體有用性或滿意度概括。若延伸至人機協作,可再加入 AI 透明度、擬人化或我認知風格作為調節,檢驗不同旅客是否需要不同的體驗表徵與說服路徑。
12. 整體評價
這篇值得收進我的核心文獻,定位上最適合當作 tourism short-video / destination experience 的 empirical support,也可作為「多模態訊息匹配—心理機制—旅遊意圖」的 framing paper。它的優點是兩個隨機實驗、操弄前測清楚、交互作用與中介分析具體,且把視覺與旁白放在同一理論模型中;最有價值的可重用洞見是:內容不是單獨有效,內容與呈現方式要共同誘發一致的心理建構。不過,它仍是單一地理脈絡的線上情境實驗,樣本偏年輕,結果尚未證明能轉化為真實行為;理性旁白的回憶中介也未被支持,表示部分理論鏈需要更謹慎。期刊正式性與 DOI 可確認,但本輪最新索引/ranking 未明確確認。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。