文獻筆記・
你信任 ChatGPT 嗎:AI 倫理與品質問題如何影響旅遊決策
研究問四件事:第一,當 ChatGPT 的錯誤、低品質或不倫理形象被凸顯時,旅客是否降低接受與滿意度;第二,這些問題是否削弱推薦的知覺可信度;第三,可信度是否是風險影響行為反應的中介;第四,明確暴…
- 論文
- Do you trust ChatGPTs? Effects of the ethical and quality issues of generative AI on travel decisions
- 作者
- Jeong Hyun Kim, Jungkeun Kim, Changju Kim, Seongseop (Sam) Kim(2023)
- 期刊
- Journal of Travel & Tourism Marketing, 40(9), 779-801
- DOI
- 10.1080/10548408.2023.2293006
- 分類
- 觀光
1. 基本資訊
這是一篇以四個實驗檢驗 ChatGPT 旅遊推薦的實證研究。作者把「推薦品質」與「倫理疑慮」視為使用者評估生成式 AI 時不可分割的兩類風險,並追蹤它們如何透過知覺可信度影響接受、滿意度與旅遊意向。研究場景主要是目的地/景點推薦,受試者多為美國成人,實驗資料蒐集於 2023 年 ChatGPT 3.5 時期。
2. 研究問題
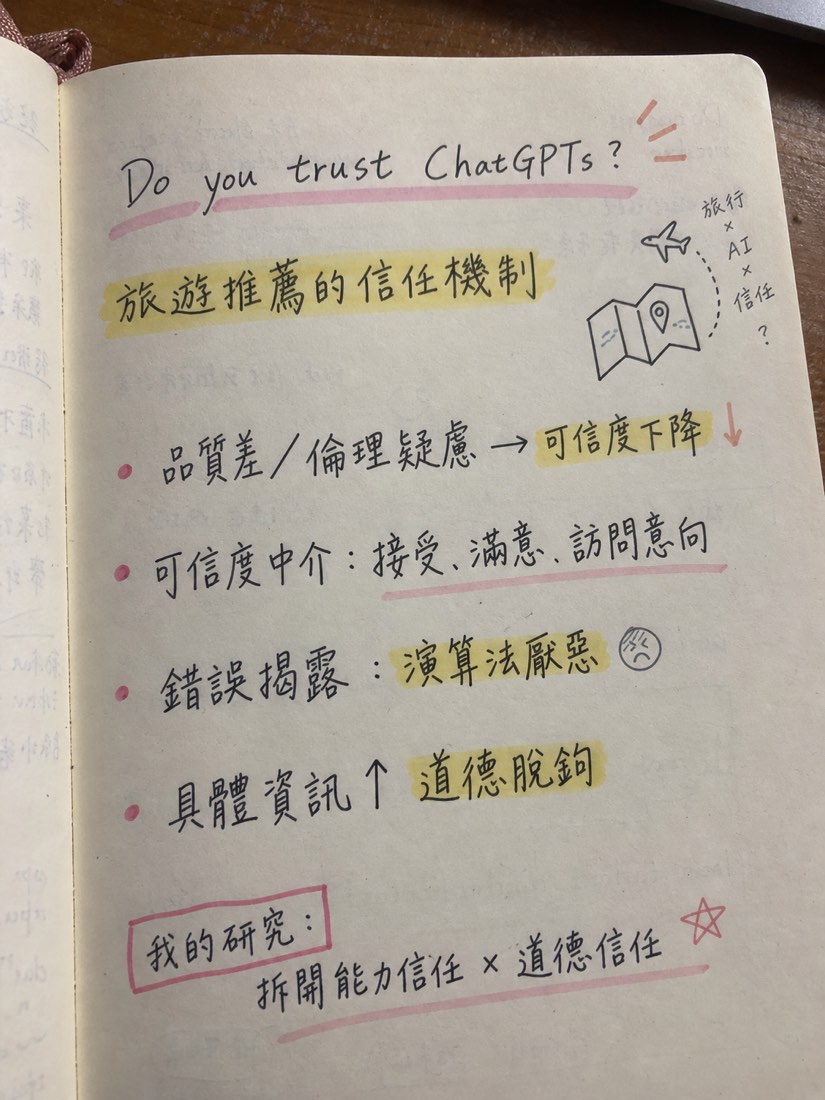
研究問四件事:第一,當 ChatGPT 的錯誤、低品質或不倫理形象被凸顯時,旅客是否降低接受與滿意度;第二,這些問題是否削弱推薦的知覺可信度;第三,可信度是否是風險影響行為反應的中介;第四,明確暴露 ChatGPT 的錯誤、資訊的具體程度,是否改變上述效果,以及使用者是否會出現道德脫鉤。
3. 理論基礎
核心理論組合包括資訊品質/可信度觀點、科技接受與信任研究、algorithm aversion,以及 moral decoupling。品質與倫理線索會改變使用者對資訊來源的價值判斷;知覺可信度則是由外部線索通往接受與滿意的心理橋樑。錯誤線索引入演算法厭惡邏輯,具體資訊與倫理負面性之間的差異則用道德脫鉤說明:人們可能在資訊很有用時,把對提供者的道德評價與對內容的功能評價分開。
4. 研究架構
整體模型是「品質/倫理問題顯著性 → 知覺可信度 → 推薦滿意度/接受/訪問意向」。Study 1、2 先以正面、品質負面、倫理負面訊息操弄問題顯著性;Study 3 再把 ChatGPT 是否明顯犯錯納入調節;Study 4 操弄資訊是具體景點推薦還是一般性資訊,檢驗道德脫鉤的邊界。換言之,研究不只問使用者喜不喜歡 AI,而是把前置訊息、系統表現和內容類型放進同一條決策鏈。
5. 假設邏輯
H1 預期品質或倫理問題顯著時,旅客的接受/滿意與訪問意向下降;H2 預期兩類問題都降低知覺可信度;H3 預期可信度中介問題顯著性對接受與滿意的負向效果。H4 原本預期錯誤會改變負面效果的強度,實際結果顯示錯誤暴露本身大幅壓低評價,且使正面訊息優勢消失。H5 則預測具體資訊提高道德脫鉤:使用者可能不喜歡 ChatGPT 的倫理面,卻仍認為詳細推薦有用。
6. 方法
四項 between-subjects 情境實驗以 Amazon MTurk 招募美國成人,研究均排除重複參與者。Study 1 有 302 人,Study 2 約 412 人,Study 3 約 380 人,Study 4 有 526 人;樣本量依 G*Power 的中等效果、α=.05、power=.95 估算。受試者先閱讀一篇關於 ChatGPT 優勢、錯誤/品質或倫理爭議的新聞式材料,再想像規劃紐西蘭南島或香港旅程,評量訪問意向、推薦滿意度、資訊滿意度、準確性與可信度。分析使用 ANOVA、planned contrasts 與 Hayes PROCESS 的 bootstrap serial mediation。
7. 結果
Study 1 顯示,倫理或品質負面線索相較於正面線索,都顯著降低訪問意向、推薦滿意度與可信度;例如訪問意向的整體 ANOVA 為 F(2,299)=4.86, p=.008。可信度進一步中介倫理/品質問題對滿意與訪問意向的影響。Study 2 在不同目的地與不同倫理材料下重複得到相近結果。Study 3 顯示,明確看到 ChatGPT 犯錯會顯著降低依賴,且錯誤使正面訊息原本帶來的優勢被削弱。Study 4 發現,具體景點資訊會提高滿意度;在具體資訊下,倫理負面與正面條件的評價差異縮小,表示功能價值能促成較強的道德脫鉤,但品質負面仍持續傷害評價。
8. 理論貢獻
第一,研究把生成式 AI 的「倫理性」與「輸出品質」放進旅遊推薦的同一個信任模型,說明 AI 接受不能只用有用性或易用性解釋。第二,它把可信度確立為品質/倫理風險轉化為使用者反應的關鍵機制。第三,研究將 algorithm aversion 延伸到互動式生成 AI:使用者不只是看到演算法錯誤時變保守,也會重新評估整套推薦關係。第四,Study 4 提供道德脫鉤的情境邊界——內容越具體、越有決策效用,使用者越可能暫時把倫理評價與資訊採用分開。
9. 實務意涵
旅遊平台與目的地組織不應只追求聊天機器人的自然語氣與個人化,而要優先建立可驗證的資料來源、錯誤揭露、推薦理由與回饋修正機制。服務設計上可將低信心回答標記、要求交叉查證、提供官方連結,並清楚說明資料如何使用。倫理治理也不能只看隱私;偏誤、勞動條件、內容歧視與透明度都會回頭侵蝕信任。若以具體推薦換取短期互動,仍須避免利用道德脫鉤掩蓋品質或責任問題。
10. 研究限制
情境與新聞式操弄不等同於真實旅遊規劃,受試者的訪問意向也不是實際預訂或到訪。樣本來自美國 MTurk,跨文化可外推性有限;研究使用 2023 年 GPT-3.5,模型能力、介面與使用者熟悉度已快速變動。研究主要測量一次性判斷,未觀察長期互動、錯誤修復或信任恢復。倫理問題與品質問題也被以單一顯著性線索處理,尚未細分隱私、偏見、來源透明度與幻覺類型的不同心理效果。
11. 對我研究的啟發
本篇最可重用的角度,是把「AI 生成內容是否被採用」拆成三個層次:輸出本身的資訊品質、我對系統的可信度判斷,以及最後的旅遊/消費行為。若延伸到我的 AI × 認知風格或 human–GenAI collaboration 主線,可檢驗分析型與直覺型我是否不同程度依賴具體推薦、如何處理錯誤揭露,以及 AI literacy 是否讓人更能辨識倫理風險而非單純更信任 AI。若接到旅遊體驗與服務設計,則可把「具體資訊的功能價值」與「倫理透明度」設成雙路徑,測試它們如何共同形塑信任、體驗品質與推薦採用。這也提醒後續研究不要把信任當成單一總分,而應區分能力/準確性信任與道德/善意信任。
12. 整體評價
值得收進核心文獻,尤其適合作為「生成式 AI 旅遊推薦的信任與風險機制」的 empirical support,也可作為服務設計與 AI 倫理 framing paper 的橋接文獻;方法上則可參考多實驗、訊息框架與中介/調節設計。它的優點是研究問題清楚、四個研究互相補強,且把倫理議題從抽象規範轉成可觀察的消費者反應。限制是理論仍偏早期科技接受與訊息評估,缺少真實使用紀錄、跨文化樣本與較新的模型比較;部分效果量偏小,且「錯誤反而削弱負面線索效果」的解釋需要更嚴格區分天花板、期望落差與操弄設計。因此它很適合用來建立研究問題與變項關係,不宜單獨作為長期 AI 旅遊行為的定論。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。