文獻筆記・
用多模態機器學習評估旅遊體驗
單一文字評論、單一圖片或單一評分都只能捕捉旅遊經驗的一部分,可能忽略視覺吸引力、舒適感、文化氛圍與情緒敘事之間的互補或衝突。作者因此要回答:將文字、圖片和數值評分整合後,是否能比 unimodal…
- 論文
- Multimodal machine learning-supported comprehensive evaluation of tourism experience
- 作者
- Yufang Jia(2026)
- 期刊
- Discover Artificial Intelligence, 6(1), 1056
- DOI
- 10.1007/s44163-026-02117-y
- 分類
- 觀光
1. 基本資訊
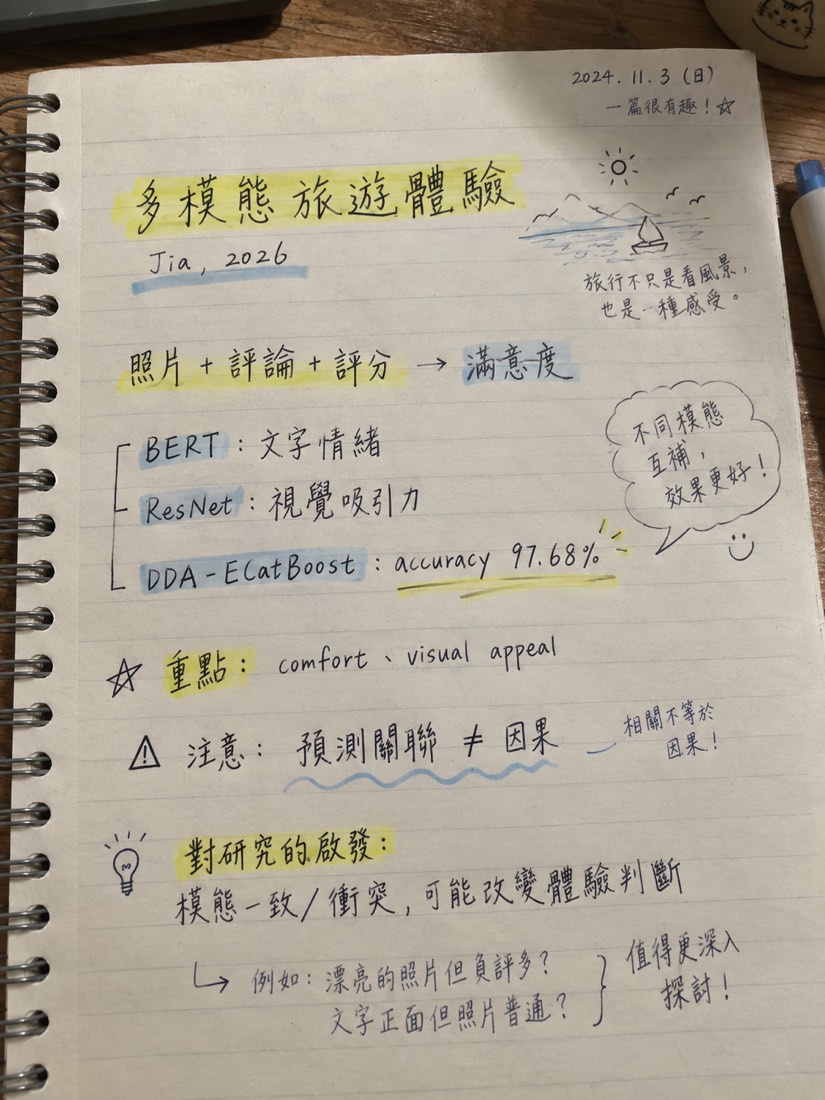
作者 Yufang Jia。研究題名為〈Multimodal machine learning-supported comprehensive evaluation of tourism experience〉。研究使用 Kaggle 的 Multimodal Tourism Experience dataset,將旅遊照片、同一旅客的文字評論與 1–5 分滿意度評分整合,用 BERT 抽取文字情緒、ResNet-50 抽取視覺表徵,再以 early feature-level fusion 接上 DDA-ECatBoost,預測二元化的旅客滿意度。研究的核心不是建立新的旅遊體驗理論,而是提出一個可解釋、可部署的多模態預測流程。
2. 研究問題
單一文字評論、單一圖片或單一評分都只能捕捉旅遊經驗的一部分,可能忽略視覺吸引力、舒適感、文化氛圍與情緒敘事之間的互補或衝突。作者因此要回答:將文字、圖片和數值評分整合後,是否能比 unimodal 或傳統模型更準確地預測旅客滿意度?哪些多模態特徵對預測最有用?模型在不同滿意度切分門檻下是否仍穩定?
3. 理論基礎
論文沒有提出明確的心理學或消費者行為理論模型,主要依據是多模態表示學習、轉移學習、情緒分析與可解釋機器學習。其隱含的研究觀點是:旅遊體驗是由環境/美學、文字情緒與服務或舒適感訊號共同構成,異質資料的互補性可以提高滿意度辨識。這是「測量與預測邏輯」而非「因果理論」;feature importance 只能說明模型依賴哪些訊號,不能證明那些訊號造成滿意度。
4. 研究架構
流程可概括為:資料清理與影像 Gaussian filtering → 評分 Min–Max normalization → BERT-base-uncased 產生文字情緒表徵、ResNet-50 產生影像表徵 → 將文字、影像與評分嵌入向量 early concatenation → DDA 以 Differential Evolution 做全域探索、再以 Simulated Annealing 做局部搜尋 → ECatBoost 分類滿意/不滿意。原始 18,300 筆資料中,作者只取三種模態皆完整且類別平衡的 2,000 筆;評分 1–2 設為低滿意、4–5 設為高滿意,3 分排除。
5. 假設邏輯
本文不是問卷式假設檢驗研究,沒有正式 H1–Hn。其命題邏輯是:若旅遊滿意度同時反映可視的目的地吸引力、文字中的情緒/舒適訊號以及評分資訊,那麼三種模態的聯合表徵應優於單一模態;若超參數搜尋能改善 ECatBoost 的探索與收斂,DDA-ECatBoost 應優於未最佳化的 CatBoost/ECatBoost。這些命題由模型比較、消融分析與門檻敏感度分析支持,但不等於理論因果假設。
6. 方法
資料以固定 random seed = 42 分層切分;文中不同段落對切分比例有 80/20 與 70/15/15 的表述,正式實驗 setup 採 70% training、15% validation、15% testing。訓練資料用來學習前處理與調參,測試集保留到最後。文本最大長度 128 tokens,圖片調整為 224×224。模型比較包含 CNN、BERT-BiLSTM-CNN-Attention、CatBoost、ECatBoost、Transfer Learning、DNN、SVM 與 Naive Bayes;另以消融研究拆解 ECatBoost 與 DDA 的作用,並以 bootstrap、confusion matrix、ROC、PR curve、t-SNE 和 threshold sensitivity 補充檢驗。
7. 結果
提出的 DDA-ECatBoost 在作者報告的測試結果達 accuracy 0.9768、precision 0.9647、recall 0.9555、F1 0.9651;混淆矩陣列出 TN=1,715、TP=1,702、FP=124、FN=121。消融結果顯示 CatBoost accuracy 0.8150、ECatBoost 0.8580、CatBoost+DDA 0.9315,而完整 DDA-ECatBoost 為 0.9768。模型特徵重要度主要指向 comfort、visual appeal、infrastructure quality 與 cultural atmosphere,但作者也承認這些是預測關聯,不是因果效果。錯誤多發生於圖片很吸引人但文字負面、或評論過短而與評分衝突的案例;門檻改為 ≥3、≥4、=5 時表現下降至約 0.86–0.80 accuracy,顯示二元化規則會影響數字。
8. 理論貢獻
理論貢獻有限但方法論價值清楚。第一,它把旅遊體驗從「評論文字或總評分」推向文字、視覺與評分的聯合觀察單位。第二,它示範 early fusion 加可解釋 boosting 如何在不進行昂貴 end-to-end multimodal training 的情況下處理異質資料。第三,錯誤分析提出一個值得後續理論化的觀點:旅客體驗中的不同模態可能不是單純互補,也可能在訊號不一致時造成判斷邊界與不確定性。
9. 實務意涵
目的地管理者可以把評論情緒、旅遊影像和評分放在同一個監測流程中,辨識「看起來很美但實際舒適度不足」或「文字正向但視覺吸引力不足」的體驗落差。對旅遊行銷而言,visual appeal 不應獨立於服務品質與舒適感;對文化遺產場域而言,模型可協助排序需要改善的基礎設施、氛圍或敘事元素。但實務部署前仍要做跨目的地、跨語言與缺失模態驗證,不能直接把 Kaggle 資料上的高 accuracy 當作真實市場效果。
10. 研究限制
最大的限制是只使用單一 Kaggle 資料集,且從 18,300 筆縮成 2,000 筆完整且平衡樣本,可能造成選擇偏誤與外部效度不足。資料來源、旅客人口特徵、地點分布、評論生成情境與圖片—評論配對品質的交代仍不夠充分;使用者生成內容也有平台與自我選擇偏誤。評分被二元化並排除中立 3 分,可能把序位與模糊滿意度丟失。作者提出的 cross-regional、缺失模態、影音/地理資料與 attention fusion,都是必要的後續方向。
11. 對我研究的啟發
這篇最值得移植的不是 DDA-ECatBoost 本身,而是把「旅遊體驗」操作化為可對齊的多模態事件:同一筆體驗同時保留旅客看見什麼、說了什麼、最後給了多少分。若我的研究要連接 consumer experience、service design、AI 或 service robot adoption,可以把圖片/場景線索、互動後文字敘事、滿意度與信任/溫暖/能力評價放在同一分析框架,再檢驗不同模態一致或衝突時的體驗形成機制。更重要的是,本文提醒要把「模型預測出的重要特徵」與「造成體驗的心理機制」分開;後續可用實驗、縱貫資料或跨場域驗證,把多模態預測轉成可解釋的條件式理論,例如視覺吸引力在高涉入、服務失誤或低信任情境下是否會被文字負面訊號抵銷。
12. 整體評價
值得收進我的方法補充文獻與 tourism analytics/multimodal consumer experience 文獻群,但暫不宜當作核心理論 framing paper。它適合當 empirical/methods reference:提供一個可重現的 BERT+ResNet+feature fusion+boosting 流程,也提供模態衝突的錯誤分析。它不適合單獨作為「視覺吸引力造成滿意度」的實證證據,因為研究是單一資料集的預測設計,且資料縮減、二元化、跨場域外推與 baseline 公平性仍有疑點。整體而言,這是實用但需保守解讀的初步模型論文;最可重用的研究角度是「多模態訊號一致性/衝突如何條件化旅遊體驗與滿意度判斷」。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。