文獻筆記・
服務機器人出錯時,顧客會向它抱怨嗎
既有服務機器人研究多關注服務補救後的滿意度、信任或再購意圖,卻常預設顧客會先向機器人提出抱怨。本研究追問更前置的關鍵關卡:服務失誤發生後,顧客是否願意把機器人視為「值得抱怨的對象」?具體而言,機器…
- 論文
- Anthropomorphic service robots in service failure: The roles of warmth, competence, and failure severity in shaping complaint intentions
- 作者
- Peyman Ajdari, Fereshte Rasty, Raffaele Filieri(2026)
- 期刊
- International Journal of Hospitality Management, 135, 104624
- DOI
- 10.1016/j.ijhm.2026.104624
- 分類
- 行銷
1. 基本資訊
Ajdari, P., Rasty, F., & Filieri, R. (2026). Anthropomorphic service robots in service failure: The roles of warmth, competence, and failure severity in shaping complaint intentions. International Journal of Hospitality Management, 135, 104624. DOI:10.1016/j.ijhm.2026.104624。全文由 HAL 開放存取版本(HAL Id: hal-05563836)保存。本刊為正式國際旅宿管理期刊;本輪未另行核對最新 JCR 分區、Scopus CiteScore 或排名,故 ranking 未明確確認。
2. 研究問題
既有服務機器人研究多關注服務補救後的滿意度、信任或再購意圖,卻常預設顧客會先向機器人提出抱怨。本研究追問更前置的關鍵關卡:服務失誤發生後,顧客是否願意把機器人視為「值得抱怨的對象」?具體而言,機器人的擬人化知覺是否提高抱怨意圖?這種效果是否透過知覺溫暖與知覺能力發生,並受失誤嚴重度調節?
3. 理論基礎
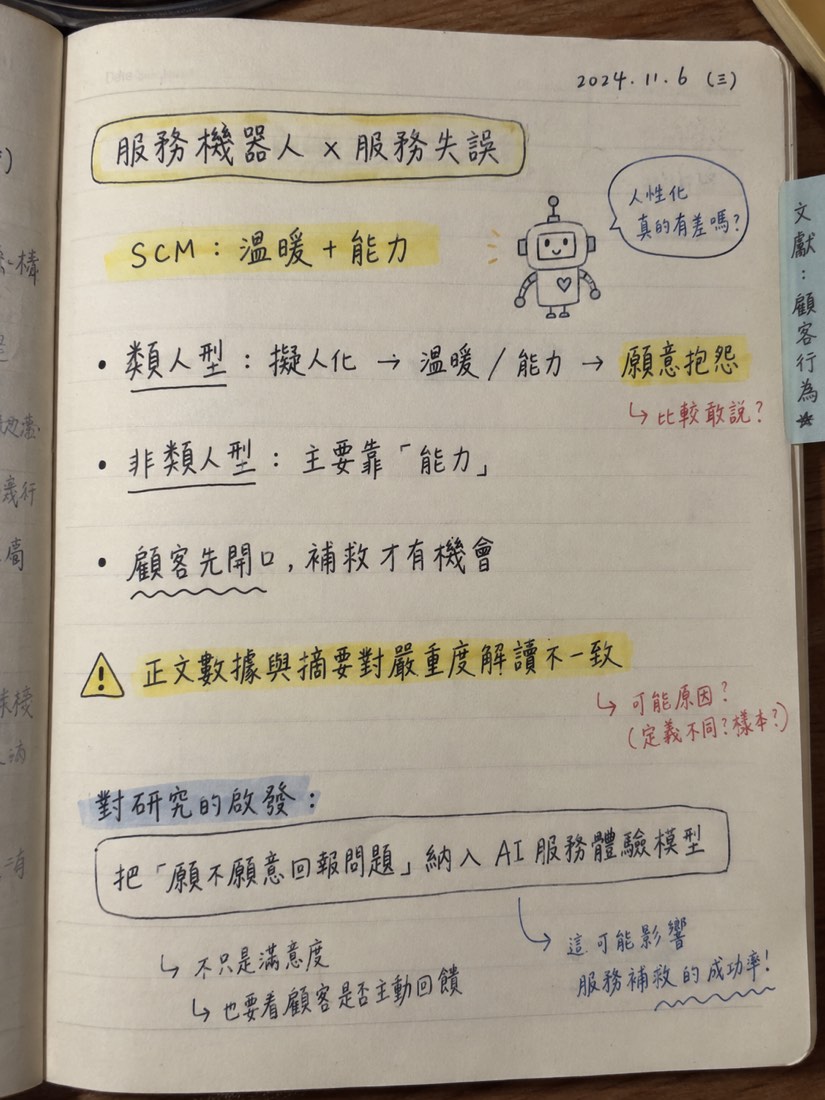
核心理論是 Stereotype Content Model(SCM,刻板印象內容模型)。SCM 將社會對象的判斷拆為溫暖(善意、友好、同理)與能力(效率、智慧、解決問題的能力)兩個普遍維度。作者把此模型延伸到人—機器人服務接觸:擬人化線索提高社會臨場感,可能同時啟動關係性判斷與功能性判斷;溫暖降低「會不會被忽視」的關係風險,能力降低「問題能否被處理」的工具性風險。失誤嚴重度則被視為情境邊界,使顧客在情感安撫與問題解決之間切換。
4. 研究架構
模型以知覺擬人化為前因、抱怨意圖為結果,知覺溫暖與知覺能力為平行中介;服務失誤嚴重度(輕微/嚴重)調節前述路徑。研究用兩個平行情境實驗固定機器人外型:研究一使用類人型機器人,研究二使用非類人、機械型機器人。這個設計可以觀察機制在不同具身形式下是否穩健,但因兩種外型未在同一個完整交叉實驗中操弄,不能把兩研究的係數差異直接解讀為外型的因果比較。
5. 假設邏輯
H1 預期擬人化提高抱怨意圖;H2 預期擬人化提高能力與溫暖知覺;H3 預期能力與溫暖都提高抱怨意圖;H4 預期兩者形成中介。H5 原本主張:輕微失誤時擬人化與溫暖的效果較強,嚴重失誤時能力的效果較強。這套邏輯具有清楚的雙風險解釋:低損失情境較需要被理解,高損失情境較需要可信的修復能力。不過,正文 PROCESS 結果對「能力在嚴重失誤下更強」的支持並不一致,反而顯示研究一的能力—抱怨意圖交互作用為負,條件效果在輕微失誤較大;這是本文必須保留的解釋疑點。
6. 方法
研究採兩個獨立、基於情境的組間實驗,透過 MTurk 招募曾與服務機器人有正面或中性實際接觸的受試者。研究一類人型機器人 N=354,研究二非類人機器人 N=351;受試者隨機閱讀輕微或嚴重服務失誤情境。前測 N=60 確認類人型的擬人化知覺顯著較高(4.90 vs. 2.53),也確認嚴重度操弄。各構念以七點量表測量:擬人化四題、溫暖三題、能力三題、抱怨意圖三題。分析包含 CFA、CB-SEM(2,000 次 bootstrap)、PROCESS Model 4 中介與 Model 15 調節式中介。
7. 結果
測量模型整體適配良好(兩研究 CFI=.987/.990、RMSEA=.023/.020),信度與聚合、區辨效度大致達標。研究一中,擬人化正向預測能力(β=.288)、溫暖(β=.316)與抱怨意圖(β=.319);能力(β=.475)是較強的抱怨意圖預測因子,溫暖亦顯著(β=.242),兩者皆構成中介,其中能力的間接效果大於溫暖。研究二中,擬人化只顯著提高能力(β=.144),能力提高抱怨意圖(β=.286);擬人化—溫暖、溫暖—抱怨及擬人化—抱怨皆不顯著,但能力仍形成小幅顯著中介。
嚴重度在兩研究都成功操弄,且本身降低抱怨意圖。研究一的 Model 15 顯示能力×嚴重度顯著為負(b=-.3666),能力在輕微失誤的條件效果 b=.4788、大於嚴重失誤的 b=.1122;溫暖相關調節不顯著。研究二所有交互作用均不顯著,能力在輕微失誤顯著、嚴重失誤不顯著。值得注意的是,論文摘要與討論文字多次寫成「嚴重失誤時能力更重要」,但表格與 PROCESS 數值支持的是「研究一能力效果在輕微失誤較大、研究二未顯示嚴重度調節」;因此不能無保留地接受作者的主結論。
8. 理論貢獻
第一,研究把服務補救的分析起點往前推到「抱怨啟動」,指出再好的補救系統也可能因顧客不開口而失效。第二,SCM 不再只是靜態描述機器人被看成溫暖或有能力,而被用來解釋抱怨這種具社會風險、需要行動的行為。第三,結果顯示擬人化不是普遍正向設計資產:它對溫暖與抱怨的作用高度依賴具身形式,非類人機器人主要靠能力而非社會線索促成顧客發聲。第四,論文提出「關係風險/工具性風險」的整合視角,對理解服務機器人何時能啟動顧客聲音很有可重用性;但嚴重度的理論邊界仍需更嚴謹驗證。
9. 實務意涵
旅宿業者應把「讓顧客願意抱怨」視為服務補救設計的一部分,而非只優化事後賠償。機器人可依失誤類型切換話術:先以明確診斷、能力邊界與升級流程建立可處理性,再以適度同理與確認感降低關係阻力。類人型機器人較適合作為低風險、需要情緒安撫的第一接觸點;高風險或複雜事件應快速轉接真人或具更高解決能力的系統。實作上需採「校準式擬人化」,避免不自然外觀、過度承諾或把機器人塑造成無法兌現的社會代理人,並以真實互動回饋持續修正外型、聲音與升級規則。
10. 研究限制
兩種機器人外型分屬兩個研究,不能做嚴格的直接外型因果比較;情境圖片實驗也無法捕捉真實互動中的延遲、聲音、情緒與失誤修復。MTurk 便利樣本與英語情境限制外部效度,且未蒐集文化/族群背景,因此跨文化推論有限。研究只操弄視覺擬人化,未納入語音、語氣、性別、適應性智能、易用性與有用性等機制。最後,作者對嚴重度調節的摘要/討論敘述與正文統計結果不完全一致,顯示需要重新檢查編碼方向、條件效果解讀與假設標示。
11. 對我研究的啟發
這篇最適合轉化為「AI 介入服務體驗的前置啟動機制」:在觀光或旅宿的 human–GenAI collaboration 研究中,不要只測滿意度、採用意圖或體驗價值,也可測顧客是否願意回報問題、補充資訊與共同修正服務。可將 認知風格/AI 素養 作為個體層調節,將「能力可信度」與「溫暖/社會臨場感」作為雙路徑中介,再把服務失誤嚴重度、任務涉入與服務情境(功能型 vs. 享樂型)放入多層次模型。方法上,建議採同一受試者內的 2(類人/非類人)×2(輕微/嚴重)×2(機器人/真人升級)完整因子設計,並加入真實互動或影片操弄,避免本研究跨研究比較的限制。最值得移植的研究命題是:AI 的社會線索只有在顧客相信「開口後真的能改變結果」時,才會轉化為有效的顧客聲音。
12. 整體評價
值得收進核心文獻,定位上是 旅宿服務機器人/消費者抱怨行為的 empirical support,也可作為「服務補救從結果回溯到啟動」的 framing paper。優點是研究問題前置、SCM 與服務失誤脈絡結合清楚,且以兩種具身形式與中介分析提供可比較的機制證據。限制則包括便利樣本、圖片情境、外型未完整交叉操弄,以及最重要的嚴重度結果解讀不一致。我的結論是:可引用其「溫暖—能力雙路徑」與「顧客聲音是脆弱瓶頸」兩個洞見,但引用「嚴重失誤時能力效果更強」前,應以正文係數與未來重複研究為準,不能把作者的敘述當成已確立證據。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。