文獻筆記・
LLM認知輕鬆代價
作者真正想回答三個問題。第一,學生使用傳統搜尋引擎與 LLM 蒐集科學資訊時,內在、外在與增生認知負荷是否不同?第二,兩種工具會不會造成最終論證品質差異?第三,LLM 傾向給出直接、整合式答案,是…
- 論文
- Cognitive ease at a cost: LLMs reduce mental effort but compromise depth in student scientific inquiry
- 作者
- Matthias Stadler、Maria Bannert、Michael Sailer(2024(2024 年 7 月 30 日 online available))
- 期刊
- Computers in Human Behavior, 160, Article 108386
- DOI
- 10.1016/j.chb.2024.108386
- 分類
- 教育 AI × 認知風格 心智努力 GenAI × 知識建構 高等教育
2. 研究問題
作者真正想回答三個問題。第一,學生使用傳統搜尋引擎與 LLM 蒐集科學資訊時,內在、外在與增生認知負荷是否不同?第二,兩種工具會不會造成最終論證品質差異?第三,LLM 傾向給出直接、整合式答案,是否會使學生的建議更同質、縮小觀點多樣性?
問題的重要性在於,「降低認知負荷」在教育科技研究中通常被當成正面結果,但負荷並非越低越好。外在負荷來自介面、無關資訊與搜尋成本,降低它可能釋放工作記憶;增生負荷則反映整理、連結與建立基模所投入的資源,若一併被省去,學生可能只得到流暢答案,沒有真正完成比較、推論與知識建構。既有討論經常把 LLM 的便利性直接等同學習效益,本文補上的缺口正是:便利究竟移除了無益成本,還是也移除了形成深度理解所需的認知活動?
3. 理論基礎
第一條主軸是認知負荷理論(Cognitive Load Theory, CLT)。人的工作記憶容量有限;學習活動同時可能產生內在負荷(材料本身及元素互動的複雜度)、外在負荷(呈現方式與無關處理造成的成本)及增生負荷(用於組織、整合和基模建構的資源)。在搜尋情境中,Google 要求辨識來源、排除不相關內容並整合多個頁面,預期提高三類負荷;ChatGPT 以自然語言給出直接答案,預期降低搜尋與整合成本。
第二條主軸是自我調整學習(self-regulated learning)。資訊搜尋不只是找到答案,而是學習者依目標監控理解、選擇策略、評估來源並調整行動。作者援引 Seufert 的觀點,把自我調整視為認知負荷與可用資源之間的平衡:任務太難時沒有資源調整,太簡單時又可能缺乏調整動機;中等難度最能促成策略性加工。
第三條主軸是 Search as Learning:搜尋本身可是一種學習活動,因為查詢、閱讀、比較與綜合會迫使學習者主動處理資訊。本文的關鍵整合是:LLM 降低外在與內在負荷固然可能有益,但若也降低增生負荷及自我調整需求,答案的「認知流暢」可能以較淺的推理為代價。
4. 研究架構
研究架構可寫成:
資訊蒐集工具(Google 搜尋 vs. ChatGPT 3.5) → 三類認知負荷(ICL/ECL/GCL) → 最終論證品質
並另有一條結果路徑:
資訊蒐集工具 → 建議方向的分布/同質性
其中自變數是隨機分派的工具類型;依變數包括內在、外在、增生認知負荷、論證中涵蓋的有效理由數,以及支持/中立/反對使用奈米粒子防曬品的建議分類。奈米科技先備知識作為共變項。作者另外以探索性中介分析檢驗:工具類型是否透過增生認知負荷影響論證品質。
這個架構值得注意的地方,是把「品質」與「多樣性」分開。LLM 可能降低個人推理深度,但不一定讓所有人得出相同結論;因此,個體層次的深度與群體層次的同質化是兩個不同結果,不應混為一談。
5. 假設邏輯
H1.1、H1.2 與 H1.3 分別預測 LLM 組的外在、內在與增生認知負荷低於搜尋引擎組。理由是 LLM 能接受自然語言問題,直接提供整理後答案,也可用追問澄清內容;使用者較少需要篩選無關頁面、理解零散材料、切換來源與自行整合,因此三類主觀負荷都可能下降。
H2 採非方向性假設,預測兩組論證品質有差異。作者誠實呈現兩個相反機制:自我調整學習觀點認為任務變簡單可釋放資源、改善理解;認知負荷觀點則認為,LLM 若降低用於推論與建構基模的增生負荷,會使深度加工與記憶變差。因理論不能事先排除其中一條,作者沒有硬設方向。進一步的中介推論是:若搜尋工具確實造成品質差異,較高的增生負荷可能是「搜尋引擎促進較佳論證」的傳遞機制;作者清楚標示此分析為探索性。
H3 預測 LLM 組的建議變異較小。其邏輯是搜尋引擎呈現多個來源與彼此不同的觀點,LLM 則傾向輸出一個整合且貌似確定的答案,因此後者可能讓使用者收斂到相似立場。
6. 方法
研究於 2023 年 4 至 5 月進行。最初有 92 人,一人同時使用 LLM 與搜尋引擎、不符合指示而剔除,最終樣本為 91 人,其中女性 67 人、男性 24 人,平均年齡 22.3 歲(SD = 4.11)。學生被隨機分到 Google 組 47 人或 ChatGPT 3.5 組 44 人,皆在大學電腦教室個別完成任務。ChatGPT 組的初始對話先輸入一段要求系統自我介紹並說明互動方式的提示,以避免部分學生不知道如何使用工具。
參與者先填人口背景資料,再讀取奈米粒子防曬的情境,於二十分鐘內查找健康風險相關資訊。搜尋結束後,先完成認知負荷問卷,再在不能查看資訊來源的條件下寫出建議與理由,最後作答奈米科技先備知識測驗。這個順序旨在避免寫作負荷污染搜尋階段的負荷評量,也避免事前測驗洩漏搜尋關鍵詞。
認知負荷採 Klepsch 等人的七題量表,以 1 至 7 分測量 ICL、ECL 與 GCL;本研究 McDonald’s ω 分別為 .78、.70、.69。論證品質以七個領域相關觀點的編碼架構計分,例如已知風險程度、粒子塗層、破損皮膚、噴霧吸入風險與替代方案等;兩位評分者的一致性 κ = .92。建議方向編為支持(+1)、中立(0)、反對(−1),評分者一致性 κ = .89。先備知識使用改編的八題 Public Knowledge of Nanotechnology 測驗。
分析方面,作者先以 t 檢定檢查兩組先備知識是否平衡,再用 ANCOVA 比較兩組的三類負荷與論證品質,控制先備知識;用 jAMM 進行探索性中介分析;用卡方檢定比較建議分布。顯著水準設定為 .05,軟體為 jamovi 2.3。資料與材料連結至 OSF(原文提供 https://osf.io/jpxyt)。原文未明確說明預先註冊,因此不應把研究描述成 preregistered。
7. 結果
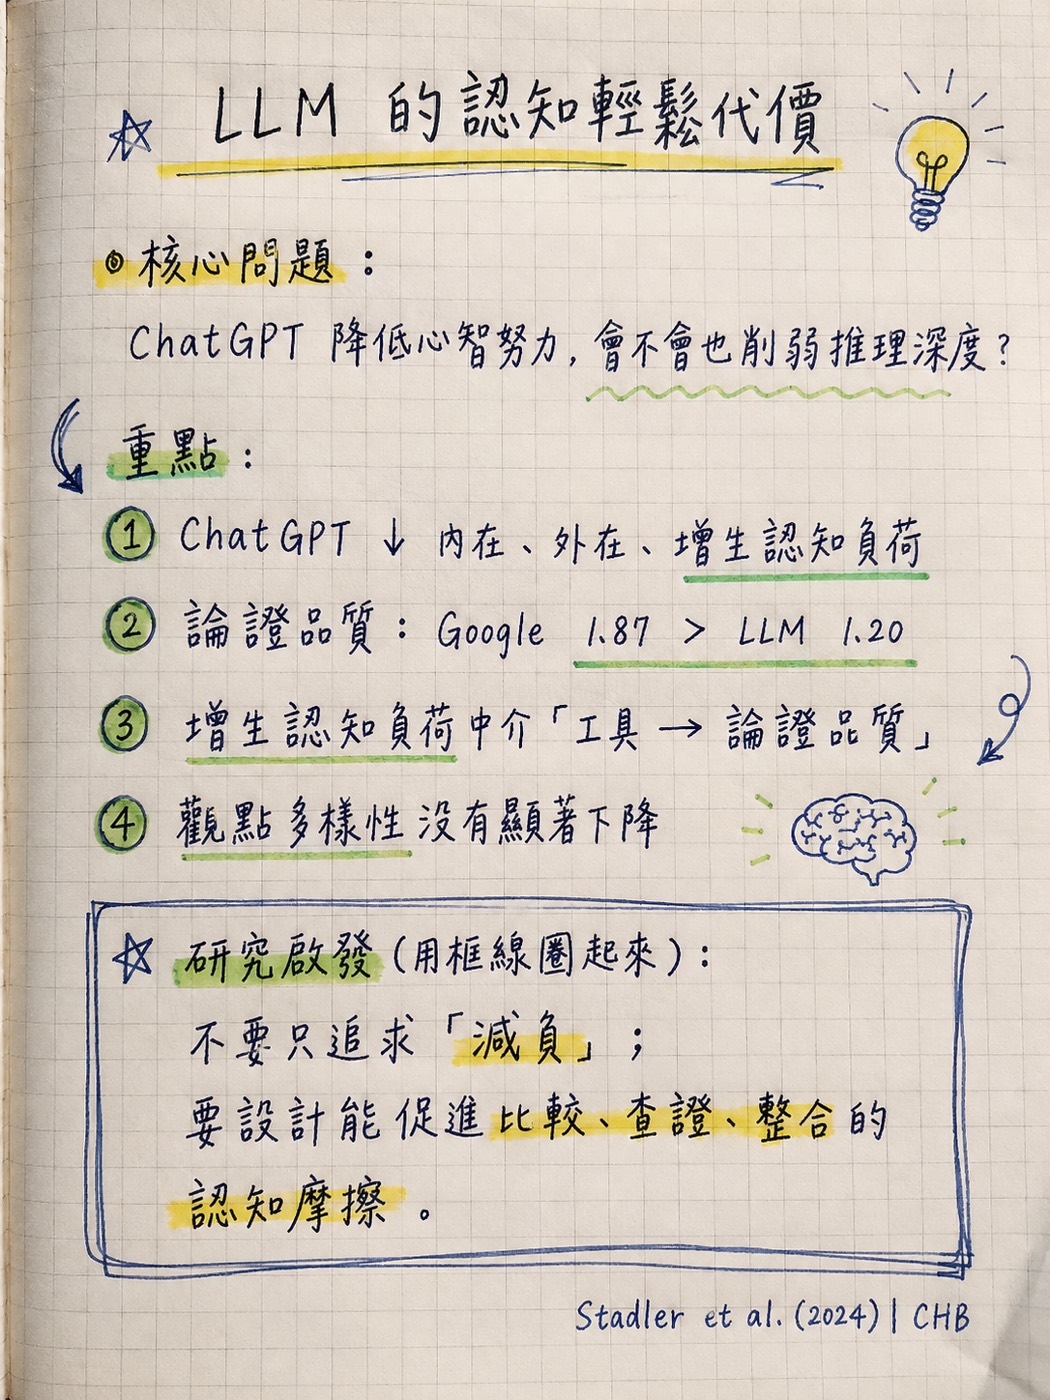
隨機化檢查顯示兩組先備知識沒有顯著差異,t(89) = −0.28,p = .777,d = −0.06。控制先備知識後,H1.1 至 H1.3 全獲支持:Google 組的外在負荷平均 3.96(SD = 1.55),ChatGPT 組為 3.00(SD = 1.67),F = 8.26,p = .005,η² = .09;內在負荷分別為 4.43 與 3.16,F = 16.48,p < .001,η² = .15;增生負荷分別為 4.79 與 3.14,F = 33.06,p < .001,η² = .27。最大差異出現在與主動整合、基模建構相關的增生負荷,而非單純介面雜訊。
H2 亦獲支持,而且方向對 LLM 不利:Google 組平均提出 1.87 個有效理由(SD = 1.10),ChatGPT 組只有 1.20(SD = .77),F = 11.18,p = .001,η² = .11。探索性分析發現,增生認知負荷的間接效果顯著(β = .15,p = .020),控制它後工具的直接效果不顯著(β = .19,p = .095);作者據此稱為完全中介。正確解讀不是「所有負荷越高越好」,而是搜尋引擎要求的主動整合活動,可能正是較完整論證的來源。
H3 未獲支持。ChatGPT 組的建議為反對 9、中立 7、支持 28;Google 組為反對 15、中立 8、支持 24。兩組分布差異不顯著,χ²(2) = 1.78,p = .411。也就是說,LLM 讓個別論證變淺,卻沒有在此任務中顯著壓縮最終立場的多樣性。這是重要的區辨:低品質與同質化不是同一件事。
8. 理論貢獻
本文最有價值的理論貢獻,是修正「降低認知負荷必然提升學習」的簡化敘事。它指出應區分被工具消除的無益負荷,以及學習者為比較、組織、推論和建構基模而投入的生成性心智活動。LLM 的價值不只取決於輸出正不正確,也取決於它改寫了學習任務的認知結構:當系統直接完成資訊整合,學習者可能失去必須親自執行的知識建構步驟。
第二,本文把認知負荷理論與自我調整學習連結起來。負荷不是單純的成本變項,而可能是觸發監控、策略選擇與深度處理的條件;「適度困難」比「最低努力」更接近高品質學習的必要條件。第三,結果推翻 LLM 必然造成觀點收斂的直覺假設,顯示研究者須分別建模推理深度、事實正確性、論證廣度與意見多樣性。
9. 實務意涵
對高等教育與學習科技設計而言,不宜把 ChatGPT 當成搜尋引擎的直接替代品,也不宜以「學生覺得更容易」作為成效證據。較好的教學流程是讓 LLM 減少重複或機械性負擔,同時保留要求學生親自比較來源、辨認爭議、列出反證、說明證據鏈與整合多份材料的任務。可採取「先獨立形成初步判斷 → 再詢問 LLM → 要求找出衝突來源 → 不看對話重建論證」的設計。
對平台與課程設計者而言,護欄不應只阻止直接給答案,也可加入促進認知摩擦的介面:要求使用者先寫預測、標註依據、對照第二來源、評估不確定性,再生成整合回答。對管理與知識工作亦同理:若員工直接接受 AI 彙整,會議資料看似更快完成,卻可能損失跨來源整合與異常辨識。最該讀本篇的是高教教師、學習科技設計者、知識管理研究者,以及關注 GenAI 對判斷品質影響的組織與決策學者。
10. 研究限制
作者承認的限制包括:沒有蒐集放聲思考或搜尋歷程,因此無法直接看見學生採取哪些認知與後設認知策略;沒有分析提示技巧與既有 LLM 經驗,兩者可能是重要調節變項;樣本小、非代表性抽樣,而且只包含大學生,外部效度有限;實驗強制二選一使用 Google 或 ChatGPT,但真實世界多半會混用工具;研究完成後搜尋引擎已整合 LLM、LLM 也具有連網搜尋功能,2023 年的工具界線正快速消失。先備知識測驗安排在搜尋後,雖可避免題目提示關鍵詞,卻可能已受到處理組別影響。
額外可見的限制有五點。第一,最終成果衡量的是七類有效理由的「廣度」,不是論證正確性、因果結構、來源可信度或長期保留,故標題中的 depth 有一定操作化限度。第二,GCL 是自陳量表,且 ω = .69 僅接近可接受門檻;用它建立完全中介的因果機制要保守。第三,中介分析是探索性的、未明確預先註冊,樣本只有 91 人,直接效果 p = .095 也不等於證明效果為零。第四,Google 組可能接觸更多總資訊量,無法完全區分「工具介面」與「資訊曝光量」。第五,只使用 GPT-3.5、單一德語/德國大學情境及一個奈米科技任務,不能直接推廣到較新模型、長期課程、創意任務或專業知識工作。
11. 對我研究的啟發
本篇最直接的啟發,是把「AI 使用」改寫成「AI 重新分配了哪些認知工作」。我若研究 AI × 認知風格、知識創造或創新機制,可將工具設計拆成三種條件:直接答案型、提示/鷹架型、跨來源比較型;中介變項則同時測量認知負荷、後設認知監控、認知投入與知識整合。依變數不宜只放自陳學習成效,可採專家評分的論證品質、想法新穎性與可行性、錯誤偵測率,以及撤除 AI 後的獨立表現。
可重用的理論鏈條是:
GenAI 支援形式 → 認知摩擦/增生負荷 → 比較、查證與整合行為 → 知識品質或創新績效
認知風格可放在調節位置。例如分析型/整體型、認知需求、認知反思或模糊容忍度,可能決定低摩擦答案究竟釋放資源,還是誘發淺層接受。另一個有價值的雙路徑模型是:GenAI → 外在負荷下降 → 效率提升,同時 GenAI → 增生負荷下降 → 深度加工降低;最後由任務複雜度、先備知識與鷹架設計決定淨效果。這比單一路徑的「AI 自我效能 → 使用意圖」更能形成可檢驗的理論貢獻。
在文獻角色上,本篇適合當作 framing paper+empirical support:用來支持「認知便利具有雙面性」與「知識創造需要適度認知摩擦」。它也可當 methods reference,因為提供了兩組隨機實驗、負荷量表、先備知識控制及雙評分者內容編碼。不過若要複製,建議預先註冊中介模型,保留提示與點擊歷程,加入 AI 撤除後測與延宕測驗,並把 GCL 與可觀察的整合行為分開測量。若延伸到管理情境,可讓受試者完成市場進入、服務補救或新產品決策,再比較「AI 直接建議」與「AI 要求反證及多方案比較」對創新品質的影響。
12. 整體評價
**明確判斷:值得讀,值得納入核心文獻,也值得在設計研究模型時反覆回看。**它最強之處是用隨機分派與具體論證成果,把「更省力」和「學得更深」拆開;效應不只是統計顯著,三類負荷與論證品質的 η² 約為 .09 至 .27,具有清楚的實質差異。它也避免把不同結論硬塞進同一敘事:論證品質下降,但觀點同質化沒有發生。
它最弱之處是機制證據仍主要依賴自陳 GCL 與探索性中介,且「論證深度」以理由數量代理;因此不能據此斷言 LLM 普遍傷害所有學習,也不能把較高負荷本身當成教學目標。較精確的結論是:在這個陌生、爭議性的科學資訊搜尋任務中,ChatGPT 3.5 降低了學生主觀負荷,但搜尋引擎組產生較完整的理由,而差異與增生負荷有關。
文獻用途方面:作為 framing paper:高適合;作為 empirical support:高適合;作為 methods reference:中高適合;作為證明「GenAI 導致長期能力衰退」的來源:不適合,因為沒有長期或撤除 AI 後測。核心收藏優先度可評為 A−:理論問題精準、設計乾淨、全文短而資訊密度高,但樣本與機制測量仍需更強研究補足。
今日結論
今天讀的是 Stadler、Bannert 與 Sailer(2024)的 Computers in Human Behavior 正式期刊論文。期刊的 SSCI、Scopus 收錄及 Q1 品質可確認,AJG 精確星等未明確確認。最可重用的研究角度是「GenAI 支援形式 → 認知摩擦/增生負荷 → 知識整合與創新品質」。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。