文獻筆記・
GenAI批判思考與認知努力
作者真正要回答兩個問題。RQ1 問:知識工作者在使用 GenAI 時,何時、如何感覺自己實踐了批判思考?RQ2 問:GenAI 在什麼條件下、基於什麼原因,使各類批判思考活動感覺更省力或更費力?重…
- 論文
- The Impact of Generative AI on Critical Thinking: Self-Reported Reductions in Cognitive Effort and Confidence Effects From a Survey of Knowledge Workers
- 作者
- Hao-Ping (Hank) Lee、Advait Sarkar、Lev Tankelevitch、Ian Drosos、Sean Rintel、Richard Banks、Nicholas Wilson(2025)
- 期刊
- DOI
- 10.1145/3706598.3713778
- 分類
- AI 應用 Human–GenAI collaboration AI × 批判思考 認知努力 知識工作
2. 研究問題
作者真正要回答兩個問題。RQ1 問:知識工作者在使用 GenAI 時,何時、如何感覺自己實踐了批判思考?RQ2 問:GenAI 在什麼條件下、基於什麼原因,使各類批判思考活動感覺更省力或更費力?重要性在於,既有研究常用最終產出品質、內容多樣性或是否接受 AI 建議當作思考代理指標,卻看不到使用者在提示、查證、修改與整合階段的內在工作。本文補的缺口,是跨職業、跨任務的真實使用經驗,以及「思考是否發生」與「思考有多費力」兩件事之間的區分。
3. 理論基礎
第一條主軸是 Bloom 認知分類,作者以知識、理解、應用、分析、綜合與評估六種活動操作化批判思考所需的認知努力。第二條是 認知卸載:使用者把搜尋、草擬或解題委派給 AI,可能節省資源,也可能失去練習判斷的機會。第三條是 過度依賴與自動化反諷:自動化日常工作後,人只在例外情況介入,卻可能因平時缺乏練習而更不擅長處理例外。第四條是信心校準:對 AI 的任務信心、對自身完成任務的信心、以及對自己評估 AI 輸出的信心,可能導向不同程度的查證與反思。
需要注意,Bloom taxonomy 原本是教育目標分類,作者將它移植到成人工作場域是務實的測量選擇,不等於它能完整涵蓋所有批判思考,例如認識論謙遜、證據權衡、倫理推理與情境判斷仍可能被壓縮。
4. 研究架構
研究架構可文字化為:
任務因素(任務類型、自我任務信心、AI 任務信心、評估 AI 信心)+使用者因素(反思傾向、一般 AI 信任、人口與職業特徵) → 是否自陳實踐批判思考;同一組前因再分別預測 知識/理解/應用/分析/綜合/評估 六種活動的知覺努力變化。
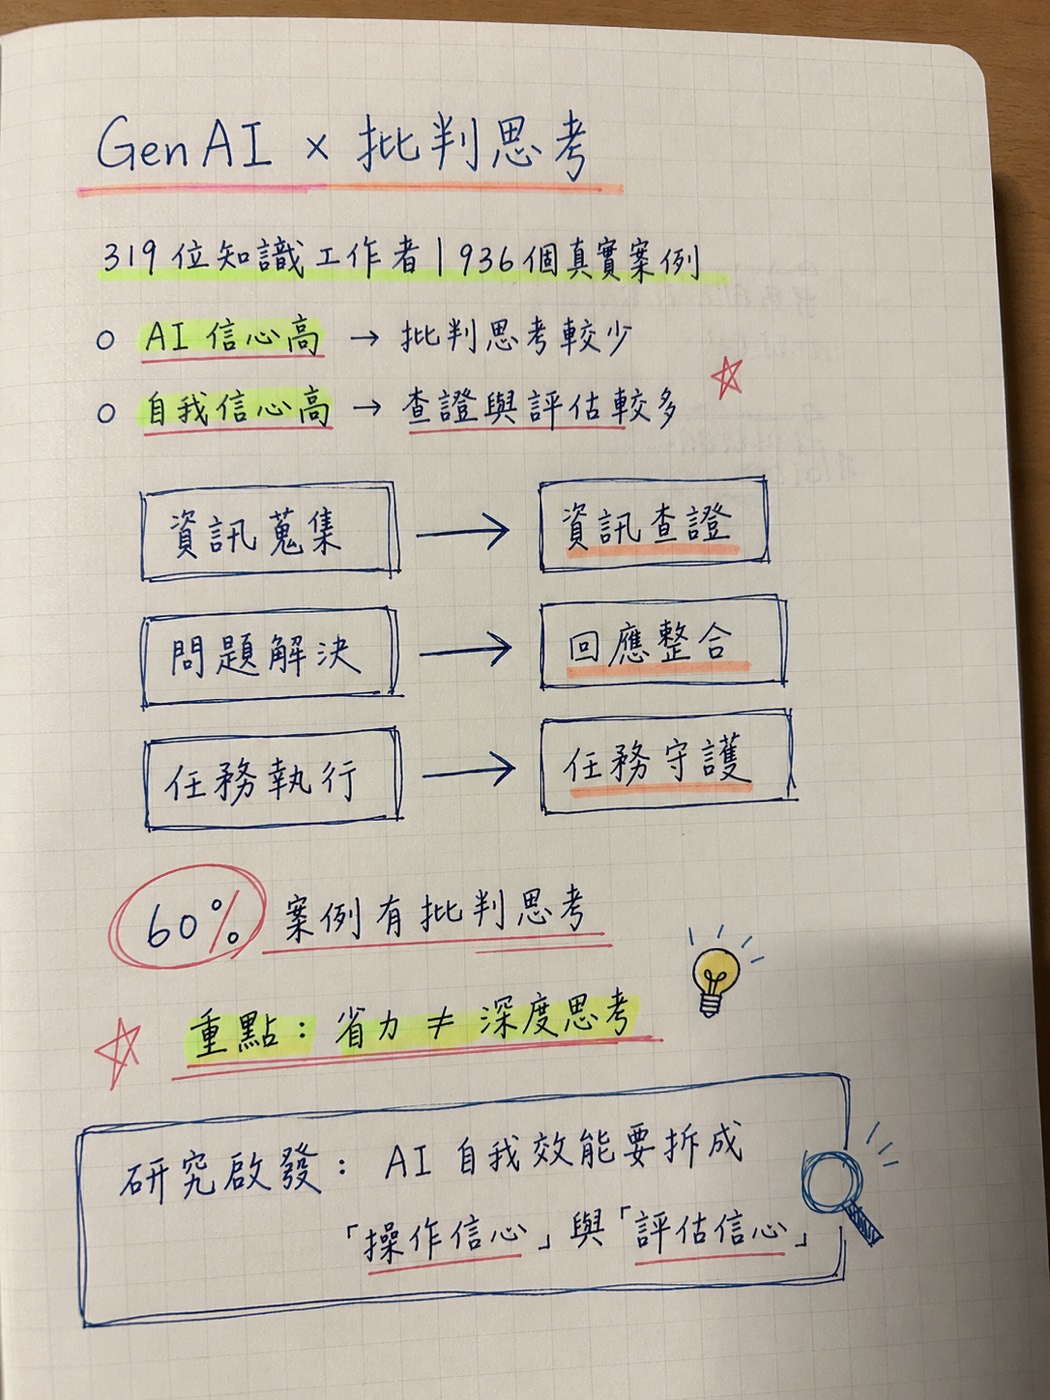
質性分析則補充兩條機制鏈。其一是 工作品質、避免負面後果、技能發展 → 願意批判思考;其二是 缺乏風險意識、時間/職責動機不足、缺乏查證與修正能力 → 放棄批判思考。作者最後把認知工作的改變整理為三種轉移:資訊蒐集轉為資訊查證、問題解決轉為 AI 回應整合、任務執行轉為任務守護(task stewardship)。
5. 假設邏輯
本文沒有正式編號的 H1–Hn,因此不能硬寫成假設支持表。作者提出的是探索性/解釋性預期:不同任務類型可能帶來不同批判要求;使用者越有信心自行完成或評估任務,越有能力辨識 AI 缺陷並投入查證;越相信 AI 能完成該任務,越可能把認知責任交給系統;一般反思傾向應提高批判行為,而一般 AI 信任可能降低投入。這些邏輯以七個混合效果模型檢驗,但結果顯示,真正有穩定關聯的不是任務大類,而是任務層級的信心配置。這也意味研究不應只問「創作、資訊或建議哪一類最危險」,而應問使用者在該次任務中相信誰、能否評估、是否願意承擔品質責任。
6. 方法
研究透過 Prolific 招募每週至少一次在工作中使用 GenAI 的知識工作者。333 份回覆中排除 14 份低品質回覆,留下 319 人;平均完成時間 43.19 分鐘,報酬為 10 英鎊。受試者提供三個不同工作案例,原始 957 例再排除內容不足、重複或非 GenAI 案例 22 例,最後為 936 例:創作 374 例、資訊 303 例、建議 259 例。96.87% 使用 ChatGPT,樣本職業包含電腦/數學、藝術設計媒體、行政支援、商業金融與教育等。
每個案例測量是否有批判思考(二元)、六種 Bloom 活動相較不用 AI 時的努力變化(-2 至 +2),以及自身做任務、AI 做任務、自己評估 AI 的信心。使用者層級另測反思傾向、一般 AI 信任與人口變數。量化分析包括一個隨機截距 logistic regression 與六個隨機截距 linear regressions,以參與者 ID 處理重複案例,並以 Benjamini–Hochberg 校正 98 個比較。質性部分由研究者先對 50 份回覆建立 codebook,再由兩位研究者編碼其餘 269 份,以協商一致處理歧見;文中沒有報告傳統的 Cohen’s kappa。
7. 結果
936 個案例中,有 555 例(59.29%)自陳曾實踐批判思考。任務類型本身沒有顯著主效應;較關鍵的是信心。對 AI 完成該任務的信心越高,批判思考實踐越少(β = -0.69,p < .001);對自己完成任務的信心(β = 0.26,p = .026)與評估 AI 的信心(β = 0.31,p = .046)則與更多批判思考相關。一般反思傾向亦呈正向關聯(β = 0.52,p < .001),而一般 AI 信任對「是否有批判思考」不顯著。
在努力方面,多數案例認為 GenAI 降低六類活動的認知努力:知識 72%、理解 79%、應用 69%、分析 72%、綜合 76%、評估 55%。AI 任務信心越高,知識、理解、分析、綜合與評估的知覺努力越低;一般 AI 信任也與知識、應用、分析及評估較省力相關。相反地,自身任務信心越高,應用與評估的投入較多。這裡只能解讀為關聯與主觀努力,不能說 AI 已造成批判思考能力衰退。
質性結果讓數字更具機制意義。批判思考的主要動機是避免負面後果(116/319)、提升工作品質(74/319)與技能發展(13/319)。阻礙包括相信/依賴 AI(83/319)、覺得任務瑣碎(55/319)、缺乏時間(44/319)、不知道如何檢查 AI(58/319),以及即使看到問題也不知道如何改進提示或回應(72/319)。因此,「省力」既可能是有效支架,也可能是沒有意識、沒有動機或沒有能力進行查證。
8. 理論貢獻
本文最重要的理論貢獻,是把「AI 讓人少思考」改寫為「AI 重分配批判思考」。它不是把所有認知工作平均削弱,而是減少資訊蒐集、初步生產與例行解題,同時增加查證、語境化整合、提示修正與品質守護。作者提出 task stewardship 比「隊友」或「主管」更準確:即使 AI 執行材料生產,責任與問責仍在人類。
第二個貢獻是拆開兩種信心:對 AI 的信心與對自己的信心不是同一條自我效能軸線。前者可能降低查證,後者可能提升整合與評估。第三個貢獻是指出能力、動機、意識三種障礙共同塑造批判行為,讓認知卸載不再只是工具效果,而是使用者—任務—組織條件的結果。
9. 實務意涵
對組織而言,AI 訓練不應只教提示技巧,還要訓練資訊查證、輸出整合與任務守護;績效制度也不能只獎勵速度,否則時間壓力會把查證變成「職責外工作」。對工具設計者,可加入可靠度線索、來源核對、反例提示、要求使用者先列品質標準、以及在高風險任務中主動觸發批判檢查。對管理者,應明確劃分誰負責生成、誰負責驗證、誰承擔最終決策責任。
最該讀這篇的人包括導入企業 GenAI 的管理者、知識管理與組織學習研究者、廣告與行銷創意團隊、教育科技設計者,以及研究 AI 自我效能、信任與過度依賴的人。實務上可把三種轉移直接做成工作流程檢核表:找到什麼來源、如何整合到情境、由誰守護結果品質。
10. 研究限制
作者承認五項主要限制:參與者可能混淆「用 AI 比較省力」與「批判思考比較省力」;主觀信心未必等於客觀專業;研究只用英語;樣本偏年輕且科技熟練;模型與使用方式快速演化,因此需要長期追蹤與更細任務測量。
我的額外判讀是:第一,橫斷自陳資料不能推論因果,且同一人同時回報信心、努力與批判行為,存在共同方法偏誤。第二,參與者在問卷開頭接受 Bloom 舉例引導,可能提高他們辨識或宣稱批判思考的機率。第三,二元的「有/沒有批判思考」過於粗糙,無法區分查證品質、深度與是否真的抓到錯誤。第四,近 97% 使用 ChatGPT,難以比較不同介面與護欄。第五,質性編碼採協商一致但未報告獨立一致性係數。第六,沒有客觀任務品質、錯誤率、延宕技能或 AI 撤除後表現,所以標題中的「reductions」必須嚴格理解為自陳認知努力降低,而非能力退化。
11. 對我研究的啟發
這篇對我的研究最有價值之處,是要求把「AI 自我效能」拆開。至少可區分:操作/提示信心、AI 任務能力信心、自身領域任務信心、以及評估 AI 輸出的信心。單一總分可能把方向相反的效果平均掉。可建立模型:操作型 AI 自我效能 → 更多使用/委派;AI 能力信心 → 較少查證;領域自我信心與評估自我效能 → 更多批判整合;最終影響創意自我效能、創新績效與輸出品質。
第二個可重用角度是把使用方式當中介,而非只用「使用頻率」:生成式使用 → 認知卸載、評估式使用 → 任務守護、對話反思式使用 → 知識整合。第三個是加入認知風格調節,例如認知反思、Need for Cognition、容忍模糊與認識論警覺,檢驗誰會把省下的搜尋努力重新投資於驗證與創新。第四個是方法延伸:在廣告從業者的真實 brief 任務中隨機操弄 AI 可靠度或強制查證介面,同時測量 AI 在場產出、過程 log、眼動/停留時間、專家評分,以及撤除 AI 後的獨立創意與判斷。
文獻定位上,它是很好的 framing paper 與構念/機制來源,也可作為訪談題綱和任務歷程編碼的 methods reference;但因非因果設計,不宜單獨作為「GenAI 降低批判思考能力」的 empirical support。最適合由我延伸的研究缺口是:不同 AI 自我效能構面在什麼條件下分別促進「委派型使用」與「守護型使用」,兩者如何經由認知投入與創意評估品質影響創新績效。
12. 整體評價
值得讀,也值得收進核心文獻,未來值得反覆回看,但引用時必須抑制因果語氣。 它最強的地方,是把 936 個真實工作案例整理成三種清楚的認知工作轉移,並揭示 AI 信心與自我信心方向相反;這能直接改善我的變數設計。最弱之處,是關鍵變數皆為同次自陳,沒有客觀能力、任務品質與長期效果。
用途上,它非常適合做 Human–GenAI collaboration、AI 自我效能與認知卸載的 framing paper,也適合作為混合方法問卷與歷程編碼的 methods reference;可提供關聯性的 empirical support,但不適合當作因果證據。若我的核心模型涉及創意自我效能與創新績效,這篇可放在「信心不是愈高愈好,而要看信的是 AI、自己,還是自己的評估能力」這個轉折位置。
最後總結
今天讀的是 Lee 等人(2025)的 CHI 論文,因為它用 319 位知識工作者與 936 個真實案例,直接說明 GenAI 如何把批判思考從生產移往查證、整合與任務守護。品質上可確認為 CHI 正式同行評審會議全文與 ACM SIGCHI 旗艦來源,但不是期刊,故 FT50/UTD24/AJG/SSCI/SCI 不適用,Scopus 個別收錄未明確確認。最可重用的角度是拆分「AI 能力信心、自身任務信心、評估 AI 自我效能」,並檢驗它們如何分別導向委派型或守護型使用。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。