文獻筆記・
AI創意把關偏誤
作者主要回答兩個問題。第一,當完全相同的創意產出被描述為 AI 製作而非人類製作時,人類是否會給予較低的創意評價?第二,若存在較低評價,是否是因為評估者認為 AI 不需要投入如人類一般的時間、體力…
- 論文
- Humans as Creativity Gatekeepers: Are We Biased Against AI Creativity?
- 作者
- Federico Magni、Jiyoung Park、Melody Manchi Chao(2024(2023 年 9 月 14 日先行上線))
- 期刊
- Journal of Business and Psychology, 39, 643–656
- DOI
- 10.1007/s10869-023-09910-x
- 分類
- 管理 AI × 創意評估 Human–AI collaboration 組織創新 認知偏誤
2. 研究問題
作者主要回答兩個問題。第一,當完全相同的創意產出被描述為 AI 製作而非人類製作時,人類是否會給予較低的創意評價?第二,若存在較低評價,是否是因為評估者認為 AI 不需要投入如人類一般的時間、體力、認知資源與動機,從而啟動「努力越少、價值越低」的努力捷思?
這個問題重要,是因為 AI 越來越能生成畫作、文字、音樂、藥物分子與商業點子,人類在創意流程中的角色可能由生成者轉為把關者。創意評價會影響資源配置、主管支持與點子能否進入實作;如果把關者因 AI 身分而低估作品,組織可能錯失有價值的創新。既有創意偏誤研究多處理人類創作者的年齡、性格或情緒等線索,尚未充分檢驗「非人類創作者」是否成為新的偏誤來源。
3. 理論基礎
第一個基礎是**創意即整合(creativity-as-integration)**觀點。作者把創意視為新穎性、適切性/有用性、品質與特定情境下真實性等相互關聯面向的整合判斷,而不是只看新奇程度。當評估標準模糊時,人們容易以創作者特徵與情境線索取代對作品內在品質的判讀。
第二是民間心理學與人工製品創造的民間理論。人類會推測行動者是否有心智、意圖、情緒與高階目的,並把這些推測帶入人機互動。由於 AI 常被認為缺乏情感、意圖與自主動機,評估者可能推論它不具備真正創意所需的心理歷程。這也與演算法厭惡相連:只要知道產出來自機器,評估標準便可能改變。
第三是努力捷思(effort heuristic)。當作品品質難以客觀判定時,人們會把創作者投入的勞動、技巧、時間與心力當作品價值的替代線索。機器通常被視為完成任務較省力,因此相同作品若標示為 AI 製作,可能先降低努力知覺,再降低創意評分。努力在此不是作品的客觀屬性,而是評估者對創作歷程的心理推論。
4. 研究架構
核心架構為:
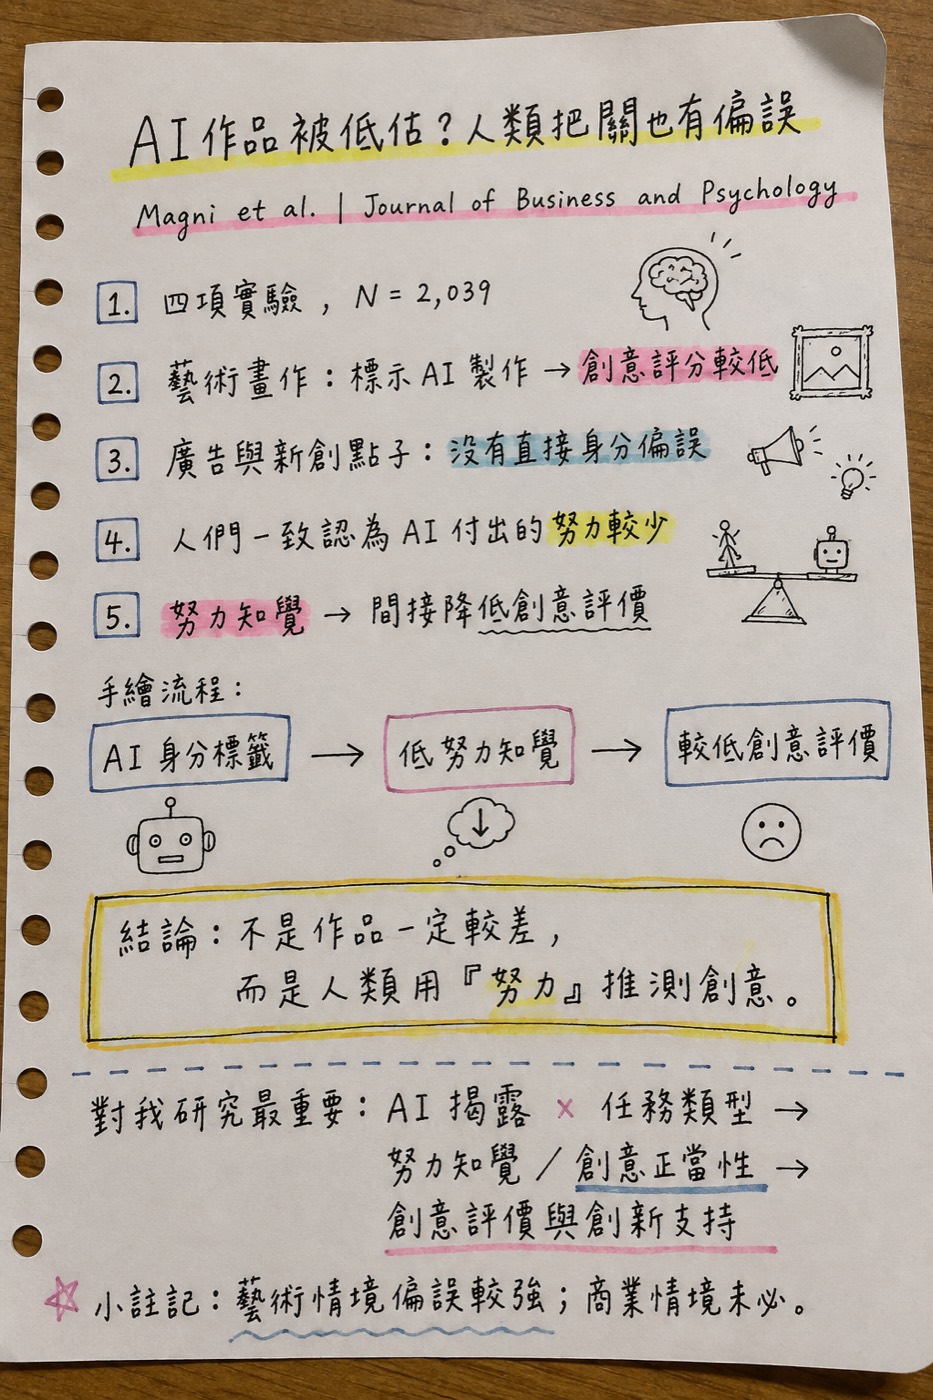
創作者身分(AI vs. 人類) → 努力知覺 → 作品創意評價
作者同時檢驗創作者身分對創意評價的直接效果,以及經由努力知覺產生的間接效果。研究四再直接操弄創作所花時間,將架構擴充為 2(創作者身分:AI/人類)× 2(努力程度:高/低),以確認努力並非只與創意評價相關,而是能因果影響評分。
跨研究的隱含邊界條件是創意領域:藝術畫作較強調真實性、意圖與人類心智,因此 AI 身分偏誤較容易啟動;廣告與新創點子偏向商業工具性,評估者可能更重視功能與適切性,因此未必出現直接的 AI 身分折價。
5. 假設邏輯
H1:AI 創作者身分會降低創意評價。 人們認為人類具有情緒、意圖與高階目標,而 AI 缺乏這些被視為創意來源的心理特徵;同時,手工/人工作品一般被賦予較高價值。因此,相同作品標示為 AI 製作時,預期得到較低創意評分。
H2:努力知覺中介 AI 身分對創意評價的負向影響。 評估者認為機器完成任務較不費力,而作品若被認為投入更多時間、體力、認知與動機,通常會得到較高價值與創意評價。因此,AI 身分會先降低努力知覺,進而間接降低創意評價。
研究四把 H2 的中介邏輯轉為操弄中介變數的因果檢驗:若高努力描述確實提高創意評價,就能排除「只是覺得好作品看起來比較費力」的反向解釋。不過作者也預期努力可能只部分解釋身分偏誤,因人類創作者的意圖、真實性與情緒仍可能有獨立作用。
6. 方法
研究一採受試者內設計,131 名香港商學院大學生各評估六幅澳洲原住民風格畫作。作者交叉平衡哪些畫作被標示為 AI 或人類作品,並以創意、真實性與品質三題五點尺度衡量創意。由於畫作評價巢套於個人,使用多層次 ANOVA。
研究二招募 303 名美國 MTurk 成人,採受試者間設計。所有人觀看五張完全相同的超市廣告海報,但被告知海報由 AI 或行銷設計師製作。創意以創意性、原創性與品質三題衡量;努力知覺以「投入很多努力/工作很辛苦」兩題衡量。作者以多層次迴歸處理 1,515 筆巢套評價,並以 5,000 次 bootstrap 檢驗中介。
研究三為預先註冊研究,招募 802 名未參加研究二的 MTurk 成人。受試者評估五個實際由 GPT-3 網站生成的新創點子,但被隨機告知來源是文字處理 AI 或有志創業者。創意量表包含創意、新穎與適切性;努力知覺擴增為時間、體力、認知與動機等六題,再以中介分析檢驗。
研究四亦預先註冊,正式樣本 808 名 MTurk 成人。每人評估五幅畫作,採畫作層次的 2×2 受試者內設計:AI/人類身分,以及低努力/高努力(用創作時間描述操弄)。正式研究前另以 100 人先導研究確認努力操弄有效。作者以多層次 ANOVA、Mplus 迴歸與 Tukey 事後比較分析。年齡、性別、教育、AI 熟悉度及領域熟悉度等在後三項研究中列為控制變數。
7. 結果
研究一支持 H1:相同畫作標示為 AI 製作時,創意評分較低(M = 3.43),標示為人類製作時較高(M = 3.65),F(1,655) = 20.93,p < .001。
研究二未支持 H1:廣告海報的 AI 組與人類組創意評分幾乎相同(3.83 vs. 3.86),p = .726。然而 H2 獲支持:AI 被認為投入的努力較少(4.11 vs. 5.32),努力知覺正向預測創意評價,間接效果 b = .29,95% CI [.210, .378]。
研究三同樣未支持 H1:新創點子的 AI 與人類身分條件沒有直接差異(3.45 vs. 3.43),p = .783。但 AI 的努力知覺顯著較低(3.38 vs. 4.56),且經努力知覺的間接效果成立,b = .25,95% CI [.202, .310]。時間、體力、認知與動機等不同努力面向分別分析時,也都呈現相同方向。
研究四再次支持 H1:畫作標示為人類製作時的創意評分為 4.27,AI 為 3.84,p < .001。高努力條件的創意評分亦高於低努力條件(4.11 vs. 4.01),p < .001,顯示努力對創意評價具有因果效果。但身分×努力交互作用不顯著;甚至「人類—低努力」仍高於「AI—高努力」,表示努力只部分解釋藝術情境中的 AI 身分折價。
整體而言,直接的反 AI 創意偏誤不是普遍法則,而是出現在兩項藝術畫作研究,未出現在廣告與新創點子研究。相較之下,「AI 被視為付出較少努力」是跨不同任務與測量方式都較穩定的心理機制。
8. 理論貢獻
第一,本文把人類從理所當然的「最終正確裁判」改寫為也會受身分線索影響的創意把關者。這補充了昨日 Bell 等人的人機分工結論:即使最終決選保留給人類,也不代表評估天然無偏。
第二,研究將努力捷思延伸到 AI 創意生產。人們不只是評作品,也在評「作品背後是否有心力」;AI 的效率優勢反而可能成為價值折價來源。第三,結果修正過度概括的演算法厭惡論:AI 身分的直接負面效果依任務領域而變,藝術情境比商業情境更強。第四,研究區分直接偏誤與不一致中介:即使總效果不顯著,AI 身分仍可透過較低努力知覺產生負向間接路徑,提醒研究者不能只看平均組間差異。
9. 實務意涵
創意主管、廣告公司、設計平台、藝文機構與使用 GenAI 的員工都應閱讀本篇。組織若要求揭露 AI 使用,也應同時建立作品本位的評分準則,分開評估新穎性、適切性、策略價值與執行品質,避免評審把「是否像人類努力」當成創意品質的替代指標。
在藝術、品牌設計或強調作者真實性的任務中,單純貼上 AI 標籤可能導致折價。較合理的揭露方式應說明人類在問題界定、提示設計、素材選擇、反覆修訂與最終判斷中的投入,讓評估者看見完整的人機共創歷程。這不是隱瞞 AI,而是避免把 AI 的運算效率誤讀為沒有創意勞動。主管也可採盲評、跨評審校準與偏誤提醒,並比較揭露前後評分是否系統性改變。
10. 研究限制
作者承認,研究採用一般化的 AI 身分描述,沒有精確操弄 AI 參與比例、介面形式、擬人化程度或人機協作方式;受試者對 AI 能力的想像可能不同。創意量表採整合觀點,雖具理論依據,仍可能遮蔽新穎性與有用性方向不一致的情況。領域比較也不是在同一研究中正式操弄「藝術 vs. 商業」,因此領域邊界仍屬跨研究推論,不是已被嚴格證明的調節效果。
額外限制包括:刺激物數量有限,且研究評估的是標籤而非真實工作流程;MTurk 與學生樣本對專業評審及企業主管的外部效度有限。研究三的商業點子實際來自 GPT-3,但人類條件是錯誤來源標示,這適合識別身分偏誤,卻不能比較人類與 AI 作品的客觀品質。研究也未檢驗評分是否真的改變資源配置、採用或創新績效。
值得特別記錄的是,摘要與一般討論報告累計 N = 2,039,但方法段所列四項樣本 131、303、802、808 相加為 2,044;正文沒有明確解釋這 5 人差異。可能涉及最終有效樣本、排除或排版誤差,但資料不足,不能自行推定。此處應以作者正式報告的累計 N = 2,039 為主要引述,同時保留書目稽核註記。
11. 對我研究的啟發
本篇可直接補進我「個人資源/情境資源 → 創意自我效能 → 創新績效」模型的評價與落地階段。創作者即使因 GenAI 提升創意自我效能並產出更好的作品,成果仍可能因 AI 身分揭露而被主管、客戶或消費者折價。可延伸為:
創意自我效能 → 人機共創投入 → AI 揭露 → 努力知覺/創意正當性 → 創意評價與創新支持
其中,任務類型(藝術/商業、享樂/功利)、人類主導程度、領域專業、AI 熟悉度與組織支持可作為調節。認知風格也有明確切入點:高分析型或學習導向者可能更能分開「作品品質」與「創作者身分」,降低努力捷思;偏直覺或高度依賴創作者故事者,可能更容易用 AI 標籤推測努力與真實性。
研究設計可採 2(AI 揭露/不揭露)× 2(人類投入說明高/低)× 2(藝術/商業任務),所有組別評估相同作品;結果變數除了創意評分,也加入預算配置、採用意願、願付價格與實際晉級決策。再測量創意自我效能、AI 素養、認知風格、努力知覺、真實性與創意正當性,即可檢驗 serial mediation 或 moderated mediation。本篇最適合作為 framing paper 與中介機制來源,也可作為 AI 揭露實驗的方法參考。
12. 整體評價
值得讀,建議納入核心延伸文獻。 它最強的地方是用「同作品、不同來源標籤」乾淨識別人類把關偏誤,並透過四項實驗、跨視覺與概念任務、預先註冊及操弄中介變數,建立努力知覺的因果鏈。結果也夠細緻:不是武斷地說所有人都排斥 AI,而是指出直接偏誤在藝術情境較明顯,努力折價則較穩定。
最弱的地方是研究完成於生成式 AI 快速普及初期,AI 定義與參與方式較粗略;領域差異並非正式調節實驗,且沒有實際組織決策者或長期創新成果。它適合當 AI 創意評估的 framing paper、機制文獻與實驗方法參考;可支持「AI 揭露 → 努力知覺 → 創意評價」的實證論證,但不宜用來主張 AI 作品客觀上較好或較差。
今日結論
今天讀的是 Magni、Park 與 Chao(2024)刊於 Journal of Business and Psychology 的正式開放取用論文。最可重用的研究角度是 AI 揭露 × 任務類型 → 努力知覺/創意正當性 → 創意評價與創新支持。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。