文獻筆記・
GenAI護欄與真正學習
作者真正要回答的不是「生成式 AI 能否幫學生當下答對」,而是兩個更嚴格的問題:第一,學生在可使用 GPT 練習時,解題表現是否提高?第二,當 GPT 被移除後,學生能否在概念相近的新題目上展現真…
- 論文
- Generative AI without guardrails can harm learning: Evidence from high school mathematics
- 作者
- Hamsa Bastani、Osbert Bastani、Alp Sungu、Haosen Ge、Özge Kabakcı、Rei Mariman(2025)
- 期刊
- Proceedings of the National Academy of Sciences of the United States of America(PNAS),122(26),e2422633122
- DOI
- 10.1073/pnas.2422633122
- 分類
- 教育 Human–GenAI collaboration GenAI × 認知卸載 學習 AI 教學護欄
2. 研究問題
作者真正要回答的不是「生成式 AI 能否幫學生當下答對」,而是兩個更嚴格的問題:第一,學生在可使用 GPT 練習時,解題表現是否提高?第二,當 GPT 被移除後,學生能否在概念相近的新題目上展現真正的獨立學習?
這個問題重要,因為教育科技常把輔助狀態下的產出誤認為能力形成。大型語言模型可能提供個別化說明與即時回饋,但也可能讓學生跳過檢索、推理、試錯與自我解釋。若只觀察有 AI 時的正確率,就無法區分「AI 替學生完成」和「AI 幫學生學會」。研究缺口因此是:缺少大規模、真實課堂、以無 AI 測驗衡量學習,並比較不同產品護欄的因果證據。
3. 理論基礎
論文沒有把單一心理理論寫成封閉模型,但其論證由四條理論脈絡構成。
第一是人力資本與技能形成。學習的價值不在當下交付答案,而在可離開工具獨立運用的能力。第二是 learning by doing 與 productive struggle:自己嘗試、犯錯、修正及解釋是知識內化的必要過程;直接取得答案會消除有助學習的「理想困難」。第三是 instructional scaffolding:有效支架應在學習者需要時提供提示、分解與回饋,但不取代核心認知活動。第四是自動化的能力侵蝕風險:工具提高短期生產率,同時可能讓使用者把任務委派給工具,導致能力投資下降。
本文最重要的理論概念可概括為「表現—學習權衡」:有 AI 時的績效與無 AI 時的能力並非同一構念,甚至可能反向變動。護欄則是將通用模型轉化為學習工具的設計機制。
4. 研究架構
研究的自變數是班級被隨機分派的學習條件:
- 控制組只能使用課本與筆記。
- GPT Base 組可使用以 GPT-4 為核心、近似一般 ChatGPT 的對話介面;系統知道當前題目,學生可要求解題協助。
- GPT Tutor 組使用相同介面,但加入教師設計的正確解法、常見錯誤與提示,並指示模型不要直接給完整答案,而要循序引導。
依變數分成兩層。第一層是輔助練習表現,衡量學生在各自資源可用時的答題品質;第二層是隨後閉卷、關閉筆電的無輔助測驗表現,題目與練習題概念相近但不相同,這才是作者用來判斷真正學習的核心結果。補充分析檢視互動訊息數、停留時間、提問是否表面化、模型錯誤、學生知覺及異質性。
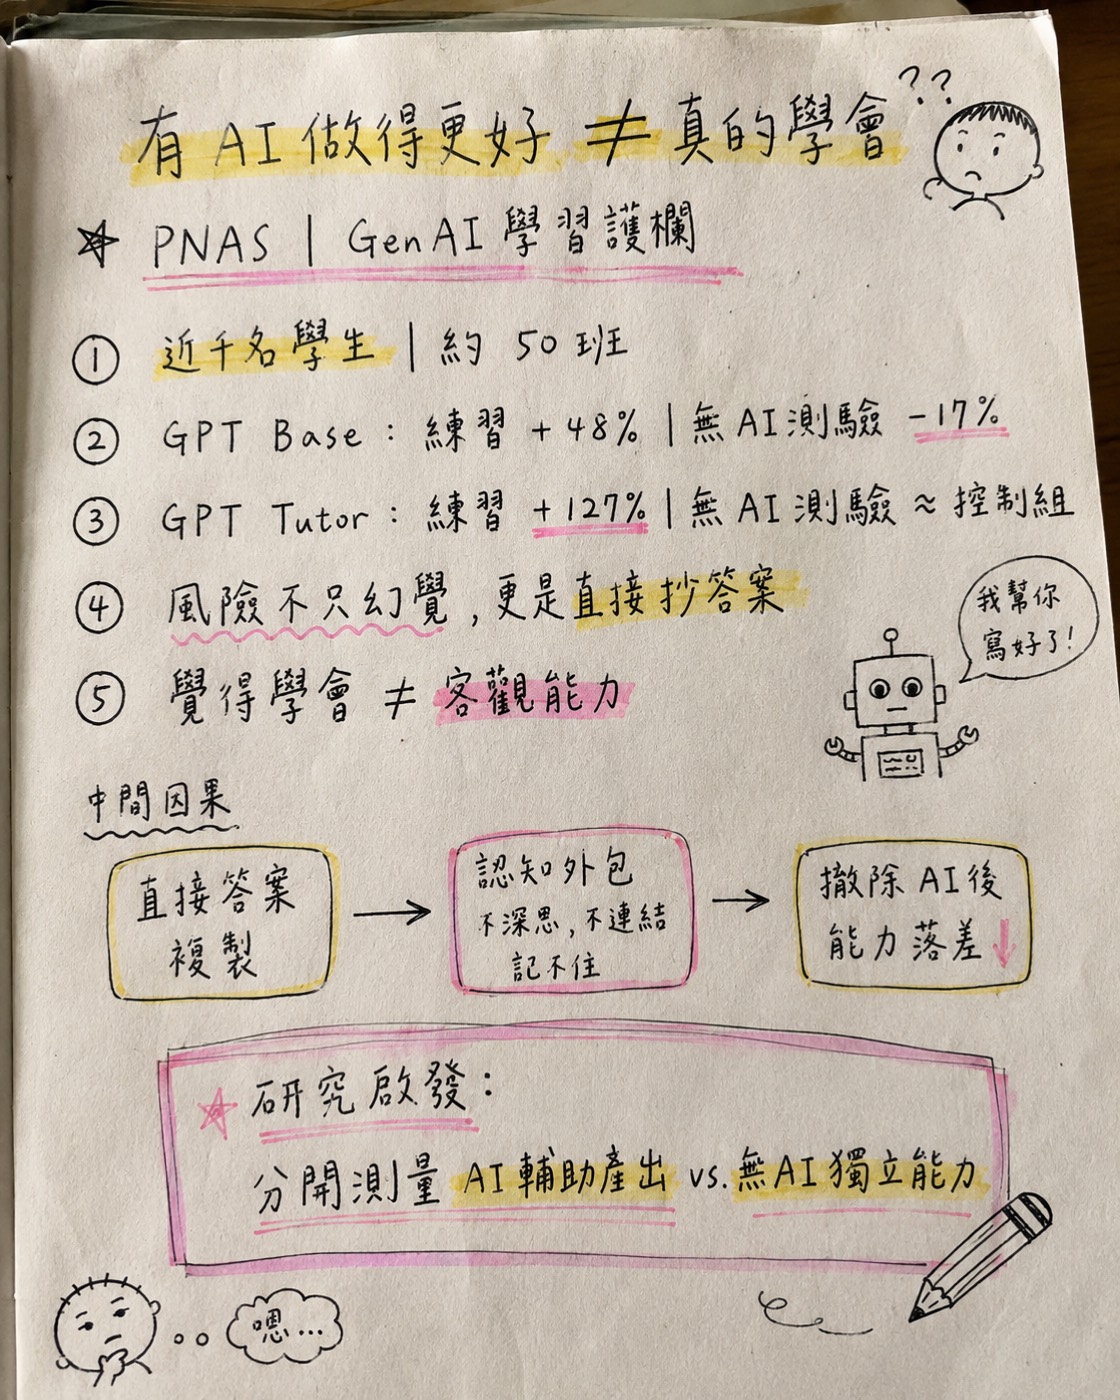
文字模型為:AI 條件 → 練習時可得答案與互動方式 → 認知投入/委派程度 → 無 AI 的獨立測驗表現;教學護欄改變中間的互動方式,預期抑制直接複製並提高實質參與。作者未正式估計完整中介模型,因此這條機制鏈是由設計與行為證據共同支持,而非已被統計中介證明。
5. 假設邏輯
本文採實驗與研究問題導向,沒有逐條編號的傳統假設,因此不應虛構 H1、H2。其推論邏輯可整理如下。
首先,GPT 能快速生成步驟與答案,故 GPT Base 與 GPT Tutor 在練習階段都應優於只用課本筆記的控制組;而納入正確解法、錯誤診斷與提示後,GPT Tutor 應比通用 GPT 更能提供與課程一致的支持。
其次,若學生把 GPT 當答案機器,練習績效雖然提高,必要的回憶、推理與自我解釋卻會減少,因此 GPT Base 在移除 AI 後可能不優於控制組,甚至更差。這是「即時輸出不是能力」的核心命題。
再次,若護欄迫使模型採提示與循序引導,學生需維持更多認知參與,GPT Tutor 應能降低或消除無護欄 GPT 的負面學習效果。不過護欄不保證一定超越傳統教學,因為學生仍可能依賴工具,且四次課程未必足以形成更高的長期能力。
最後,學生可能依據練習時的流暢感判斷自己學得更好,產生過度自信。因而主觀學習感受可能和閉卷表現分離,形成後設認知校準問題。
6. 方法
研究採班級層級隨機分派。由於筆電數量與上課排程存在限制,研究團隊以整數規劃配置約 50 個普通班至三個實驗條件;學校原有普通班的分班已具隨機性。資優班不納入主要分析,以避免原始能力與選班機制造成不均。
每次課程依相同節奏進行:教師先複習概念;學生進入可使用所屬資源的練習;最後進行紙筆、閉卷、關閉筆電的個別測驗。測驗成績計入期末成績,提高任務真實性與作答動機。練習題與考題測量相同概念,但不是直接重複,屬近遷移設計。
成果由獨立評分者依教師規準批改,評分者對條件不知情。主要意向治療分析以線性迴歸估計分派效果,控制學生先前 GPA、課次、年級、教師與評分者固定效果,標準誤在班級層級聚類。研究另分析學生問卷、完整對話紀錄、提問型態、訊息數與使用時間;並以相同題目多次測試 GPT Base 的正確性。
方法優點是把處置放進正式課堂、採實際成績而非純自陳、以關閉 AI 的考試測量獨立能力,且有預先註冊與盲評。這些設計使因果推論明顯強於一般 GenAI 接受度問卷。
7. 結果
控制組練習平均分數為 0.284。相較控制組,GPT Base 增加 0.137(SE=0.031,p<.01),約提升 48%;GPT Tutor 增加 0.361(SE=0.032,p<.01),約提升 127%。因此兩種 AI 都大幅改善「AI 在場」時的表現,帶護欄版本效果尤其大。
但無輔助測驗出現截然不同的圖像。控制組平均為 0.321;GPT Base 低 0.054(SE=0.022,p<.05),相當於下降約 17%。GPT Tutor 與控制組僅差 −0.004(SE=0.013),不顯著。換言之,無護欄 GPT 不只沒有把練習優勢轉化為能力,還使隨後的獨立解題變差;護欄則成功消除傷害,但沒有證據顯示它在短期閉卷考試上超越傳統資源。
機制證據與「認知代做」一致。GPT Base 學生較常以表面方式要求答案、互動訊息較少;第一次課程的第一個互動中,表面化提問約為 56%,GPT Tutor 為 42%。擴及所有題目的首次互動後,兩者約為 67% 與 37%。GPT Tutor 學生則有更多訊息、停留更久,也較常呈現實質嘗試。
模型錯誤並非唯一解釋。研究者對 57 題各詢問 GPT Base 十次,只有約 51% 回答完全正確,42% 含邏輯錯誤、8% 含算術錯誤;錯誤會影響練習,但未發現明確延伸到對應測驗題的顯著溢出。因此較有力的解釋是學生把模型當拐杖並跳過認知歷程,而非單純被錯誤答案教壞。
學生主觀判斷也失準。GPT Base 學生沒有察覺實際的學習傷害;GPT Tutor 學生則感到自己學得更多,即使無 AI 測驗未優於控制組。這顯示順暢、快速與高練習分數可能製造錯覺。研究也未發現穩健的測驗效果異質性;AI 在練習時縮小能力差距的現象,移除 AI 後並未保留。
8. 理論貢獻
第一,本文把 GenAI 研究中的「績效」拆成輔助績效與獨立能力,證明兩者不只不同,還可能方向相反。這對教育、人機協作與知識工作研究都很關鍵:如果只以工具在場時的產出衡量成功,會高估能力累積。
第二,研究將護欄從安全或內容審核概念,推進為學習機制設計。護欄不是單純限制 AI,而是透過不直接給答案、引用教師解法、提示常見錯誤及要求循序互動,重新配置人與 AI 的認知分工。
第三,本文補強認知卸載與自動化悖論的因果證據:AI 能同時提高短期生產力與削弱技能形成。它提醒理論建模不能把「使用頻率」視為單一正向變數,而應區分代理式委派與支架式參與。
第四,主觀效能與客觀能力的脫鉤指出後設認知校準是 GenAI 學習的重要理論環節。AI 讓任務變得流暢,卻也使使用者更難判斷哪些能力屬於自己、哪些其實由工具提供。
9. 實務意涵
教師與學校不應只問是否允許 AI,而應規範 AI 如何參與。好的工具應優先提示下一步、要求學生先作答、診斷錯誤、追問理由並延後完整答案,而不是預設提供可複製成品。課程評量也應同時保留「AI 可用」與「AI 不可用」任務,分別測量協作能力與獨立能力。
EdTech 與平台設計者應把學習結果而非互動量、完成率或滿意度列為北極星指標。教師知識庫、正確解法與常見迷思能提高教學一致性,但也增加建置成本;實務上可先鎖定高風險概念或核心能力,採漸進式護欄。
管理者與知識工作團隊也應注意同一悖論。AI 可能使報告、程式或分析立即更快,卻讓新人失去形成基礎判斷力的機會。最適合閱讀本研究的人包括教師、教學設計師、AI 產品經理、組織學習主管,以及研究 AI 自我效能、習慣使用與能力形成的學者。
10. 研究限制
作者承認研究來自土耳其單一高中、單一學科與短期四次課程,外部效度有限;不同年齡、學科、文化及模型可能有不同效果。研究發生於 2023 年,模型能力與使用者熟悉度快速變動,效應不應機械外推至所有當代模型。
結果主要是立即、近遷移的閉卷測驗,沒有延遲保留、遠遷移或長期成績,因此只能證明短期獨立學習效果。GPT Tutor 也是一個組合處置:禁止直接答案、教師解法、錯誤提示與建議提問同時加入,無法識別真正有效的單一成分。
我額外看到四個限制。第一,論文沒有直接測量認知負荷、努力或認知卸載,也未做正式中介檢驗,所以「拐杖」機制雖合理但仍屬綜合推論。第二,GPT 組在練習時使用筆電而控制組沒有,介面本身可能造成差異。第三,教師提供解法與錯誤資料的成本很高,擴張性尚未被驗證。第四,標題所稱 harm learning 應限縮為本研究情境下、無護欄 GPT 對短期獨立數學表現的傷害,不能概括為所有 GenAI 必然傷害學習。
11. 對我研究的啟發
這篇最直接的啟發,是不要把「GenAI 慣性使用」當成單一強度變數。若我的研究鏈條是校內/校外 GenAI 資源 → GenAI 自我效能 → 習慣使用 → 學習或創新結果,應把使用方式至少拆成兩類:解答委派型使用與支架互動型使用。相同的自我效能與頻率,可能透過不同認知分工產生相反結果。
一個可重用的理論模型是:GenAI 自我效能 × 教學/組織護欄 → 使用模式(委派或支架)→ 認知投入/自我解釋 → 無 AI 的獨立能力。後設認知校準可作中介或結果;任務複雜度、先備知識、認知風格與時間壓力可作調節。若研究創新,也可把結果拆成 AI 在場時的創意產出與長期問題建構能力。
研究設計上,最值得借用的是「雙重結果」:先測 AI 可用情況下的任務表現,再以無 AI 或延遲測驗測獨立能力。若只用自陳學習、滿意度或採用意圖,就無法捕捉能力侵蝕。還可加入學生對自己成績的預測,以「預測—實績差」操作化後設認知失準。
文獻角色方面,本篇可同時作 framing paper、強實證 supporting paper 與 methods reference。它尤其適合作為 research gap 的來源:既有研究多問 AI 是否提高績效,但較少問提升是否屬於使用者本身,以及什麼護欄能把短期協作轉成長期能力。若延伸自己的研究,可在大學生、教師、行銷分析師或 R&D 知識工作者中重做,並將護欄拆解成「先答後提示、蘇格拉底追問、解答延遲、來源驗證」的因子實驗。
12. 整體評價
明確判斷:非常值得讀,應收進核心文獻,也值得未來在研究模型與方法設計階段反覆回看。它最強之處不是「發現 AI 有害」這句口號,而是用真實課堂隨機實驗,把有 AI 的高產出與無 AI 的能力形成拆開,並顯示產品護欄可消除傷害。
它最弱之處是外部效度、短期結果及護欄組合無法拆解;機制沒有以直接心理測量與正式中介分析完全驗證。因此它適合做高強度 framing paper、因果 empirical support 與雙階段結果測量的 methods reference,但不應被用來證明所有 GenAI 或所有學習情境都會降低能力。
綜合評級:A 級核心文獻。最可重用的命題是:「AI 在場時的表現,不等於人離開 AI 後的能力;能否保留必要認知工作,才決定協作是否轉化為學習。」
最後總結
- 今天讀了哪篇:Bastani et al.(2025),〈Generative AI without guardrails can harm learning〉。
- 為什麼值得讀:它用課堂隨機實驗證明「AI 協助下表現」與「無 AI 獨立能力」可能背離,且比較了有、無教學護欄的 GPT。 DOI、標題、作者、既有精讀筆記與讀書帳均無重複;可能曾在其他研究文件中被引用,但未曾完成本流程精讀。
- 期刊品質/索引是否可確認:可確認 PNAS 正式同行評審、SCIE、Scopus;SCImago 近年 Q1。不是 FT50/UTD24,AJG 未另行確認。
- 最可重用的研究角度:把 GenAI 使用拆成委派型與支架型,並用「AI 在場產出/AI 離場能力」雙重結果檢驗能力累積。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。