文獻筆記・
人機共創與想法共同發展
作者真正想回答的問題不是「GenAI 能不能讓作品更有創意」,而是更動態的三層問題:第一,人類與 GenAI 反覆合作後,共同創意是否會自然持續進步?第二,如果沒有進步,究竟是哪一類共創活動隨時間…
- 論文
- Augmented Learning for Joint Creativity in Human-GenAI Co-Creation
- 作者
- Yingyue Luna Luan、Yeun Joon Kim、Jing Zhou(2025(2025 年 11 月 27 日線上正式發表))
- 期刊
- Information Systems Research(Articles in Advance)
- DOI
- 10.1287/isre.2024.0984
- 分類
- AI 應用 Human–GenAI collaboration 知識創造 創新機制 共同創意
2. 研究問題
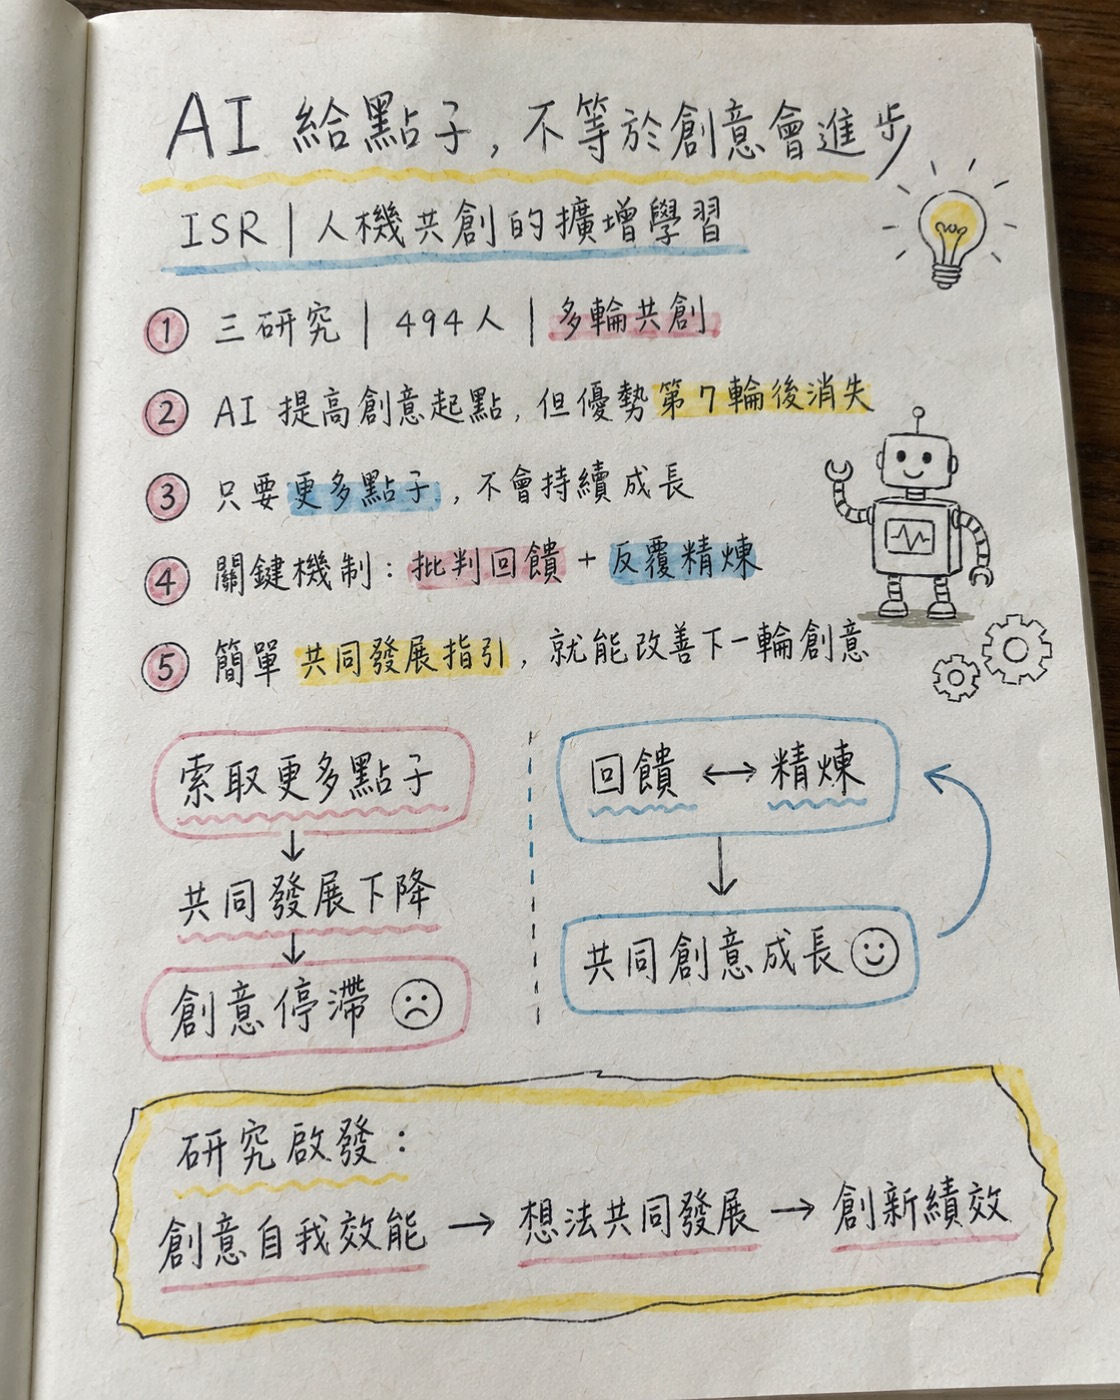
作者真正想回答的問題不是「GenAI 能不能讓作品更有創意」,而是更動態的三層問題:第一,人類與 GenAI 反覆合作後,共同創意是否會自然持續進步?第二,如果沒有進步,究竟是哪一類共創活動隨時間改變,導致創意停滯?第三,若明確教導使用者進行有效共創活動,能否讓人機團隊真正產生跨輪次的創意提升?這補足既有研究多採單次任務、只比較人類與 AI 或測量最終作品的缺口。作者認為,單輪成果只能看到合作當下,無法判斷雙方是否學會調整角色與活動配置,因此也無法解釋人機共創研究中不一致的正負結果。
3. 理論基礎
核心理論是作者重新建構的「擴增學習理論」。Engelbart 原始概念把科技視為協助個人取得資訊與學習的工具;本文則把 GenAI 視為能回應、生成、評論與修正的共創者,因此將擴增學習改寫為一種集體且跨主體的學習過程。這個過程是:人類與 GenAI 在多輪合作中,依彼此優勢與限制,持續調整在不同共創活動中的投入程度,從而讓共同創意逐步提高。
作者另援引交易記憶系統與團隊集體學習觀點,主張有效合作需要理解「誰擅長什麼」,再重新配置參與方式;也結合創意歷程文獻,強調創意不只是發散產生更多點子,還包含評估、回饋、整合與反覆精煉。本文因此擴張人機合作的空間尺度(把整體任務拆成不同共創活動)與時間尺度(觀察多輪調整),並超越靜態的「自動化或擴增」二分法。
4. 研究架構
論證架構可寫成:多輪人機共創 → 共創活動組合的變化 → 共同創意的跨輪次變化。研究二歸納出三類核心活動:一是 Idea Generation–Response,由人類提出點子、GenAI 回應;二是 Idea Request–Idea Generation,由人類要求、GenAI 產生點子;三是 Idea Co-development(想法共同發展),雙方交換批判性回饋並反覆精煉既有點子。共同發展包含兩個相互依賴的部分:回饋,以及依回饋進行擴充、整合、重新框定、簡化或加上限制條件。
研究二的機制模型為:任務輪次 → 三類共創活動的相對比例 → 共同創意。研究三再將「是否接受想法共同發展說明與範例」設為操弄,自變數是介入條件,依變數是第二輪相對第一輪的共同創意改善,並探索「實際共同發展次數」的中介角色。
5. 假設邏輯
研究一與研究二主要採歸納及溯因邏輯,沒有預先硬設完整假設。作者先檢驗人機共創的創意斜率是否隨輪次上升,再由對話資料尋找停滯機制。其推論是:若人機團隊逐漸理解彼此的能力,應該會調整共創活動並提高共同創意;反之,若活動配置沒有朝有效方式移動,重複合作本身不會自動產生擴增學習。
研究三才提出明確假設:提供「想法共同發展」的說明與操作指引,將使接受介入的人機團隊比控制組呈現更大的跨輪次共同創意改善。背後邏輯是,單純產生更多點子容易停留在廣度;批判性回饋與反覆精煉則能把初始素材轉化為兼具新穎性與實用性的方案。簡單的介入範本可降低與黑箱 GenAI 協作的不確定性,促使使用者從索取點子轉向共同評估與發展。
6. 方法
研究一招募 162 人,隨機分為人機共創組與純人類組,各 81 人,完成 10 輪社會與環境議題創意任務。人機組使用以 GPT-3.5 API 建置、temperature = 1 的聊天機器人;共取得 1,620 個人次—任務觀察值。三位評分者以共識評量技術分別評定新穎性與實用性,再將兩者相乘形成創意分數。研究以多層次模型估計「條件 × 任務輪次」交互作用,並控制年齡、性別、個人創意、日常 AI 使用與 AI 信任。
研究二招募 166 人,每人與 ChatGPT 完成三個商管情境創意任務,形成 498 個觀察值與完整對話。三位評分者以相同方式評定共同創意。研究先以多層次模型重現「人機共創沒有隨輪次進步」,再對對話進行兩階段質性編碼:先辨識 11 種活動,再整併為三種核心共創活動與雜項活動。接著將各活動出現次數除以總互動次數,計算相對比例,並以 10,000 次偏誤校正 bootstrap 的多層次中介分析檢驗跨輪次機制。
研究三以 Prolific 招募 166 人,先共同完成第一題,再隨機分派至共同發展指引組(81 人)或控制組(85 人),最後完成第二題。系統改用 GPT-4o-mini API、temperature = 1。介入內容說明批判性回饋與想法精煉的價值並提供範例。三位獨立評分者評定共同創意,研究以多層次模型檢驗條件與輪次交互作用;另編碼共同發展行為,排除互動總次數、無聊感與內在動機等替代解釋。三項研究皆在蒐集資料前完成預註冊。
7. 結果
研究一顯示條件與輪次的交互作用顯著(b = -0.34,SE = 0.16,p < .05)。純人類組在 10 輪中創意持續上升(b = 0.38,SE = 0.11,p < .001),人機共創組則沒有顯著進步(b = 0.04,SE = 0.11,p = .70)。前六輪人機組的產出明顯較有創意,但第七輪起差異消失:AI 帶來較高的起點,卻沒有形成持續成長斜率,純人類最後追上。
研究二重現人機共同創意未隨三輪改善(b = -0.20,SE = 0.27,p = .45)。隨輪次增加,想法共同發展顯著下降(b = -0.05,SE = 0.01,p < .001),另兩種點子生成活動反而增加。只有想法共同發展能顯著提高共同創意(b = 2.77,SE = 1.28,p < .05);人類先提點子或要求 AI 產生點子均不顯著。多層次中介顯示,輪次增加會透過共同發展下降而降低共同創意(間接效果 b = -0.14,95% CI [-0.31, -0.01]),另兩條間接路徑不成立。
研究三支持主要假設。指引組第二輪的共同發展次數高於控制組(2.47 對 1.20,p < .001),而「條件 × 輪次」交互作用顯著(b = 3.97,SE = 1.92,p < .05)。指引組共同創意從第一題到第二題顯著上升(b = 2.74,SE = 1.37,p < .05),控制組沒有上升;第二題時指引組也顯著高於控制組(b = 3.26,SE = 1.43,p < .05)。探索性中介效果為 1.49、p = .06,約占總效果 35%,只能視為邊緣顯著的機制線索,不應寫成已完整證實的中介。
8. 理論貢獻
第一,本文把擴增學習從「科技協助個人認知」提升為「人與 GenAI 的集體學習」,並定義為雙方跨活動、跨時間重新配置投入的演化過程。這不是替舊理論換名稱,而是因 GenAI 已從被動工具變成可參與回饋與精煉的行動者,因而需要新的分析層次。
第二,研究將抽象的人機共創拆成可觀察、可編碼、可操弄的活動單位。它顯示「人機一起做」不是單一處理條件;誰先產生點子、是否交換批判性回饋、是否反覆精煉,會形成不同的創意軌跡。第三,本文解釋既有研究結果不一致的原因:單輪研究可能只捕捉 AI 帶來的初始優勢或偶然分工,無法看到合作是否形成學習。第四,研究指出 GenAI 時代的創意瓶頸可能已從「點子數量」移向「選擇、評估與發展點子的深度」。
9. 實務意涵
組織不應把提供 ChatGPT 帳號視為創新能力建設。員工需要先理解 GenAI 擅長快速產生多樣素材、卻欠缺社會脈絡、倫理判斷與真實需求理解,再接受可操作的共同發展訓練。實務流程可要求使用者:先挑選有潛力的點子、指出優缺點、要求 AI 針對限制修正、比較不同版本、整合方案,並持續迴圈,而不是反覆要求「再給十個點子」。
對 GenAI 產品設計者,系統可主動要求使用者評估、提供修改理由、標示待加強處,或設計回饋—精煉的互動迴圈。對創意主管、廣告業與新產品團隊,績效指標也不應只看單次作品,而應追蹤多輪合作後的品質斜率與員工是否學會更好的協作方式。最該閱讀本文的是研究人機共創、創意自我效能、創新績效、知識管理或 AI 訓練設計的學者與管理者。
10. 研究限制
作者承認三項研究都聚焦文字型創意發想,未涵蓋藝術製作、技術問題解決或複雜決策;研究一、二雖包含社區參與者,仍集中於英國大學行為實驗室,樣本可能較年輕且科技經驗相近。研究三增加年齡與工作經驗多樣性,但仍是短時間線上任務。樣本數符合實驗研究慣例,卻可能不足以偵測小效果。研究使用 GPT-3.5、ChatGPT 與 GPT-4o-mini,不同模型及未來版本可能改變互動模式。
本報告另外看到四點限制。第一,研究一比較組別,研究二、三主要聚焦人機共創,跨研究任務與模型不同,整體證據是累積論證而非單一完全一致的設計。第二,研究二的中介變項來自對話編碼;雖有時序與 bootstrap,仍不是隨機化中介。第三,研究三只有兩輪,對「持續」擴增學習的驗證仍偏短。第四,共同創意以新穎性乘以實用性計算,這會放大任一構面的極端值,也無法呈現創意的多維度權衡。最重要的是,研究三探索性中介 p = .06,不能據此斷言共同發展已被嚴格證明為完整因果中介。
11. 對我研究的啟發
這篇可直接強化我目前的 個人/情境資源 → 創意自我效能 → 創新績效 模型。最有價值的延伸,是把「想法共同發展行為」加入創意自我效能與創新績效之間:創意自我效能 → 想法共同發展(回饋+精煉) → 創新績效。學習導向、數位技能、組織支持與技術支援可解釋員工是否有能力與空間進行深度共同發展;認知風格、認知需求或發散/收斂偏好則可作調節。
另一條值得發展的鏈條是:GenAI 點子供給豐富度 → 點子生成依賴/共同發展配置 → 共同創意成長斜率。這比「是否使用 AI」更能抓到創新機制。對廣告產業,可安排多輪廣告概念任務,分為直接索取點子、AI 回饋人類點子、回饋—精煉迴圈三組;每輪由盲評專家評估新穎性、策略適配與可執行性,再用成長曲線或多層次模型分析。若結合創意自我效能,可檢驗高自我效能者是否較願意批判 AI、整合脈絡並主導精煉,而低自我效能者是否更容易停留在索取點子。
文獻定位上,本篇同時適合 framing paper、核心理論來源、methods reference 與研究缺口來源。它可作為「人機共創必須研究過程與時間」的頂級期刊支撐;其對話編碼表可轉化為問項或行為指標;三研究的歸納—驗證策略則可作混合方法範本。若未來以 SPSS/PROCESS 為主,可先把共同發展行為量表化,檢驗中介或調節式中介;若能進行多輪任務,則以多層次模型或潛在成長模型更貼近原理論。
12. 整體評價
非常值得讀,應列入人機共創、知識創造與創新機制的核心文獻,並值得反覆回看。 它最強的地方是把一個高度相關但容易流於口號的概念——「人與 GenAI 共創」——拆成可觀察活動與跨時間成長,再用三項研究完成「發現停滯、找出機制、介入驗證」的證據鏈。期刊層級極高,理論命題與我的研究的創意自我效能—創新績效主軸也高度相容。
最弱之處是研究情境仍偏短期、文字發想與受控實驗,對組織內長期知識內化、團隊衝突、權責及真正市場績效尚未驗證;研究三的中介證據也僅邊緣顯著。因此,不宜把「想法共同發展」視為所有人、所有任務都最佳的唯一策略。整體而言,它是優秀的 framing paper、理論來源與方法參考,也能直接支撐實證假設;如果只能保留一篇解釋「GenAI 為何不會自動帶來持續創新」的論文,這篇值得留下。
最後總結
-
今天讀了哪篇: Luan、Kim 與 Zhou(2025),Augmented Learning for Joint Creativity in Human-GenAI Co-Creation。
-
為什麼值得讀: 它以三項研究揭露人機共創的動態機制,並從對話資料找出可介入的「想法共同發展」。
-
期刊品質/索引是否可確認: 可確認為 FT50、UTD24、AIS Basket of Eight、Scopus Q1 正式期刊;AJG 精確星等本次未明確確認。
-
最可重用的研究角度:
創意自我效能 → 想法共同發展(回饋+精煉) → 創新績效,並由認知風格或組織支持調節。
資料來源與 AI 協助聲明: 方法、數值、限制與作者主張以 Cambridge 作者接受稿及 INFORMS 正式文章頁交叉核驗;AI 協助檢索、翻譯、整理與製作讀書帳,評論性判讀已與作者證據區分。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。