文獻筆記・
AI服務補救身分揭露
作者真正想回答三個相連問題:第一,當內容來源未知時,GAI 回覆能否在服務補救品質上媲美或超越真人;第二,揭露回覆者是 AI 或人類後,顧客是否會重新評價同一段訊息;第三,這種重新評價是否隨抱怨的…
- 論文
- When customers know it’s AI: Experimental comparison of human and LLM-Based Communication in service recovery
- 作者
- Xinyue Hao、Dapeng Dong、Yuxing Zhang、Emrah Demir(2025(2025 年 7 月 29 日線上出版))
- 期刊
- Journal of Marketing Communications
- DOI
- 10.1080/13527266.2025.2540376
- 分類
- 行銷 Human–GenAI collaboration AI 服務補救 消費者信任 身分揭露
2. 研究問題
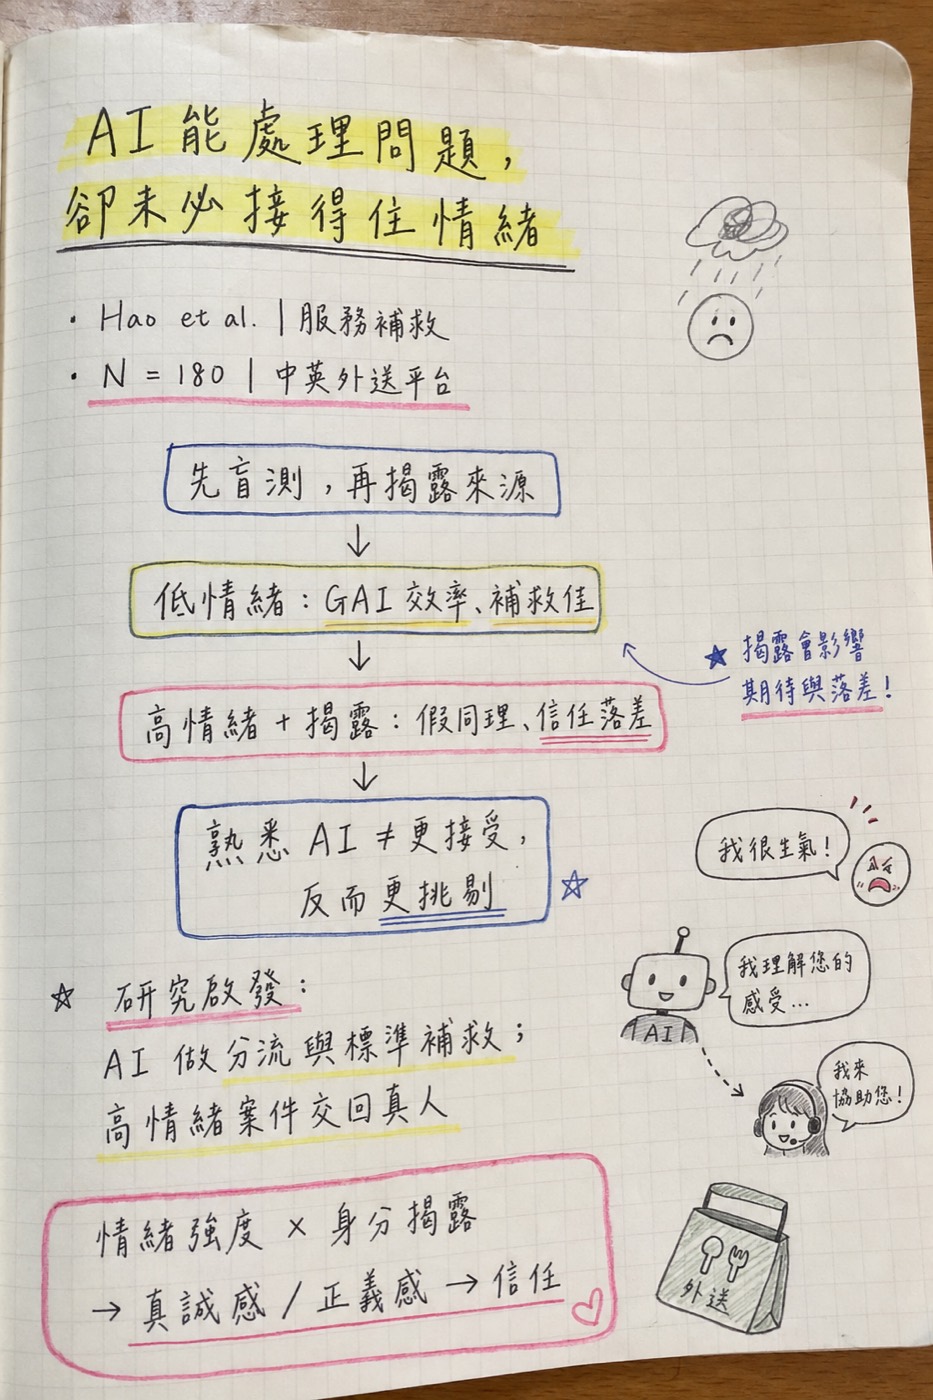
作者真正想回答三個相連問題:第一,當內容來源未知時,GAI 回覆能否在服務補救品質上媲美或超越真人;第二,揭露回覆者是 AI 或人類後,顧客是否會重新評價同一段訊息;第三,這種重新評價是否隨抱怨的情緒強度與使用者對 GAI 的熟悉度而改變。問題之所以重要,是因為過往 AI 服務研究常把接受度當成效率、易用性或回覆品質的函數,卻較少處理「說話者身分」及「情緒關係需求」如何改寫顧客對同一內容的詮釋。本文補的缺口不是 AI 能不能寫得像人,而是像人之後,是否有資格扮演需要真誠與道德承擔的關係角色。
3. 理論基礎
第一個主軸是服務補救正義理論:分配正義關注退款、補償等結果;程序正義關注速度、流程與可近性;互動正義關注尊重、同理與溝通品質。作者再以時效、協助、補救、道歉、可信度與關注等要素操作服務回覆品質。第二個主軸是 TAM,用來解釋低複雜度、低情緒任務中,AI 的速度、一致性與便利性為何可帶來工具性接受。第三個主軸是承諾—信任理論與期望確認觀點:揭露來源會重新設定顧客對回覆者的能力、意圖與真誠期待。第四個概念是服務補救悖論,但它在外送情境中並非核心被檢驗模型。作者最後提出兩個較具原創性的解釋:身分條件式信任違反與批判性熟悉;前者指 AI 身分揭露使模擬同理被視為不真誠,後者指越熟悉 AI 的人未必越接受,反而可能因期待更高而更挑剔。
4. 研究架構
可將研究架構整理為:回覆來源(真人/GAI)與抱怨情緒強度(例行/情緒高張)共同影響顧客對服務回覆的初始判斷;參與者先在來源未知時評估,再經「身分揭露」後重新評估,因此揭露是改變詮釋框架的事件。結果變數包括三類服務正義與多項回覆品質/滿意評價。人口特徵與 GAI 熟悉度另以卡方與 Cramer’s V 探索其與偏好的關聯。作者的論證鏈可寫為:回覆內容與功能品質 → 初始正義/滿意判斷;來源揭露 × 情緒強度 → 對真誠、意圖與關係正當性的重新推斷 → 揭露後信任與滿意調整。
5. 假設邏輯
原文沒有逐條提出 H1、H2 等正式假設,不能硬補不存在的假設。其推論邏輯有四項。第一,低情緒、程序性失誤主要需要速度、正確與一致,因此 GAI 可能不輸真人。第二,高情緒或高風險抱怨要求承認受害、真誠道歉與道德承擔,AI 即使使用人類式同理語言,也可能因欠缺被感知的意圖與情感投入而失分。第三,揭露來源會觸發身分類別與期待校準;同樣文字若被認為來自真人,顧客較可能推斷努力與關心,若來自 AI,則可能將同理判為表演。第四,熟悉 GAI 不必然降低不確定性並增加接受;熟悉者更知道模型的模擬本質與能力邊界,因而可能產生更高的關係期待與更嚴格的錯誤敏感度。
6. 方法
作者以 18 則公開外送平台抱怨建立刺激材料,每一情境配一則平台上的真人商家回覆與一則 GAI 回覆。GAI 使用一個標準化 prompt,明確要求兼顧三類正義與六類服務補救要素;然而原文沒有清楚交代模型名稱、版本、溫度、生成次數及回覆挑選規則。情境預先分成例行與情緒高張兩類,再分為三個 block。每位參與者於每個 block 隨機接觸六個情境之一,共完成三個情境;先閱讀抱怨與一則回覆、猜測來源並評估,再揭露真實來源並重複評分。資料於 2023 年 10 月至 2024 年 1 月蒐集,採目的抽樣,N=180;63% 來自中國、37% 來自英國,多數為 18–24 歲且具大學或研究所教育。分析包含描述統計、Pearson 卡方、Cramer’s V、Cronbach’s α、McDonald’s ω,以及適合成對次序資料的 Wilcoxon signed-rank test,另用熱圖、alluvial diagram 與長條圖呈現結果。倫理審查為 Cardiff Business School #812。
7. 結果
在來源尚未揭露的初始評估中,GAI 多數指標高於真人:互動正義滿意 70% 對 59%、程序正義 65% 對 60%、道歉 66% 對 55%、關注/吸引力 67% 對 63%、可信度 66% 對 65%、協助 58% 對 54%、補救 70% 對 58%。這顯示理論引導的 GAI prompt 容易產出結構完整、禮貌且不遺漏補償的回覆;但也意味著來源與內容品質並未被完全分離,不能把差距全解讀為「AI 身分優勢」。量表內部一致性尚可至良好,ω=.75–.88、α=.74–.85。
揭露前後的 Wilcoxon 檢定多數不顯著(p>.05),顯著例外為真人道歉 p=.002、真人分配正義 p=.007、真人互動正義 p=.004,以及程序正義中的 AI p=.03、真人 p=.01。圖形解讀顯示,揭露真人身分後,在需要道歉與個人化互動的情境中滿意度上升;揭露 AI 身分後,顧客仍承認其程序效率,但對錯誤與缺乏同理更敏感。人口與偏好分析顯示,教育與 GAI 熟悉度關聯 V=.3582,年齡為 .3262;對 AI 回覆偏好的關聯依序為教育 .3959、年齡 .389、GAI 熟悉度 .36。這些是關聯而非因果。總體證據支持「謹慎接受」:AI 在工具性任務很強,但高情緒、身分揭露後的關係評價較脆弱;熟悉者也未必更寬容。
8. 理論貢獻
本文最有價值的貢獻,是把「回覆品質」與「回覆者身分」拆成兩個評價階段,顯示顧客不是只根據字句評分,而會在揭露後重新建構說話者的意圖、責任與關係正當性。這補強了傳統服務補救理論過度著重補償、流程與表面互動品質的不足,也修正 TAM 式「有用、好用便會接受」的工具理性假設。作者提出的身分條件式信任違反,將 AI 同理失敗界定為關係真誠的破口;批判性熟悉則挑戰「AI 素養/熟悉度單調提高接受度」的線性想像。更精準地說,本文不是建立並嚴格驗證一套完整新理論,而是提出兩個有潛力的中階概念與後續研究命題。
9. 實務意涵
外送、飯店、航空、電商與觀光平台不應用單一自動化邏輯處理所有抱怨。AI 適合訂單追蹤、錯帳、更換品項、退款進度與標準券補發等低情緒、高頻程序任務;涉及疾病、羞辱、重複失誤、歧視或重大損失時,則應快速轉交真人。平台仍應透明揭露 AI,但需把它框定為「協助處理與分流的助手」,而不是冒充具情感承擔的真人。回覆設計可採作者所稱的 bounded humility:承認系統限制、避免過度擬人同理、提供明確轉真人入口。最該看這篇的是服務設計者、客服主管、旅宿與觀光平台、AI 代理產品團隊,以及研究 AI 揭露、信任和消費者決策者。
10. 研究限制
作者明示的未來研究方向,包括:追蹤長期互動中的信任變化、操弄揭露時間與框架、進行跨文化比較、納入情緒安撫需求與擬人化傾向等心理特質,以及發展角色敏感的服務模型。由此可反推本研究仍受單次、特定情境、有限個人差異與非正式跨文化比較所限。
我的額外判讀更嚴格。第一,樣本為目的抽樣且高度年輕、受教育,63% 中國與 37% 英國也未做正式多群組文化檢驗,外部效度有限。第二,GAI 回覆是依完整服務正義 prompt 生成,真人回覆則來自真實平台且常較防衛或遺漏補償,故「來源」與「內容品質」混淆;初始 GAI 優勢不能視為純粹代理人效果。第三,原文未清楚交代模型版本與生成參數,重現性不足。第四,情緒分類看似由研究者預先判定,未見獨立前測或操弄檢核。第五,多項成對檢定未清楚呈現多重比較校正與效果量;多數 p 值不顯著,討論中的「身分條件式信任違反」有部分超出直接統計證據的風險。第六,結果主要是評價與滿意,沒有真實退款選擇、再次購買、流失或口碑行為,因此因果與商業效果都需保守解讀。
11. 對我研究的啟發
這篇最可重用的研究角度是:人機協作的效果取決於任務所要求的角色,而不只是 AI 能力高低。 可以把情緒強度設為調節變數,把代理人身分與揭露方式設為實驗操弄,把感知真誠、互動正義、程序正義與信任校準設為中介,再以滿意、再購、負面口碑或創新/創意評價為結果。核心模型可寫成:AI 角色揭露 × 任務情緒強度 → 感知真誠/正義 → 信任與行為意圖。
對我的 AI 素養、數位技能、組織支援與創新研究,也有一個重要修正:熟悉度或 AI 素養不一定只有正向主效果,它可能提高品質門檻與錯誤敏感度,形成「批判性熟悉」。因此可把 AI 素養設為雙面調節:一方面提升使用與辨識能力,另一方面強化對虛假同理、低透明度或角色越界的負面反應。本文可作為 supporting paper 與 research gap 來源;兩階段盲測—揭露程序可作 methods reference。若延伸至廣告,可操弄 AI 是否只是文案助手或品牌發言者;若延伸至教育,可比較 AI 提供程序性回饋與情緒性支持;若延伸至組織創新,可研究 AI 在分析任務與關係協商任務中的角色適配。
12. 整體評價
值得讀,也值得收進核心周邊文獻,但不建議把它當成單一核心因果證據。 最強之處是兩階段揭露設計,以及把「程序信任」與「關係信任」區分開來,讓 AI 角色適配成為可操作的研究問題。最弱之處是 AI 與真人回覆內容不等質、模型細節不足、樣本偏斜,以及理論語言的力度高於部分統計證據。它適合做 AI 服務補救、揭露與真誠感研究的 framing/supporting paper,也可作為盲測—揭露設計的 methods reference;但若要支撐「高情緒必然造成 AI 反效果」或「熟悉度導致批判」的強因果主張,仍需引用更乾淨的因子實驗或縱貫研究。反覆回看價值中高,主要應回看研究設計、正義構面與未來研究命題,而不是把所有百分比當成穩健普遍效果。
最後總結
-
今天讀了哪篇: Hao、Dong、Zhang 與 Demir(2025),When customers know it’s AI。
-
為什麼值得讀: 它用盲測—揭露設計說明,AI 的功能品質與關係正當性是兩回事,並提出情緒強度下的人機角色適配問題。
-
期刊品質/索引是否可確認: 正式 Taylor & Francis 雙盲同行評審期刊;SSCI 與 Scopus 可由官方頁確認;最新分區、AJG 星等未明確確認。
-
最可重用的研究角度:
AI 身分/角色揭露 × 情緒強度 → 真誠感與正義感 → 信任/行為,並把 AI 熟悉度視為可能提高要求的雙面調節。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。