文獻筆記・
GenAI文獻回顧知識創造
作者真正要回答的是:「如何有效運用 GenAI 工具,支援資訊系統文獻回顧中的特定知識發展活動?」這個問題重要,因為多數討論只把 GenAI 用於潤稿、摘要或檢索,容易把「文字處理效率」誤認為「知…
- 論文
- Exploring the scope of generative AI in literature review development
- 作者
- Guido Schryen、Mauricio Marrone、Jiaqi Yang(2025)
- 期刊
- Electronic Markets, 35, Article 13
- DOI
- 10.1007/s12525-025-00754-2
- 分類
- 研究方法 AI × 知識創造 Human–GenAI collaboration 資訊系統研究方法 文獻回顧與理論建構
2. 研究問題
作者真正要回答的是:「如何有效運用 GenAI 工具,支援資訊系統文獻回顧中的特定知識發展活動?」這個問題重要,因為多數討論只把 GenAI 用於潤稿、摘要或檢索,容易把「文字處理效率」誤認為「知識創造」。文獻回顧不只是重述過去研究,而是要整合概念、批判假設、發展理論、辨認研究缺口並提出研究議程。既有文獻雖談到 GenAI 的幻覺、偏誤與效率,卻缺乏一套依知識活動類型判斷「什麼能交給 AI、什麼必須由研究者負責」的框架。本文補足的正是這個認識論與方法論缺口。
3. 理論基礎
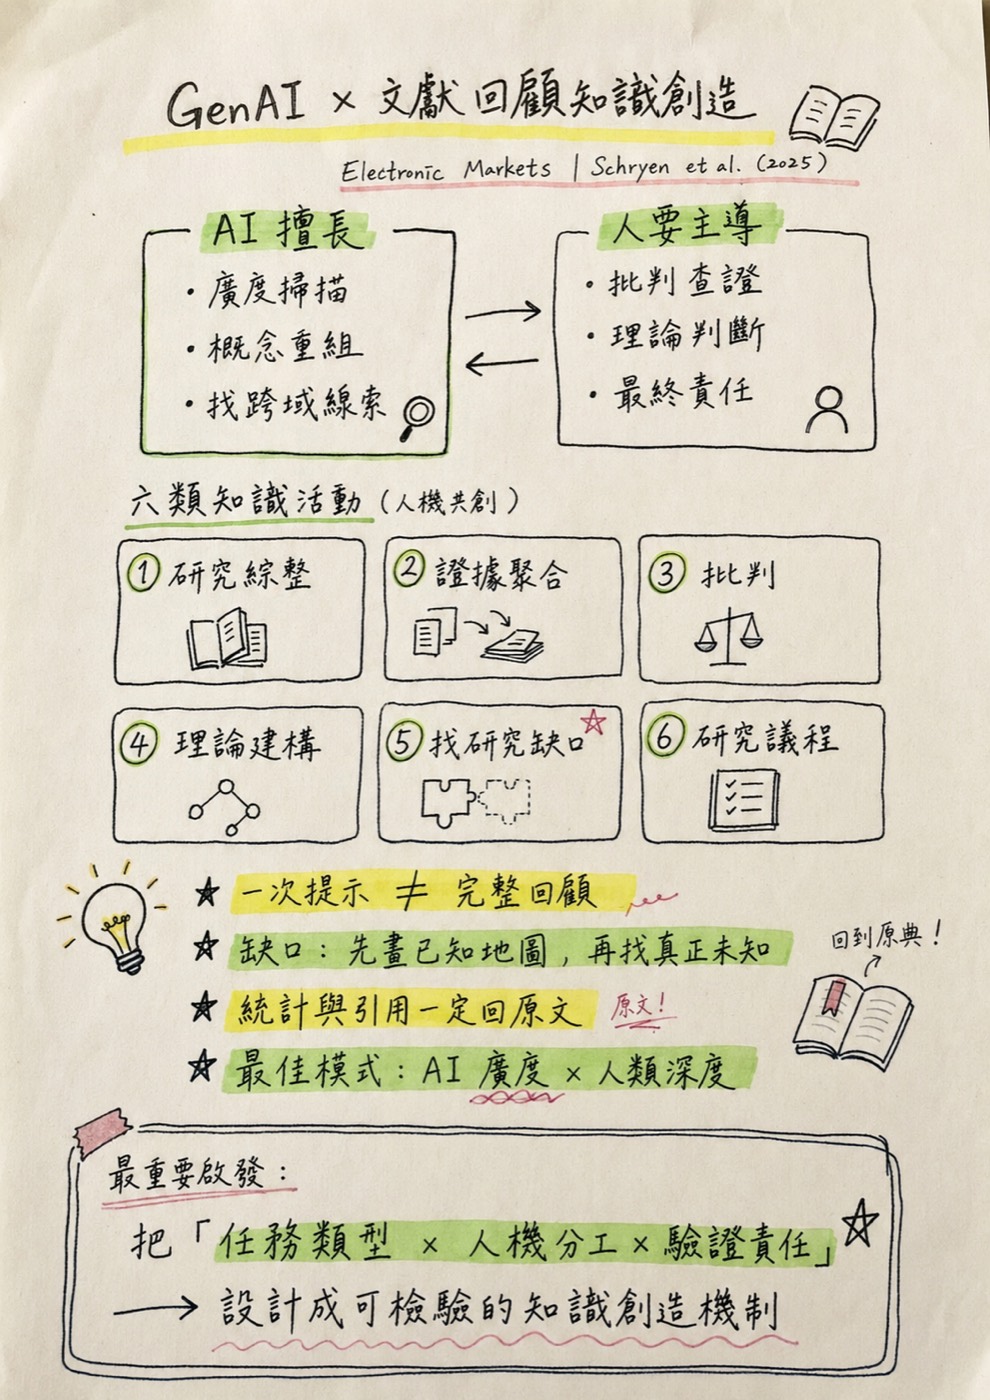
第一個理論主軸是文獻回顧的認識論分類。作者承接 Schryen 等人(2020),將知識發展拆成六種活動:研究綜整(synthesizing research)、證據聚合(aggregating evidence)、批判(criticizing)、理論建構(theory building)、研究缺口辨認(identifying research gaps)與研究議程發展(developing a research agenda)。第二個主軸是 GenAI 的生成原理與能力限制:大型語言模型擅長從既有訓練資料辨識樣式、重組文字與提供廣度,但不具有人類式理解、直覺、情境判斷與認識論模型。第三個主軸是人本協同:GenAI 應補充研究者的搜尋與重組能力,研究者則保留批判、驗證、理論選擇與最終責任。整體上,文章不是提出一個因果理論,而是建立「知識活動特性 × GenAI 能力邊界 × 人類責任」的整合框架。
4. 研究架構
文章的論證架構可文字化為:先界定文獻回顧的六種知識發展活動,再依各活動所需的認知與方法能力,對照 GenAI 的強項與限制,最後推導人機協作建議及不同回顧類型的適用性。六類活動又可區分為較偏後向的知識整理,以及較偏前向的知識創造:綜整與證據聚合主要處理既有研究;理論建構、缺口辨認與議程發展指向未來;批判則是從既有知識跨向新問題化的重要橋樑。作者以「IS business value」為示範領域,透過多個 GenAI 工具與提示案例,觀察工具如何支援不同活動。此架構沒有自變數、中介、調節或依變數,而是活動導向的能力—任務配適論證。
5. 假設邏輯
本文沒有統計假設,應改以命題邏輯理解。第一,GenAI 若主要依賴既有語料的機率式樣式重組,便較適合快速掃描、彙整、比較觀點與提供搜尋起點,而不適合被視為真理來源。第二,愈需要統計推論、深層批判、真正新穎理論或情境化判斷的活動,愈不能由純文字生成工具獨立完成。第三,AI 可以重現文獻已指出的缺口,卻難以知道「未知之未知」;因此研究缺口最好由 AI 先協助畫出已知知識地圖,再由研究者透過問題化與完整查證辨認。第五,知識品質來自互補分工,而非自動化程度最大化:AI 提供廣度與速度,人類提供深度、創造力與認識論責任。
6. 方法
研究採概念分析加示例展示。作者先從文獻回顧方法論整理六類知識發展活動與不同回顧類型,再以「資訊系統商業價值」為共同示範題材,使用 ChatGPT(GPT-4)、Perplexity(文中標示 GPT-3)、Bing AI/Microsoft Copilot(GPT-4)與 Google Gemini 1.0 Pro。作者對工具輸入多組提示,挑選具說明力的成功與失敗輸出,展示各活動的潛能與限制,再彙整成能力、限制與研究者建議表。這不是受控比較實驗:沒有固定提示集、盲評、信效度檢驗、樣本數或統計分析,也不試圖判定哪個模型最好;其證據性質屬概念性示範與方法論推論。
7. 結果
核心結果不是「GenAI 能不能做文獻回顧」的二分答案,而是能力高度依賴活動。研究綜整方面,GenAI 能快速提出多重理論視角、比較概念及提供初步文獻線索,但可能捏造引用、混用不同版本模型或受限於過時訓練資料,所有內容都要回到原始文獻核對。證據聚合方面,AI 可協助定性敘述與初步編碼,但純文字生成工具不能取代研究品質評估、效果量計算與後設分析。批判方面,AI 多半重現既有批評,較難真正問題化深層假設;它更適合協助尋找支持與反證材料。理論建構方面,AI 可提供操作化、跨領域概念與可能因果鏈,卻不能直接產生可信的新理論。研究缺口方面,直接問「有何缺口」往往只得到既有文獻已說過的清單;較可靠做法是先讓 AI 映射理論元件與已知關係,再由研究者判斷真正空白。研究議程方面,AI 可擴展設計選項,但難以自行提出具策略性、可行且具脈絡的研究藍圖。整體結論是採人本協同模式,且禁止把單次輸出當成完成品。
8. 理論貢獻
本文最重要的理論貢獻,是把「GenAI 支援研究」從工具功能層次提升到認識論活動層次。它不再籠統問 AI 是否有效,而是追問不同知識任務要求何種理解、判斷與證據,因此能解釋為何同一工具在綜整上看似強大,在理論創新與研究缺口上卻很脆弱。第二,它將文獻回顧類型重新視為六類知識活動的不同組合,使 AI 適用性可以隨任務組合判斷。第三,它提出具方向性的協同角色:研究者先當導演,界定問題、理論與資料邊界;再當監督者,驗證、修正與承擔責任。這是對人機協作與知識創造研究的活動—能力配適框架,而非單純的效率論。
9. 實務意涵
最該讀這篇的是正在做學位論文、系統性回顧、理論回顧或研究計畫的研究者,以及需要制定 GenAI 研究倫理與課程規範的教師。實務上,可把六類活動做成工作表:每個活動都記錄輸入來源、提示、模型版本、AI 輸出、原文核對、研究者判斷與修改理由。使用 AI 時應優先把它當作搜尋詞發想、概念比較、跨領域線索與初步知識地圖工具;統計聚合、關鍵引用、理論命題、研究缺口與研究議程則必須由人類以原文與方法規範完成。所有 GenAI 使用應透明揭露,以維持問責、可複製性與研究誠信。
10. 研究限制
作者明確承認三類限制。第一,文章主要依賴假設性案例與工具輸出,缺乏真實研究團隊、對照組、品質評分及長期追蹤,因此不能證明採用建議後一定提高回顧品質。第三,模型快速更新且同一模型輸出具有隨機性,今日判斷可能很快失效。額外來看,作者挑選哪些提示與輸出展示缺乏完整稽核軌跡,存在選擇性呈現;示範領域集中於 IS business value,對醫學後設分析、質性統合或跨文化管理研究的外部效度仍有限;六類活動之間在實際研究中也會重疊,分類並非完全互斥。
11. 對我研究的啟發
這篇最可直接累積到我的研究中的,不是某個量表,而是一套可重複使用的「AI 協作式知識創造流程」。可將研究歷程設計為:AI 協助建立概念地圖與跨理論候選 → 研究者核對原文並界定理論邊界 → AI 協助尋找支持/反證與不同情境 → 研究者進行問題化並形成真正缺口 → AI 協助展開設計選項 → 研究者決定可行且有理論意義的模型。這篇可作為 framing paper,用來界定 GenAI 在知識創造中的角色;也可作為 methods reference,支持文獻回顧階段的人機分工與透明揭露;更可作為 research gap 來源,因為它自己缺乏對協作流程品質的實證檢驗。若延伸成研究,可操弄協作方式(單次生成、迭代提示、人類主導驗證)、任務類型(綜整、批判、理論建構)與研究者專業程度,檢驗知識品質、理論新穎性、引用正確率與認知負荷;也可測試認知風格是否影響研究者採用 AI 建議、問題化能力與過度信賴。
12. 整體評價
值得讀,也值得收進核心文獻,但用途要放對位置。 它最強之處,是提供比「AI 幫助/傷害研究」更精細的六活動框架,能直接改造成研究流程、訪談架構或實驗操弄;最弱之處,是證據主要來自作者選取的提示案例,無法對效果大小與因果關係下結論。它適合作為 AI × 知識創造與人機協作的 framing paper,也適合作為規劃 AI 輔助文獻回顧的 methods reference;不適合作為「GenAI 已能提升理論創新」的 empirical support。未來值得反覆回看的是六活動分類、人類責任邊界與表 3 的任務建議,而不是文章中已會快速過時的特定模型表現。
今日結論
今天讀的是 Schryen、Marrone 與 Yang(2025)刊於 Electronic Markets 的開放取用正式期刊論文。期刊的 SSCI、Scopus 與 Scimago Q1 可確認,FT50/UTD24/AJG 等級未明確確認。最可重用的研究角度是「知識任務類型 × 人機分工 × 研究者認知風格 → 知識品質/理論新穎性」。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。