文獻筆記・
人機共創與創意自我效能
作者真正要回答的不是「AI 能不能寫詩」,而是:當人與生成式 AI 共同創作時,人被安排成編修者,或被安排成共創者,是否會產生不同的創意結果?其心理機制是否為創意自我效能? 此問題重要,因為許多工…
- 論文
- Establishing the importance of co-creation and self-efficacy in creative collaboration with artificial intelligence
- 作者
- Jack McGuire、David De Cremer、Tim Van de Cruys(2024)
- 期刊
- Scientific Reports, 14, Article 18525
- DOI
- 10.1038/s41598-024-69423-2
- 分類
- AI 應用 Human–GenAI collaboration AI × 創意自我效能 AI × 創新 創造力
2. 研究問題
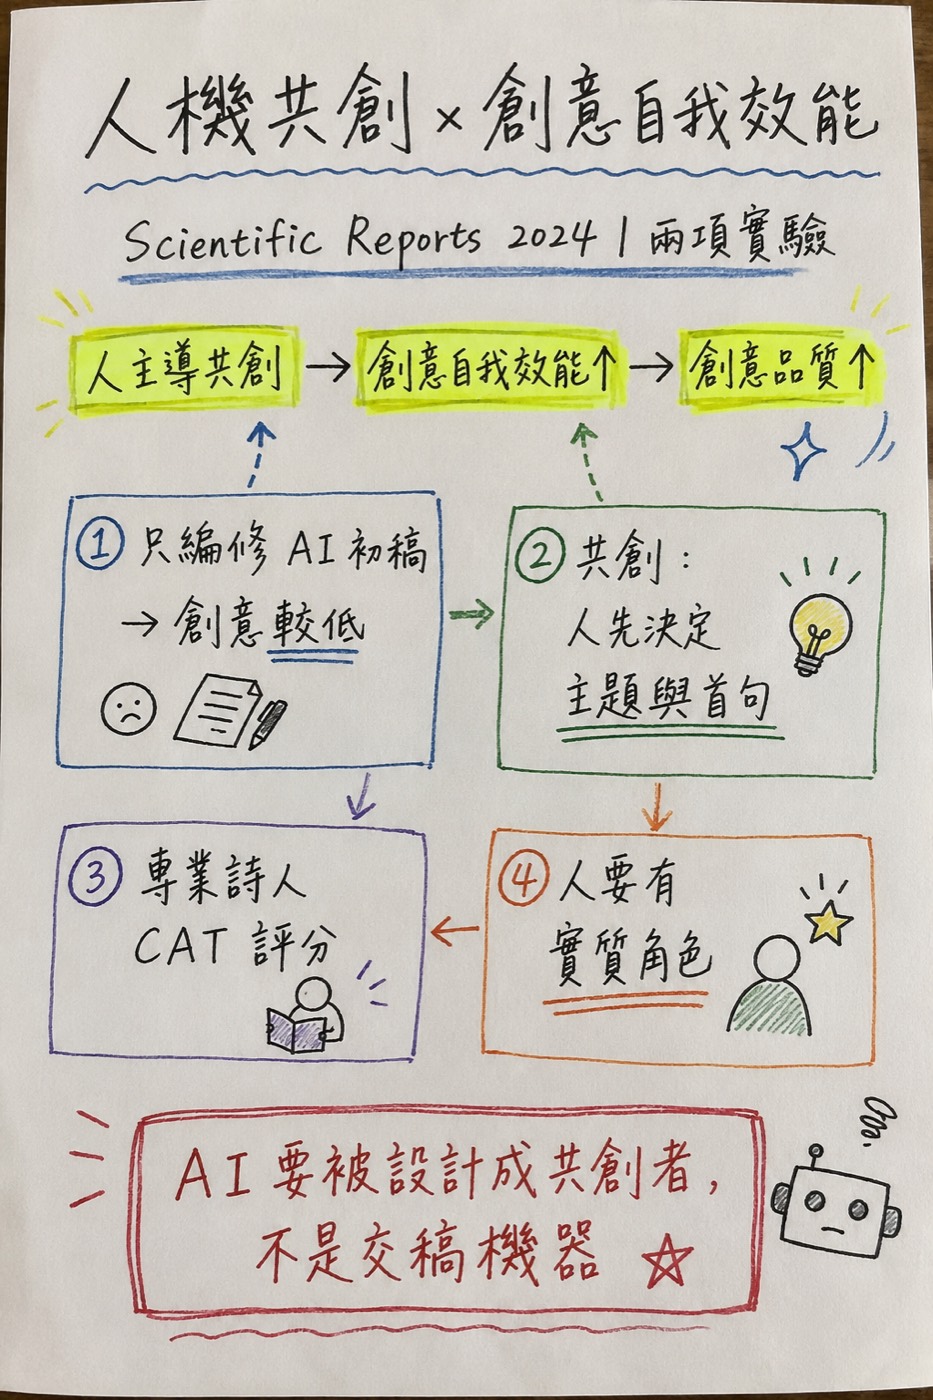
作者真正要回答的不是「AI 能不能寫詩」,而是:當人與生成式 AI 共同創作時,人被安排成編修者,或被安排成共創者,是否會產生不同的創意結果?其心理機制是否為創意自我效能? 此問題重要,因為許多工作流程把 AI 設計成先產出完整初稿、人類最後審核;這種看似有效率的安排,可能讓人只在既有內容上微調,而弱化主體感與探索。理論與實務缺口在於,既有 AI 創意研究常聚焦產出品質或工具能力,較少把「人被賦予什麼協作角色」當作可設計、可檢驗的因果變項。
3. 理論基礎
本文以創意自我效能為核心心理機制。創意自我效能指個體相信自己能有效完成創意工作的信念,作者援引 Tierney 與 Farmer 的研究脈絡,認為此信念會支持探索、冒險與投入,進而關聯創意表現。其次,論文結合角色理論與自主性觀點:若系統先給一篇完整預設文本,使用者容易把自己定位為「編修者」,其角色期待較偏分析、校正與收斂;若系統讓人先選主題、寫首句、再與 AI 輪流生成,則人較可能把自己定位為具有創作責任的「共創者」。作者亦以預設效果說明,完整 AI 初稿可能將注意力錨定在既有文字,限制發散探索。這些理論在文中共同說明:介面並非中性容器,而是會塑造角色感、自我效能與創作行為的安排。
4. 研究架構
研究架構可寫為:AI 協作設計/人類角色(無 AI 獨作 vs. AI 先寫、人類編修 vs. 人先啟動、與 AI 逐句共創)→ 創意自我效能 → 創意表現。依變數包含參與者對自己詩作的創意自評,以及由專業詩人評定的客觀創意品質。研究一先建立基準:比較人類獨作、AI 先完成後供人自由編修、以及 AI 自動生成。研究二再將關鍵對照放在「編修者」與「共創者」:兩者皆使用同一詩句生成系統,但共創介面讓人選擇主題、先寫第一句,之後與 AI 交替寫作並可修改;作者進一步檢驗創意自我效能的中介。
5. 假設邏輯
研究一的推論是:即使給予使用者不少編修功能,若任務從 AI 的完整預設詩稿開始,人仍可能受預設內容與編修角色限制,因此自評與專家評定的創意都低於人類獨作。研究二的主要命題則是:相較於編修 AI 初稿,讓人主導主題與首句、再與 AI 交替生成,會提升創意自我效能,並使創作成果回到接近人類獨作的程度;創意自我效能應中介「共創者而非編修者」對專家創意評分的正向影響。作者沒有把「人機協作必然優於人類獨作」當成假設,反而預期好的共創設計能消除編修型協作的劣勢,這是本文較精確之處。
6. 方法
研究一從 Prolific 招募 101 人,扣除 6 位未通過注意力檢核者後,分析樣本為 96 人;人類獨作與人類-AI 編修條件各 48 人,另有 50 篇 AI 自動生成詩作作為基準。任務為完成 8 行、兩段式英文詩。人類-AI 條件先收到 AI 完整詩作,可直接編輯、替換候選行或重寫。研究二從 Prolific 招募 152 人,隨機分派至人類獨作(51 人)、編修型人類-AI(50 人)與共創型人類-AI(51 人)。共創型介面要求參與者先選主題詞並寫第一句,之後與 AI 輪流寫句。研究二以三題創意自我效能量表衡量中介變項(α = .92)。兩項研究皆由 10 位專業詩人以 CAT 對所有詩作盲評;統計上使用 t 檢定、單因子 ANOVA、事後比較,以及 PROCESS Model 4、10,000 次 bootstrap 的中介分析。資料與語法檔亦公開於 OSF,提升可檢核性。
7. 結果
研究一顯示,單純把 AI 產出的完整詩稿交給人類編修,並未增進創意。人類獨作組的創意自評高於編修型人類-AI 組(23.88 vs. 19.13,p = .016);專家評分亦呈顯著差異,獨作(18.23)高於編修型協作(12.55),而編修型協作又高於 AI 全自動(9.45)。研究二中,共創型協作的創意自我效能(4.62)顯著高於編修型協作(3.74),且與人類獨作(4.71)無顯著差異。專家創意評分上,共創型(14.70)顯著高於編修型(12.53),並與人類獨作(15.74)無顯著差異。中介分析顯示,將人從編修者改為共創者,會透過更高的創意自我效能提升專家創意評分(間接效果 B = 0.78,95% CI [0.16, 1.68])。結果的意義是:AI 的效果取決於協作編排;不是有 AI 就好,而是人是否仍握有創作起點與實質貢獻空間。
8. 理論貢獻
本文最重要的理論貢獻,是把人機創意協作從「工具是否能產生好內容」轉為「角色與介面如何配置人類能動性」。它將創意自我效能引入 GenAI 協作的因果機制,指出 AI 先寫、人後修的常見流程,可能透過角色限縮與預設錨定降低人的創作信念;反之,交替生成與人類先啟動可維持該信念與成果。第二,研究以專家盲評的創意品質佐證,而非只以主觀滿意度宣稱效果。第三,它為人本 AI/HCI 的主張提供一個可操作的設計原則:保留人類在目標設定、起始創作與迭代決策中的實質位置。它不是提出全新宏大理論,而是將自我效能、角色理論與創意評量整合到具體 GenAI 介面設計中,這正是其可用性。
9. 實務意涵
對廣告、設計、內容行銷、服務創新與創意教育而言,最直接的啟示是避免把 GenAI 導入成「先交一版完整答案,員工只負責潤飾」的交稿機器。較佳作法是讓使用者先界定問題、目標客群或創作主題,先提出一個想法/首句,再由 AI 回應、提供變體並接受反覆修訂。對管理者,這表示 AI 導入 KPI 不應只看速度與產量,也應追蹤員工的主體感、創意自我效能與長期能力累積。對教師與高等教育設計者,可把 AI 寫作活動改成分段共創與反思歷程,而非直接交出 AI 完成稿。最該讀這篇的是設計 GenAI 工作流程的人、創意團隊主管,以及研究 AI 協作與創新績效的學者。
10. 研究限制
作者明確指出四項限制:第一,實驗室式線上詩作任務未必等同真實職場或教室的複雜創作;第二,未檢驗長期反覆使用的效果,無法判斷自我效能是否持續、消退或形成去技能化;第三,未把寫作專業程度當作邊界條件;第四,採用的並非當前最新大型語言模型,結果是否適用 GPT-4o、Claude 等系統仍待驗證。另就本研究判讀,詩作是高度特定的創意任務,外推到廣告策略、產品創新或組織知識創造時,任務評分標準與利害關係不同;共創條件同時改變了人類先後順序、主題控制權與互動節奏,因此雖然具有真實設計意義,仍不易拆出究竟是哪一個微觀元素造成效果。專家 CAT 評分是優點,但十位詩人對「創意」的共識未必能涵蓋商業效用或市場新穎性。
11. 對我研究的啟發
此文可直接作為「協作角色/人類主導性 → 創意自我效能 → 創新績效」的 framing paper 與實證支持。若延伸至廣告或行銷創意,可將自變數從單純「是否使用 GenAI」改為協作結構,例如 AI 先稿後修、Socratic prompting、輪替共創、共同目標設定;中介除創意自我效能外,可測量 idea ownership、心理自主性、認知彈性或 AI 依賴;依變數則以創意新穎性、策略適切性、提案品質與創新行為組合衡量。研究設計可借用其三組實驗與 CAT,但改由業界創意總監、消費者或盲評專家評估廣告腳本/行銷提案,並搭配使用歷程資料(prompt、修訂輪次、採納率)。可進一步檢驗領域專業、AI 素養、認知風格、任務曖昧性或組織創新氣候是否調節效果。最關鍵的改寫是:不要把 GenAI 使用量當作核心解釋,而要把「人是否仍被安排為創意主體」視為機制的起點。
12. 整體評價
值得讀,也值得收進核心文獻。 它最強之處在於研究問題明確、操弄貼近真實 GenAI 介面決策、兩項實驗相互遞進,並以專家盲評與中介分析避免只談感受。對我而言,這是非常適合反覆回看的 framing paper 與 empirical support:它能支持「人機協作品質」比「是否用 AI」更重要的論點,也提供可複製的創意評量方法。最弱之處是研究情境窄、樣本為線上英文使用者,且 AI 技術迭代很快;因此不宜直接視為「所有 GenAI 都會如此」的普遍因果結論。它不太適合作為大型組織採用或長期創新績效的唯一方法參考,但非常適合支撐協作角色、主體性、創意自我效能與創意產出的實驗研究。
今日結論
今天讀的是 McGuire、De Cremer 與 Van de Cruys(2024)的 Scientific Reports 正式期刊論文。最可重用的研究角度是:將「GenAI 使用」細分為「協作角色與人類主導性」,以創意自我效能作為中介,再檢驗創意或創新績效。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。