文獻筆記・
人們為什麼願意相信演算法:熟悉度的三種面向
這篇最核心的問題是:人們為什麼願意相信並採用演算法建議?作者特別想拆開「熟悉度」這個常被混在一起的概念,區分成對演算法本身的熟悉、對任務的熟悉,以及對演算法績效的熟悉,檢驗它們如何影響信任,再由信…
- 論文
- Decoding algorithm appreciation: Unveiling the impact of familiarity with algorithms, tasks, and algorithm performance
- 作者
- Hasan Mahmud, A.K.M. Najmul Islam, Xin (Robert) Luo, Patrick Mikalef(2024)
- 期刊
- Decision Support Systems, 179, 114168
- DOI
- 10.1016/j.dss.2024.114168
- 分類
- 管理
1. 基本資訊
作者為 Hasan Mahmud、A.K.M. Najmul Islam、Xin (Robert) Luo、Patrick Mikalef,2024 年發表於 Decision Support Systems。DOI: 10.1016/j.dss.2024.114168。本文主題落在 AI 決策採納、信任形成與演算法接受,與管理及 AI 應用研究高度相關。
2. 研究問題
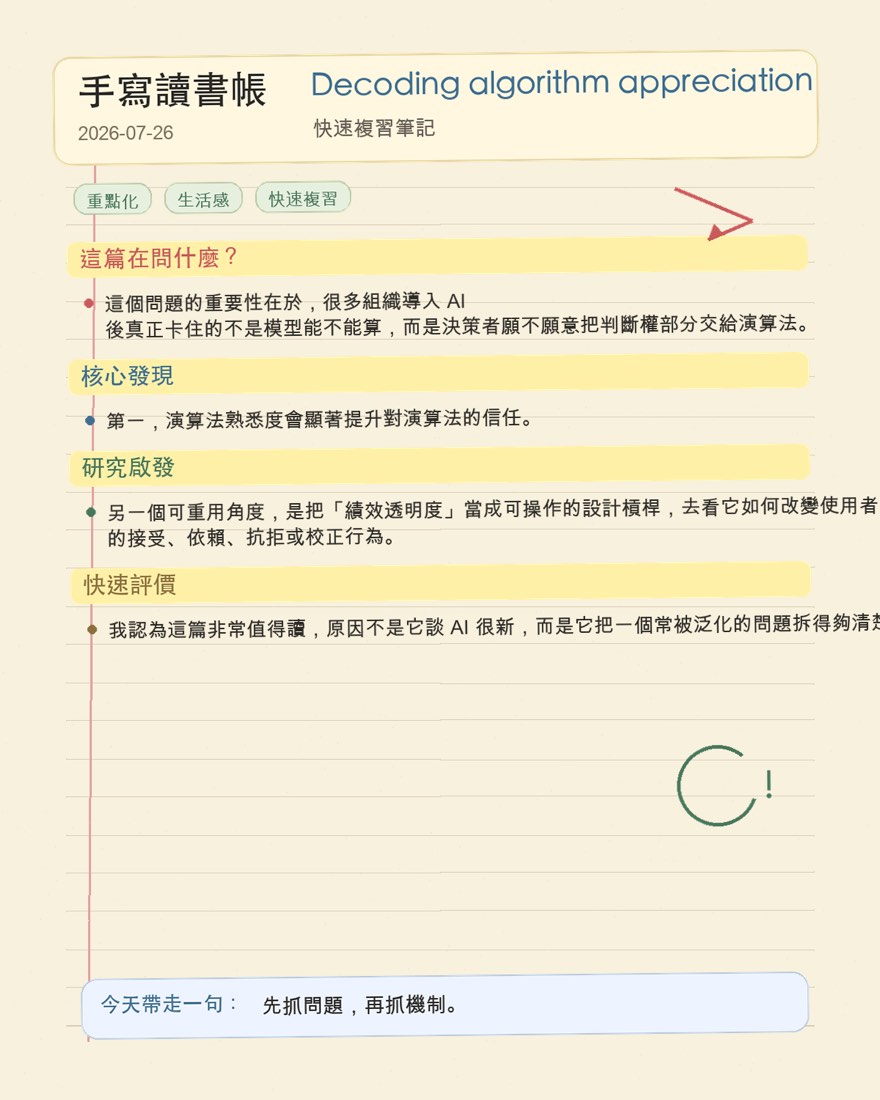
這篇最核心的問題是:人們為什麼願意相信並採用演算法建議?作者特別想拆開「熟悉度」這個常被混在一起的概念,區分成對演算法本身的熟悉、對任務的熟悉,以及對演算法績效的熟悉,檢驗它們如何影響信任,再由信任推動 algorithm appreciation。這個問題的重要性在於,很多組織導入 AI 後真正卡住的不是模型能不能算,而是決策者願不願意把判斷權部分交給演算法。
3. 理論基礎
理論上,本文站在信任理論與演算法接受研究的交界處。作者將信任視為降低不確定性與黑箱焦慮的核心心理機制,並把 familiarity 視為信任形成的重要前因。論文也回應了 algorithm aversion / appreciation 文獻中的張力:人們一方面知道演算法可能更準,另一方面又可能因不透明、缺乏控制感或對自身專業過度自信而不願採用。
4. 研究架構
整體架構很清楚:前因變數是演算法熟悉度(FA)與任務熟悉度(FT),中介變數是對演算法的信任,結果變數是演算法讚賞或依賴傾向。另有一個關鍵調節變數是對演算法績效的熟悉程度(FP),作者用它來檢驗「知道演算法表現好不好」會不會改變熟悉度與信任之間的關係。這是一個典型的前因-中介-結果,加上邊界條件的模型。
5. 假設邏輯
作者的推論邏輯是:如果使用者更熟悉演算法如何運作,就較容易形成能力判斷與可預測感,因此更願意信任它;如果更熟悉任務本身,理論上也可能更願意接受好的決策工具,但也可能因為過度相信自己而不靠演算法,所以這條路徑方向在文獻上有爭議。至於績效熟悉度,若使用者明確知道演算法表現優異,就會強化熟悉演算法所帶來的信任效果。最後,信任被視為真正把認知熟悉轉成採納行為的關鍵橋梁。
6. 方法
研究採 vignette-based 線上情境實驗,透過 Prolific 招募 327 位受試者。情境設定在股票預測決策,受試者需要判斷是否依賴演算法建議。研究者操弄的是演算法績效資訊是否明確可知,並量測受試者對演算法的熟悉度、對任務的熟悉度、對演算法的信任,以及最終的 algorithm appreciation。分析方法以結構方程模型為主,另有事後分析處理中介效果。
7. 結果
最重要的結果有四個。第一,演算法熟悉度會顯著提升對演算法的信任。第二,任務熟悉度對信任沒有顯著影響,表示懂任務不等於會更信演算法。第三,信任會顯著提升 algorithm appreciation,且是模型中最關鍵的近端驅動因子。第四,當受試者更清楚知道演算法績效時,演算法熟悉度對信任的正向效果會更強。事後分析還顯示,信任完全中介了演算法熟悉度對 algorithm appreciation 的影響。
8. 理論貢獻
本文最大的理論價值,是把過去常被混稱的 familiarity 拆成不同層次,並證明不是所有熟悉都有效。真正有力的是對演算法本身的熟悉,而不是單純的任務經驗。第二,它把 trust 明確放到核心位置,說明熟悉度不會直接自動變成採納,而是必須透過信任轉換。第三,作者補上了績效透明度這個邊界條件,讓 algorithm appreciation 研究從「有沒有厭惡」更進一步走向「在什麼條件下更容易被接受」。
9. 實務意涵
對組織導入 AI 來說,這篇最實用的提醒是:不要以為只要員工很懂業務,就會自然接受 AI。比起只做任務訓練,更重要的是提升使用者對演算法邏輯、用途與限制的理解,並用清楚的績效證據建立信任。換言之,AI 導入不只是技術部署,而是信任設計。若組織希望提升 AI 決策工具的採納率,應優先投資於可解釋溝通、績效揭露與使用者教育。
10. 研究限制
限制主要有三個。第一,研究情境集中在股票預測,屬於特定決策場域,能否外推到醫療、教育或人資仍需再驗證。第二,情境實驗能控制變數,但與真實組織採納行為之間仍有落差。第三,本文聚焦的是個體層次知覺與信任,較少處理制度壓力、組織文化、責任歸屬等更高層次因素。
11. 對我研究的啟發
這篇對我的最大啟發,是可以把「AI 採納」拆成更細的認知前因,而不是只用單一的 perceived usefulness 或 attitude 去解釋。若我之後做管理、教育或 AI 應用研究,可以直接借鏡作者的拆法,把 familiarity 區分成技術熟悉、任務熟悉、績效熟悉,並檢驗 trust 是否是中介核心。另一個可重用角度,是把「績效透明度」當成可操作的設計槓桿,去看它如何改變我對 AI 的接受、依賴、抗拒或校正行為。若延伸到教育場景,也可以改問學生或教師是否因了解 AI 的表現邊界而更願意讓 AI 介入學習與評量。
12. 整體評價
我認為這篇非常值得讀,原因不是它談 AI 很新,而是它把一個常被泛化的問題拆得夠清楚、夠可操作。研究設計不複雜,但理論聚焦明確,結果也有直接可用的管理含義。若拿來支撐「組織如何提升 AI 採納」或「我如何形成對 AI 的信任」這類研究,它是很好引用的機制型文獻。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。