文獻筆記・
生成式 AI 能幫忙評估策略決策嗎
這篇核心在問一個很實際但也很難的問題:生成式 AI,尤其是大型語言模型,能不能拿來評估高度不確定、而且一旦選錯就很難回頭的策略決策?作者不是在問 LLM 能不能「產生」新點子,而是問它能不能像評審…
- 論文
- Generative artificial intelligence and evaluating strategic decisions
- 作者
- Anil R. Doshi, J. Jason Bell, Emil Mirzayev, Bart S. Vanneste(2024)
- 期刊
- Strategic Management Journal, 46(3), 583-610
- DOI
- 10.1002/smj.3677
- 分類
- 管理
1. 基本資訊
作者為 Anil R. Doshi、J. Jason Bell、Emil Mirzayev、Bart S. Vanneste。DOI 為 10.1002/smj.3677,刊登於 Strategic Management Journal,頁碼為 46(3):583-610。本文屬於 management / strategy / AI applications 的交會主題,直接處理生成式 AI 能否協助評估策略決策。
2. 研究問題
這篇核心在問一個很實際但也很難的問題:生成式 AI,尤其是大型語言模型,能不能拿來評估高度不確定、而且一旦選錯就很難回頭的策略決策?作者不是在問 LLM 能不能「產生」新點子,而是問它能不能像評審或策略顧問一樣,判斷多個替代方案中哪個更有成功機會。更具體地說,作者檢驗單一 LLM 的判斷是否可靠,以及當多個模型、角色與提示被聚合時,AI 排名能否接近人類專家的排序。
3. 理論基礎
理論上,本文站在兩條脈絡上。第一條是策略管理中的 strategic foresight 與 decision evaluation,強調策略決策通常伴隨高不確定性、承諾成本與不可逆性,因此「事前評估哪個方案更好」本身就是策略能力。第二條是 wisdom of the crowds,也就是當個體判斷各自帶有誤差時,適當聚合多個不完美預測,反而可能產生比單一判斷更好的整體結果。本文的重要轉折在於:把這個本來多用在人類評估者身上的聚合理論,移植到「人工評估者」上。
4. 研究架構
作者把 LLM 視為一種 artificial evaluator,並以 pairwise evaluation 作為基本評估單元。也就是每次把兩個 business model 放在一起,請 AI 判斷哪一個更可能成功。研究架構的三個可操弄維度分別是:不同 LLM、不同 assumed roles、不同 prompts。之後再把大量單次判斷向上聚合,形成三種層次的評估者:單一來源的 uniform AI evaluator、混合多來源但規模受控的 mixed AI evaluator,以及整合全部 37,878 次判斷的 comprehensive AI evaluator,最後與人類專家的排名比較。
5. 假設邏輯
本文雖不是傳統逐條列式假設的寫法,但推論邏輯非常清楚。第一,單一 LLM 對策略方案做成對判斷時,容易受到順序與位置偏誤干擾,因此單次輸出不夠穩。第二,如果這些錯誤並非完全同方向,而是帶有可互相抵銷的雜訊,那麼跨模型、跨角色、跨提示進行聚合,理論上應能提升與專家判斷的一致性。第三,聚合提升可能來自兩種來源:多樣性效應與規模效應。作者進一步推論,在這類任務中,單純增加評估次數的 scale effect,可能比只增加來源差異的 diversity effect 更有力。
6. 方法
研究包含兩個 study。Study 1 使用 60 個 AI 生成的 business models,涵蓋 10 個產業,並請人類專家建立基準排名;Study 2 改用真實創業競賽中的 60 個 business models,以競賽評審分數作為外部效標,用來檢驗外部效度。AI 端則使用多個 LLM、不同角色設定與不同提示方式,對每一對 business models 進行 repeated pairwise comparisons。接著作者用 win proportion 建構各方案排名,再分別比較 Pearson correlation、Spearman correlation、top choice 與 bottom choice 等指標,並拆解 diversity 與 scale 兩種聚合效果。
7. 結果
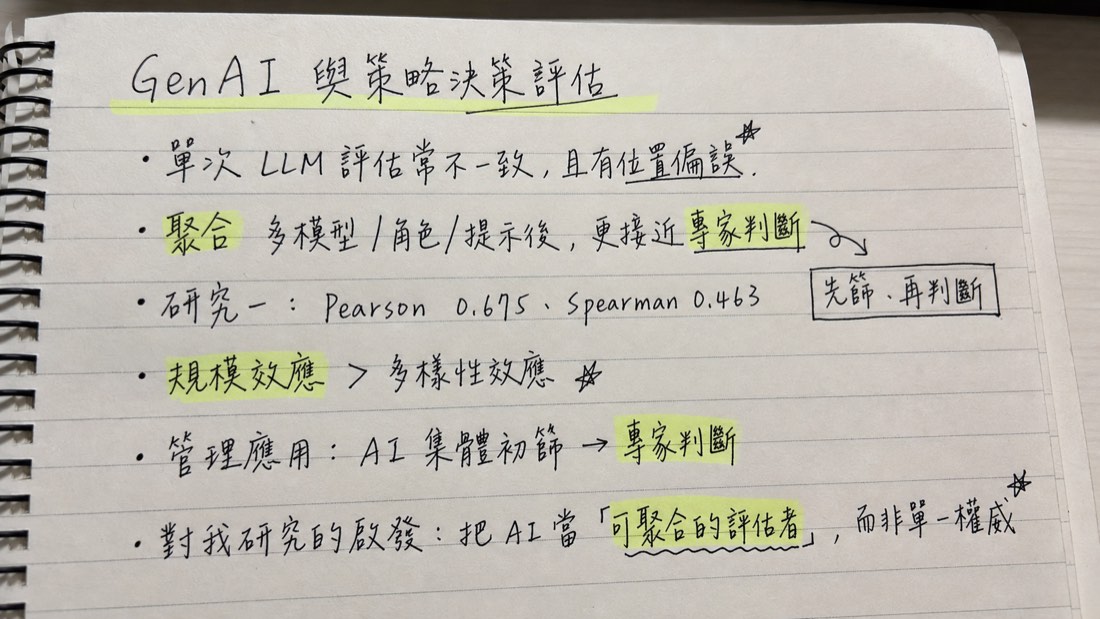
結果很有意思,也很符合現在對 GenAI 的直覺觀察。單次 LLM 評估確實常常不一致,而且有明顯位置偏誤;同一組方案只是順序對調,就可能出現不同答案。可是,一旦把多個 AI 判斷聚合起來,表現就顯著改善。Study 1 中,comprehensive AI evaluator 與人類專家的 Pearson correlation 為 0.675、Spearman correlation 為 0.463,在 10 個產業中有 5 個產業選出相同最佳 business model、6 個產業選出相同最差方案。Study 2 的結果大致重現這個模式,Pearson correlation 為 0.663、Spearman correlation 為 0.720。更關鍵的是,作者拆解後發現 scale effect 普遍比 diversity effect 更強,代表在這類策略評估任務中,「多做很多次並聚合」比「只追求來源差異」更能提升穩定度。
8. 理論貢獻
我認為本文最大的理論貢獻,不只是說 LLM 可以幫忙做策略判斷,而是重新定義了 AI 在決策研究中的角色。過去多把 AI 當成生成器、資訊處理器或自動化工具;這篇則把 AI 放進 judgment aggregation 的理論框架裡,當成可被設計、比較與聚合的評估者。這讓 strategy 與 IS / AI research 之間多了一個很可發展的接口:未來研究不一定只比較「AI vs. human 誰比較好」,而是可以研究「如何設計 AI 群體判斷流程,讓它與人類決策形成互補」。
9. 實務意涵
對管理者來說,本文最可操作的訊息不是「把策略決策交給 AI」,而是「不要把單一 AI 回答當成權威」。更合理的做法,是把 AI 用在前端初篩與比較:讓不同模型、不同角色、不同提示各自評估,再聚合成一個比較穩健的排序,最後交由人類專家做 final judgment。這樣可以在昂貴的人力審查前,先用相對低成本的方式縮小選項集。對創業競賽、投資評估、商業模式篩選、產品創意預審來說,這套流程都有很強的可移植性。
10. 研究限制
本文仍有幾個邊界。第一,研究聚焦於 business model evaluation,尚不能直接推廣到所有策略決策,例如併購、組織設計或跨國進入模式。第二,雖然作者做了兩個 study,但樣本規模仍有限,且情境相對可結構化。第三,LLM 的判斷仍可能反映訓練語料中的既有偏見,因此聚合雖能減少雜訊,不等於完全消除系統性偏誤。第四,若面對極端新穎、語料中少見的策略創新,AI 是否仍能提供有價值的排序,本文還沒有真正回答。
11. 對我研究的啟發
這篇對我最有啟發的地方,是它把「AI 能不能幫忙做研究或決策」這個問題,從單次輸出品質轉成「能不能設計一個可聚合、可校正的 AI 判斷機制」。這個觀點很值得移植到我自己的研究脈絡。若未來我做的是管理、教育或 AI 應用研究,可以把 GenAI 不是當單一受試工具,而是當多重評估者組合來設計。例如,在教育情境中,可以比較不同 agent 角色對學生作品的評分一致性;在管理情境中,可以讓多個 AI 角色對方案、課程或政策進行前測排序,再拿去跟專家或我結果比對。這樣的研究設計比單純討論「AI 好不好用」更有理論厚度,也更容易形成可複製的方法論貢獻。
12. 整體評價
整體來看,這是一篇很值得讀、而且非常可重用的論文。它的價值不在於渲染 GenAI 的神奇,而在於冷靜地指出單一 AI 評估其實很脆弱,同時又提出一個可操作的修正方案。對 strategy 研究者來說,這篇把 AI 拉進了嚴肅的 decision evaluation 脈絡;對 AI 應用研究者來說,它示範了如何把「聚合」當成設計原則,而不是只看單次模型表現。若要挑缺點,就是 Spearman 與 top-choice 的提升不是所有指標都同樣強,代表 AI 聚合雖有用,但還沒到可以取代專家的程度。不過正因如此,這篇更像是建立了一條可信的研究路線,而不是過度樂觀的技術宣言。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。