文獻筆記・
AI 回饋給得多,學生卻改得少
這篇要回答三個很關鍵的問題。第一,若把學生議論文交給老師、Zero-shot GenAI、或 CoT GenAI 來給回饋,哪一種回饋品質更高?第二,這些不同來源的回饋,會不會隨著學生初稿好壞而呈…
- 論文
- Generative AI offers more, but students revise less: comparing the effects of teacher and AI feedback on student essay revisions
- 作者
- Mohammadreza Farrokhnia, Saeed Latifi, Pantelis M. Papadopoulos, Loes Hogenkamp, Hannie Gijlers, Hassan Khosravi, Omid Noroozi(2026)
- 期刊
- International Journal of Educational Technology in Higher Education, 23(1), 6
- DOI
- 10.1186/s41239-026-00579-9
- 分類
- 教育
2. 研究問題
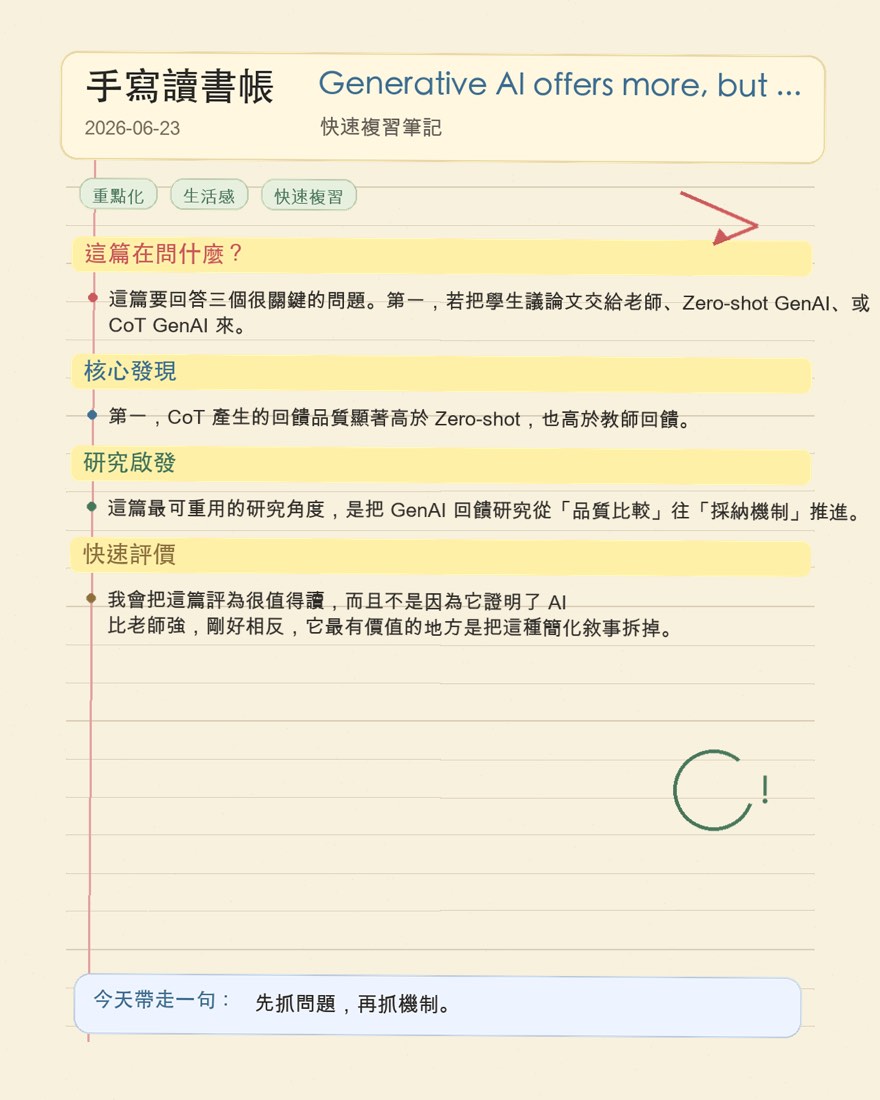
這篇要回答三個很關鍵的問題。第一,若把學生議論文交給老師、Zero-shot GenAI、或 CoT GenAI 來給回饋,哪一種回饋品質更高?第二,這些不同來源的回饋,會不會隨著學生初稿好壞而呈現不同穩定性?第三,也是最重要的一點,即使 AI 回饋看起來更完整、更有條理,它到底能不能真的讓學生把作文修得更好?
3. 理論基礎
文章的理論底座主要有三層。第一是形成性回饋理論,強調回饋真正的功能不只是指出錯誤,而是幫學生縮小當前表現與目標表現之間的差距。第二是 Toulmin 論證模型,作者用它把議論文拆成可評分、可診斷的組件,例如主張、理由、證據、反駁與結論。第三是近年 AI in education 常談的 prompt engineering 邏輯:如果任務本身需要分步推理與結構判斷,那麼 CoT 類提示應該比單純 Zero-shot 更能逼近人類教師的診斷節奏。
4. 研究架構
整體架構可以理解成一條三段鏈。最前面是「回饋來源/提示策略」,也就是老師、Zero-shot、CoT 三種條件;中間是「回饋品質」,用 Toulmin rubric 檢查回饋有沒有抓到論證寫作的重要元素;最後才是「修訂表現」,看學生拿到回饋後,修訂稿到底進步多少。作者真正想測的是:更高品質的回饋,是否會自然轉成更高品質的修稿;結果顯示這條路徑其實沒有表面上那麼直線。
5. 假設邏輯
這篇不是傳統列 H1、H2 的強假設檢驗文,但推論邏輯非常清楚。作者先假定論證寫作是高認知負荷任務,因此需要較有步驟感的診斷;照這個邏輯,CoT 應該會比 Zero-shot 產出更好的回饋。接著,若回饋真的更好,理論上學生修訂後的文章品質也應該更高。不過作者同時保留一個重要可能性:真正影響修訂成效的,也許不只是回饋品質本身,而是學生能不能理解、相信並採納這些回饋。
6. 方法
研究採隨機三組實驗設計,樣本是 70 位以波斯語為母語的研究生。所有人先寫一篇議論文初稿,再被隨機分派到三種條件之一:接受教師書面回饋、接受 ChatGPT Zero-shot 回饋、或接受 ChatGPT CoT 回饋。之後學生依據收到的回饋修訂文章。研究用 Toulmin 論證模型衍生的 rubric 來評估兩件事:一是回饋本身的品質,二是初稿與修訂稿的寫作品質。統計分析包含單因子 ANOVA、相關分析、ANCOVA 與分組回歸,用來比較回饋品質、檢查初稿品質與回饋品質的關聯,以及估計不同條件下的修訂效果。
7. 結果
核心結果有三個。第一,CoT 產生的回饋品質顯著高於 Zero-shot,也高於教師回饋;Zero-shot 與教師回饋則大致相當。第二,在兩個 GenAI 條件中,回饋品質都會受到學生初稿品質影響,尤其 CoT 仍然如此;換句話說,學生原稿越好,AI 越容易給出精準、對點的回饋。相對地,教師回饋品質與學生初稿品質沒有顯著關聯。第三,雖然三組學生修訂後都有進步,但在控制初稿品質後,三組修訂稿表現沒有顯著差異;真正最強的預測變項不是回饋來源,而是學生原本的寫作能力。更細看回歸分析,只有教師組的回饋品質能顯著預測修訂表現,兩個 GenAI 組都沒有。
8. 理論貢獻
這篇最有意思的理論貢獻,是把「回饋品質高」和「學習效果好」這兩件常被直覺綁在一起的事拆開。它證明了 CoT 確實能把 AI 回饋做得更像一份結構完整的教學診斷,但這不代表學生就會因此修得更好。也就是說,回饋研究不能只看輸出品質,還要把 uptake 拉回模型核心。另一個貢獻是它把非英語、且在 LLM 訓練中相對弱勢的波斯語情境納入,提醒我們 AI 回饋效果會受到語言與文本結構差異影響,不能直接把英語研究的結論平移過去。
9. 實務意涵
對教學現場最直接的啟示是,CoT prompt 的確能把 GenAI 變成更像樣的回饋工具,但它還不能取代教師在「判斷學生現在最需要什麼」上的敏感度。若學校或老師想用 GenAI 協助寫作教學,更合理的做法不是把 AI 當自動批改替身,而是把它當第一層、可擴充的結構化回饋來源,再由教師或課程機制協助學生理解與採納。對課程設計來說,這代表 AI literacy 不只要教學生怎麼寫 prompt,也要教他們怎麼判讀回饋、怎麼決定哪些建議值得採納,以及怎麼避免把修稿責任整段外包給系統。
10. 研究限制
這篇限制其實寫得很誠實。第一,樣本集中在單一伊朗大學、且多為教育領域研究生,外推到其他國家、學科或學位層級時要保守。第二,研究只看單次短期修稿,不是多輪長期寫作歷程,因此比較像測到 immediate revision,而不是長期寫作成長。第三,評分 rubric 偏重論證結構,較少處理回饋語氣、鼓勵性或主觀有用性感受,所以 AI 在「結構對點」上的優勢可能被放大。第四,作者推測波斯語的語法與 discourse 特性可能影響 AI 回饋穩定性,但這部分還沒有被直接因果驗證。
11. 對我研究的啟發
這篇最可重用的研究角度,是把 GenAI 回饋研究從「品質比較」往「採納機制」推進。我如果後續要做 AI in education,不一定要再重做一次 teacher vs AI 的誰比較強,而可以更進一步問:什麼條件下學生比較願意採納 AI 回饋?什麼類型的任務、什麼程度的前備能力、什麼樣的規範說明,會讓高品質回饋真的變成高品質修訂?另一個很值得延伸的方向,是把學生原始能力、語言背景、回饋素養與 prompt 設計放進同一個模型裡,去測它們如何交互影響 uptake。若我對高教中的 AI governance 或 learning analytics 有興趣,這篇也提供了一個很實用的切點:不要只追模型輸出表現,而要追「輸出被學生怎麼處理」。
12. 整體評價
我會把這篇評為很值得讀,而且不是因為它證明了 AI 比老師強,剛好相反,它最有價值的地方是把這種簡化敘事拆掉。作者用相對乾淨的實驗設計說明:CoT 可以讓 AI 回饋更漂亮、更完整,但學習效果不會因此自動升高;真正有差的是學生本身的基礎能力,以及回饋有沒有被轉譯成可行的修訂行動。對 2026 年的教育科技研究來說,這是一個很成熟也很實用的訊號。若今天只讀一篇近期新文,這篇在研究設計、議題重要性與後續可重用性上都非常夠格。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。