文獻筆記・
數位服務生態系中的 AI 角色分類
這篇文章處理的核心問題是:當 AI 被嵌入數位服務生態系之後,我們到底該把它理解成被動工具、可調度資源,還是具有一定自主性的非人行動者?作者認為,既有服務研究多半仍以人和人之間的互動為中心,對於 …
- 論文
- Artificial intelligence in digital service ecosystems—Towards a taxonomy and archetypes
- 作者
- Philipp Hansmeier, Jannika Marie Schäfer, Philipp zur Heiden(2026)
- 期刊
- Electronic Markets, 36(1), 22
- DOI
- 10.1007/s12525-026-00879-y
- 分類
- 管理
2. 研究問題
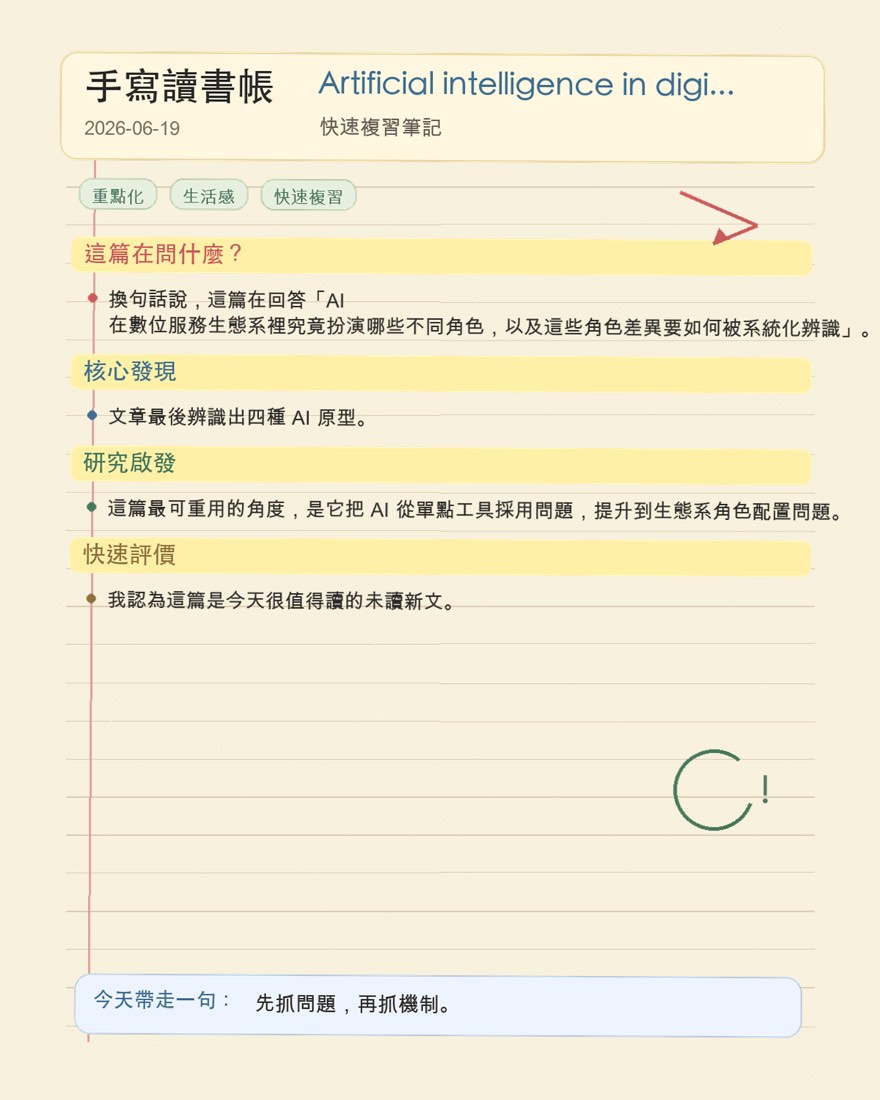
這篇文章處理的核心問題是:當 AI 被嵌入數位服務生態系之後,我們到底該把它理解成被動工具、可調度資源,還是具有一定自主性的非人行動者?作者認為,既有服務研究多半仍以人和人之間的互動為中心,對於 AI 如何在多方參與的服務生態系中參與價值共創,還缺乏一個足夠細緻、可以實際分類的分析框架。換句話說,這篇在回答「AI 在數位服務生態系裡究竟扮演哪些不同角色,以及這些角色差異要如何被系統化辨識」。
3. 理論基礎
理論上,文章主要立基於 service-dominant logic(SDL)與 service science。SDL 傳統上把價值共創視為多方行動者整合資源的過程,但對 AI 的定位一直不夠清楚,因為 AI 既像資源,又表現出類似行動者的自主反應能力。作者因此借用 principal-agent 的思路,提出可以把 AI 視為一種由人類授權、在特定情境中執行任務的 non-human agent。這個處理很重要,因為它讓 AI 不再只是「科技背景變數」,而是能夠在理論上被當成生態系中會影響互動與價值創造的參與者。
4. 研究架構
整體架構是先建構 taxonomy,再用多案例驗證,最後抽取 archetypes。作者將 AI 在數位服務生態系中的差異放進四個主維度:第一是 ecosystem data,也就是 AI 依賴和處理的是什麼樣的生態系資料;第二是 perceived ecosystem embeddedness,也就是 AI 在整個生態系裡嵌得有多深、和多少參與者及流程連動;第三是 perceived behavior,也就是它呈現出的自主性、適應性與互動特徵;第四是 perceived value,也就是它最終替個別接觸點或整個生態系帶來什麼價值。這四個維度一起構成作者辨識 AI 角色的主框架。
5. 假設邏輯
這不是傳統假設檢驗研究,所以沒有 H1、H2 這種正式假設。比較準確地說,作者提出的是一組命題式推論邏輯:如果 AI 在資料依賴、嵌入深度、行為表現與價值貢獻上有穩定差異,那麼它們在數位服務生態系中就不應被混成同一類技術,而應被區分為不同原型。進一步說,作者認為 AI 的關鍵分野至少包括判別式 versus 生成式,以及偏向生態系協調 versus 偏向個別服務接觸優化。這個邏輯的重點不是驗證單一路徑,而是建立一個足以支撐後續理論累積與案例辨識的分類語言。
6. 方法
方法上分成兩段。第一段依 Nickerson 等人的 taxonomy development 流程,結合理論導向與經驗導向的迭代方式,總共做了六輪迭代,逐步收斂出互斥且相對完整的分類維度與特徵。第二段採 multiple case study,用真實案例去檢驗這套 taxonomy 是否真的能區辨不同 AI 角色,並據此進一步歸納 archetypes。這種做法很適合目前 AI 角色快速分化、但理論語言還在形成中的研究情境,因為它兼顧概念清晰度與實務可觀察性。
7. 結果
文章最後辨識出四種 AI 原型。第一是 discriminative experience enhancer,重點在提升特定服務接觸中的辨識、推薦或回應品質;第二是 protective ecosystem orchestrator,重點在維持整個生態系的安全、秩序與穩定;第三是 ecosystem innovation companion,重點在協助生態系參與者共同生成新內容、新方案或新價值;第四是 personalized service composer,重點在整合多種資料與服務模組,編排高度個人化的服務體驗。整體來看,結果顯示 AI 在數位服務生態系中的差異,不只是功能多寡,而是角色邏輯不同;有些 AI 比較像強化效率的分類器,有些則更像能夠參與創新或服務組裝的協作者。
8. 理論貢獻
這篇最重要的理論貢獻,是把「AI 在服務研究中的定位模糊」具體拆開處理。它沒有停在抽象地說 AI 很重要,而是提出一套可以重複使用的分類架構,把 AI 如何作為資源與如何作為 non-human agent 都納入同一個分析視角。對 service science 和 SDL 研究來說,這等於補上一塊中層理論工具,讓後續研究不必每次都從頭討論 AI 算不算 actor,而是可以直接比較不同 AI 原型如何改變價值共創、治理與互動結構。
9. 實務意涵
對實務端來說,這篇文章的價值很高,因為它提醒管理者不要把所有 AI 專案混成同一種導入問題。若企業面對的是信任、風險控制與系統穩定問題,可能更需要 protective ecosystem orchestrator 類型的 AI;若目標是促進共創、加速內容生產或刺激新服務設計,則更接近 ecosystem innovation companion。也就是說,這篇提供的不是單一 best practice,而是一種更成熟的策略診斷語言,幫助企業把 AI 投資和生態系目標對齊。
10. 研究限制
這篇雖然理論建構完整,但仍有幾個限制。第一,它建立的是 taxonomy 與 archetypes,不是因果識別設計,所以還不能回答哪一類 AI 一定在什麼情境下效果最好。第二,多案例研究雖然適合早期理論發展,但案例選取與詮釋仍難免受研究者判斷影響。第三,AI 技術演化很快,尤其 agentic AI 與更高自主性的系統持續出現,未來可能會逼得這套分類法繼續擴充或重組。因此這篇比較像是穩固的第一版理論地圖,而不是最後定稿。
11. 對我研究的啟發
這篇最可重用的角度,是它把 AI 從單點工具採用問題,提升到生態系角色配置問題。對我的研究來說,這個轉換很有價值,因為不管是管理、教育還是 AI 應用研究,都可以不再只問「有沒有用 AI」,而是進一步問「AI 被放在什麼角色、嵌入哪一層互動、替誰創造什麼價值」。如果把這個思路搬到教育場景,我甚至可以區分 AI 是課堂中的 experience enhancer、課程治理中的 orchestrator,還是協作創新中的 companion。這樣的角色化分析,比單純做 adoption 或 attitude 模型更能打開新的理論問題,也更容易連到組織設計與制度安排。
12. 整體評價
第一,它直接命中 AI applications 與 management 交界,主題優先度高;第二,它不是泛泛而談趨勢,而是有清楚方法論、具體分類維度與四種可操作原型,後續非常容易拿來當文獻回顧或研究設計的骨架;第三,期刊品質可以部分明確確認,屬於高品質且主流索引可見的來源。若要說缺點,就是它偏向理論整理與案例歸納,暫時不提供強因果證據;但若我要找的是一篇能夠重構問題意識、幫我建立分析語言的文章,這篇的可重用性非常高。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。