文獻筆記・
管理顧問業中生成式 AI 的雙面刃
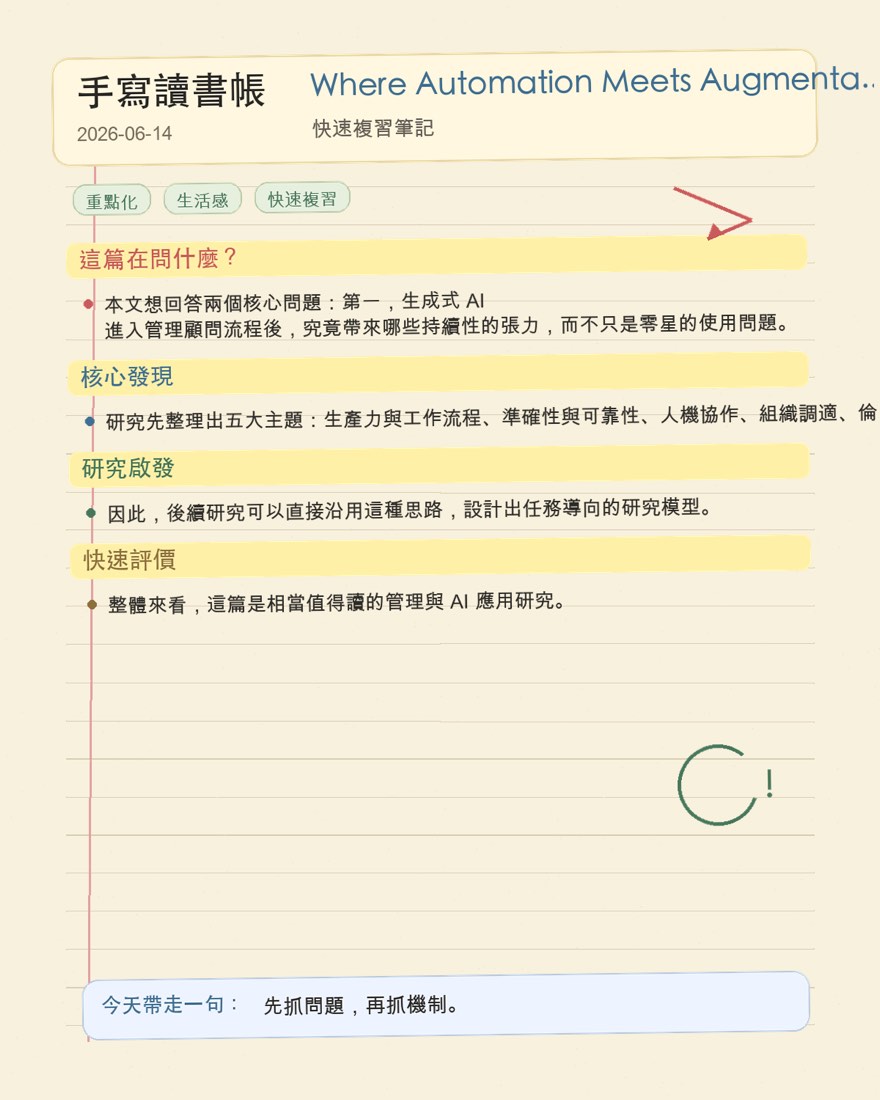
本文想回答兩個核心問題:第一,生成式 AI 進入管理顧問流程後,究竟帶來哪些持續性的張力,而不只是零星的使用問題。第二,管理者要如何依任務特性動態平衡這些張力,讓 GenAI 既能提升績效,又不至…
- 論文
- Where Automation Meets Augmentation: Balancing the Double-Edged Role of Generative AI in Management Consulting
- 作者
- Matthias Tuczek, Kenan Degirmenci, Michael H. Breitner, Kevin C. Desouza, Richard T. Watson(2026)
- 期刊
- Business & Information Systems Engineering
- DOI
- 10.1007/s12599-026-00992-4
- 分類
- 管理
2. 研究問題
本文想回答兩個核心問題:第一,生成式 AI 進入管理顧問流程後,究竟帶來哪些持續性的張力,而不只是零星的使用問題。第二,管理者要如何依任務特性動態平衡這些張力,讓 GenAI 既能提升績效,又不至於犧牲專業判斷、客戶信任與長期能力養成。
更具體地說,作者不把問題收斂成「AI 好不好用」,而是把焦點放在「什麼任務適合自動化、什麼任務只能做增強、什麼情境反而應該避免使用」。這讓研究問題從單純 adoption 轉向 task-level governance。
3. 理論基礎
理論上,作者把兩套脈絡接在一起。第一套是 Task-Technology Fit (TTF),主張科技對績效的貢獻取決於它是否符合任務需求。第二套是 dynamic equilibrium framework,強調組織面對互相拉扯的矛盾時,重點不是徹底解決,而是持續平衡。
作者的關鍵推進是把 TTF 往 GenAI 時代延伸成 TGAIF。也就是說,任務與技術的「適配」不再只是功能對功能,而是要同時考慮 GenAI 所引入的矛盾,例如效率與責任、一般性與專門性、彈性與一致性。這使得 fit 變成一種動態調整能力,而不是靜態配對。
4. 研究架構
研究架構先從訪談資料萃取出 37 個 tension,再濃縮成 3 個最核心的任務層級張力:automation vs. augmentation、generality vs. specificity、flexibility vs. uniformity。其中後兩者被用來作為 TGAIF 框架的主要坐標軸,而 automation vs. augmentation 則被視為組織在評估任務之後做出的策略性回應。
在這個架構下,作者提出四種任務角色:
- Adaptive Specialist:高彈性、高專門性,適合高增強、低自動化
- Creative Generalist:高彈性、高一般性,適合高增強、中度自動化
- Precise Specialist:高一致性、高專門性,適合中度自動化、平衡增強
- Scalable Generalist:高一致性、高一般性,適合高自動化、低增強
5. 假設邏輯
本文不是假設檢驗型研究,沒有統計假設;這一段應理解為其命題或推論邏輯。核心推論是:GenAI 對績效的影響不是固定正向或固定負向,而是取決於任務本身的性質,以及組織是否選對使用策略。
更細一點說,如果任務高度例行、可標準化、所需知識較一般化,GenAI 比較適合被拿來做自動化;但若任務高度模糊、客製化、仰賴 tacit knowledge 或客戶互動,則 GenAI 的角色應轉為增強。當任務的敏感性、信任需求或風險高到超過可控範圍時,「暫不使用」也是合理策略,而不是技術抗拒。
6. 方法
作者以德國管理顧問業為場域,對 16 家領先顧問公司中的 33 位專家進行 22 場半結構式訪談,受訪者包含 junior consultant、senior consultant 到 management/partner。資料收集時間在 2024 年 9 月到 11 月之間,並以 purposive sampling 搭配 snowball sampling 擴展樣本。
分析上採兩階段主題分析。前段由研究團隊做歸納式人工編碼,後段使用 ChatGPT 輔助整理重複表述、對比觀點與摘要,但所有 AI 輸出都經人工審查與修正。作者也對部分人工編碼與 AI 輔助編碼結果進行比對,以確認主題結構的一致性。這種做法本身也回應了本文主題:AI 被定位為研究分析的 augmentation,而非完全替代。
7. 結果
研究先整理出五大主題:生產力與工作流程、準確性與可靠性、人機協作、組織調適、倫理與社會意涵。受訪者普遍認為 GenAI 能顯著節省初稿、摘要、報告格式化與資訊整理時間,但這種效率經常伴隨品質風險、過度依賴,以及初階顧問技能養成被削弱的疑慮。
作者最後把眾多 tension 歸納為三個最核心的張力。第一是 automation vs. augmentation:GenAI 可以處理不少例行工作,但高價值任務仍需要人類判斷。第二是 generality vs. specificity:GenAI 在通用知識上很強,但遇到產業細節與脈絡化任務時容易失準。第三是 flexibility vs. uniformity:標準化能帶來效率,但也可能壓縮客製化空間。基於這三組張力,作者提出四象限的 TGAIF 建議,用來判斷不同任務該落在哪種自動化/增強配置。
8. 理論貢獻
這篇的理論價值不只是再說一次「AI 是雙面刃」,而是把這個抽象說法真正操作化。作者將 TTF 由相對靜態的適配觀點,擴展成可以處理 GenAI 持續性矛盾的動態適配框架,讓「fit」本身成為一種組織能力。
另一個重要貢獻是,作者把 defensive strategy 正式納入理論解釋。很多 GenAI 文獻預設更多使用就是更高成熟度,但本文指出,在高風險、高敏感、強信任依賴的任務中,刻意限制或延後使用 AI,可能反而是更高品質的 equilibrium response。這讓 adoption 研究不必陷入「用或不用」的單線進步敘事。
9. 實務意涵
對管理顧問公司而言,最直接的應用不是全面導入 GenAI,而是先做任務盤點。公司可以把工作拆成報告草擬、資料整理、合規文件、策略工作坊、客戶互動等任務模組,再按 TGAIF 判斷哪些任務可以高度自動化,哪些任務只適合 AI 輔助,哪些任務必須保留人工主導。
對一般知識工作者而言,這篇也提醒了一件很實際的事:GenAI 的價值常來自「加速前半段」,而非「包辦整段工作」。如果把它當成 first draft engine、idea expander、pattern spotter,效益通常較穩;但若把它視為高風險決策的最終依據,就容易掉進 hallucination、過度自信與技能退化的陷阱。
10. 研究限制
第一,樣本集中在德國顧問產業,文化、產業結構與法規背景都可能影響結果外推。第二,這是一篇質性研究,重點在框架形成與概念提煉,尚未做大樣本量化檢驗,因此四象限配置目前較接近有理論支撐的實務框架,而非已經廣泛統計驗證的模型。
第三,GenAI 技術演進速度極快。2024 年訪談時成立的 tension,到 2026 年未必以相同形式存在,尤其模型可靠性、企業私有部署與治理工具一旦提升,某些張力的強度可能改變。不過作者也正因如此,把焦點放在「如何動態調整」而不是一次定案,這點反而讓框架較有延展性。
11. 對我研究的啟發
如果我目前關注的是 GenAI 在管理、教育或知識工作中的導入,這篇最值得借用的不是顧問情境本身,而是它把「AI 使用效果」拆成任務層級條件的做法。很多研究仍以整體 adoption、整體 attitude、整體 performance 為單位,但本文提醒:不同任務的風險結構與價值結構差異太大,把它們混在一起會稀釋重要機制。
因此,後續研究可以直接沿用這種思路,設計出任務導向的研究模型。例如在教育情境中,不同學習任務也可被區分為高專門性/低專門性、 high flexibility/high uniformity,進一步檢驗什麼類型的學習活動適合用 GenAI 做自動化回饋、什麼類型更適合做引導式增強。若放回管理研究,TGAIF 也可延伸成 team-level 或 role-level framework,觀察 junior 與 senior 知識工作者在同一任務上的適配邏輯是否不同。
更重要的是,這篇提供了一個很可重用的角度:把「刻意不用 AI」視為有理論意義的治理選項。這點非常適合拿來補足目前常見的 adoption 文獻偏誤,也能延伸到我若想研究 AI governance、AI readiness 或 human agency 的議題。
12. 整體評價
整體來看,這篇是相當值得讀的管理與 AI 應用研究。它的優點不是樣本特別大,而是問題意識很清楚,知道市場上真正缺的不是更多「AI 很有潛力」的敘述,而是可以落到任務層級的判準。TGAIF 框架也夠簡潔,容易被後續研究、教學設計或企業導入流程吸收。
它的弱點則在於,目前仍偏重概念建構與質性歸納,四象限之間的邊界、不同任務的衡量方式,以及長期技能侵蝕的因果關係,還需要更多量化與縱貫研究支持。不過以「提供一個可操作、可延伸、可轉譯的中層框架」來看,這篇完成度很高,也很適合作為後續研究設計的起點。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。