文獻筆記・
AI 出錯時該道歉還是道謝:處理幻覺的溝通
作者的研究問題可拆成三層。第一,AI 在 hallucination 後是表達 gratitude 還是 apology,會不會造成不同的 user satisfaction。第二,AI 若把錯誤…
- 論文
- Sorry, it's my fault: Politeness, attribution, and anthropomorphism in managing generative AI hallucinations
- 作者
- Hayeon Kim, Sang Woo Lee(2026)
- 期刊
- International Journal of Information Management, 86, 102996
- DOI
- 10.1016/j.ijinfomgt.2025.102996
- 分類
- 管理
1. 基本資訊
這篇文章由 Hayeon Kim 與 Sang Woo Lee 發表於 2026 年的 International Journal of Information Management,題目是〈Sorry, it's my fault: Politeness, attribution, and anthropomorphism in managing generative AI hallucinations〉,DOI 為 10.1016/j.ijinfomgt.2025.102996。文章關心的是一個非常實務而且當代的問題:當 generative AI 已經產生 hallucination、而且使用者已經察覺錯誤時,AI 究竟該怎麼回應,才最能維持滿意度與對錯誤的容忍度。
2. 研究問題
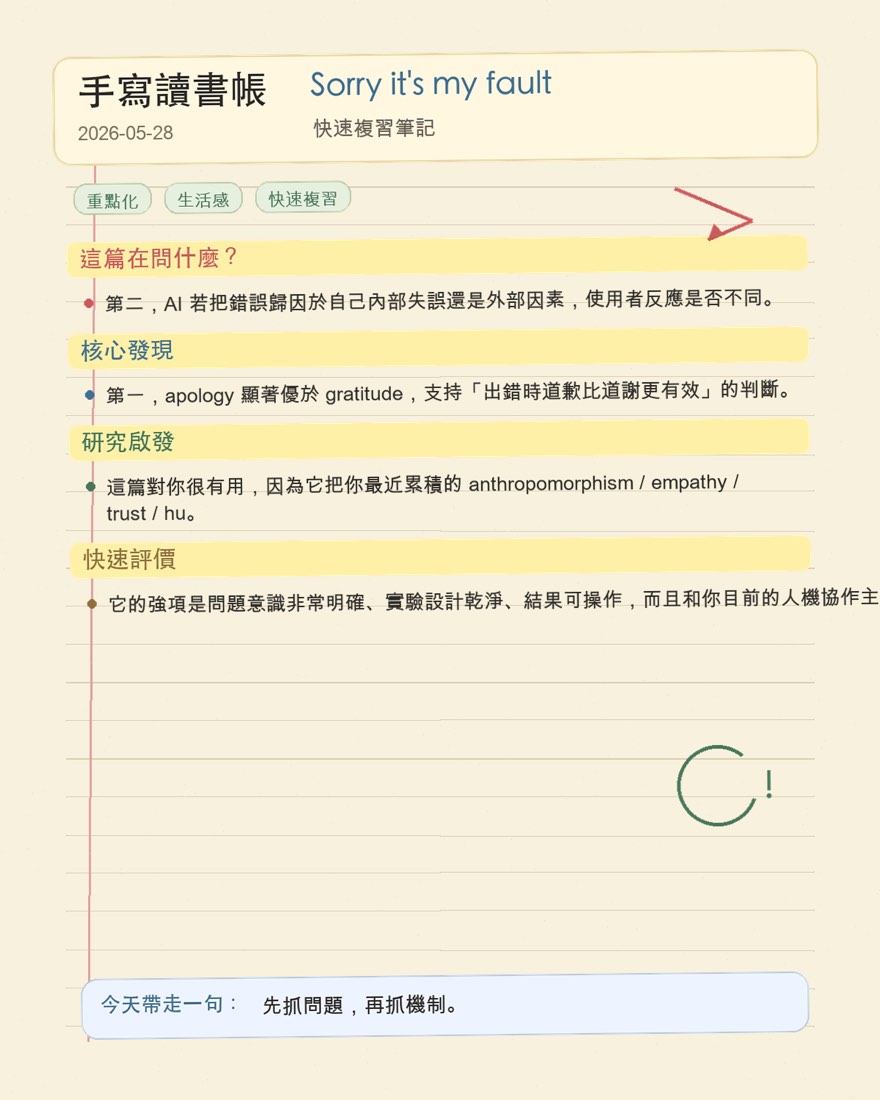
作者的研究問題可拆成三層。第一,AI 在 hallucination 後是表達 gratitude 還是 apology,會不會造成不同的 user satisfaction。第二,AI 若把錯誤歸因於自己內部失誤還是外部因素,使用者反應是否不同。第三,使用者是否把 AI 視為更 human-like,也就是 anthropomorphism 程度高低,會不會改變上述效果,並進一步影響對 AI hallucination 的 tolerance。這讓文章不只是談「錯了要不要道歉」,而是把道歉語氣、責任歸屬與人機社會知覺一起放進模型。
3. 理論基礎
理論上,本文主要建立在 politeness theory、attribution theory、CASA 與 human-centered AI。依 politeness theory,感謝與道歉都屬社會互動中的 face management 策略,但它們服務的是不同的社會需求;在錯誤情境中,道歉更能回應對方受損的感受與關係修復需求。依 attribution theory,當負面事件發生時,使用者會關注責任到底在內部還是外部,而內部歸因通常更能傳達承擔責任的訊號。CASA 則提供一個重要前提:即便 AI 不是人,使用者仍會把社會規範套用到它身上,因此 AI 的語氣與責任表述會像人際互動一樣,實際影響滿意度與容錯。
4. 研究架構
整體架構很清楚。作者操作兩個主要自變項:politeness(gratitude vs. apology)與 attribution(external vs. internal),並把 anthropomorphism 作為調節變項。結果變項是 user satisfaction 與 tolerance。其中 satisfaction 被視為 tolerance 的中介,也就是某種回應策略如果先提升了對 AI 回應的滿意度,就更可能讓使用者對 hallucination 本身保持較高容忍。
5. 假設邏輯
作者的假設邏輯很直接。第一,當 AI 已被指出犯錯時,apology 比 gratitude 更符合使用者對負責任回應的期待,因此應提高 satisfaction。第二,internal attribution 比 external attribution 更能表達承擔責任,也應提升 satisfaction。第三,若 AI 同時道歉又內部歸因,這種 apology × internal attribution 組合應該最有效。第四,anthropomorphism 可能調節這些效果,因為越把 AI 視為像人,越可能用人際標準評價它;但作者也預期,在低 anthropomorphism 情況下,社會性回應策略反而可能發揮更明顯的補償作用。第五,這些策略對 tolerance 的影響不一定直接發生,而更可能透過 satisfaction 間接形成。
6. 方法
研究採 2×2 線上實驗設計,以 369 位 ChatGPT 使用者為樣本,隨機分派到四種策略條件。參與者先閱讀 hallucination 情境,再看到不同的 AI 回應版本,之後評估 satisfaction、tolerance 與 anthropomorphism 等變項。分析上,作者使用 robust regression 處理潛在離群值與誤差非正態問題,並以 bootstrapping 檢驗 mediation 與 moderated mediation。這個設計的優點是條件乾淨,能直接看不同回應措辭與責任訊號怎麼改變使用者反應。
7. 結果
結果相當清楚。第一,apology 顯著優於 gratitude,支持「出錯時道歉比道謝更有效」的判斷。第二,internal attribution 顯著提高 satisfaction,代表使用者更偏好 AI 承認錯誤來自自身,而不是推給外部因素。第三,apology × internal attribution 的組合帶來最高 satisfaction,是四種策略中最有效的一種。第四,anthropomorphism 本身對 satisfaction 有正向主效果,但三向交互顯示,這套最佳策略對低 anthropomorphism 使用者的提升幅度更大;也就是說,當使用者原本不太把 AI 當人看時,清楚的社會性修復訊號更能補上信任與關係感。第五,三向交互對 tolerance 的直接效果不顯著,但透過 satisfaction 的間接效果顯著,表示使用者不是因為 AI 直接變得更可原諒,而是因為先對它的回應更滿意,才更能容忍 hallucination。
8. 理論貢獻
這篇最大的理論貢獻,是把 AI hallucination 從技術失誤問題推進成 social response design 問題。第一,它把 politeness theory 與 attribution theory 真正接到 generative AI 錯誤處理情境,而不是只停在一般 chatbot 禮貌研究。第二,它細緻指出並不是任何 polite language 都有效;在明確錯誤情境中,道歉與內部歸因才是最符合使用者期待的修復語法。第三,它補強了 CASA 與 human-centered AI 文獻,說明即使是簡短社會線索,也足以在 AI 出錯時影響 satisfaction 與 tolerance。第四,它也修正了「越 anthropomorphic 越好」的直覺,顯示低 anthropomorphism 使用者反而更依賴語言中的責任與修復訊號。
9. 實務意涵
對產品與介面設計者來說,這篇的訊息很明確:當 generative AI 出現 hallucination,最不該做的事就是模糊帶過或把問題推給外部因素。若系統能明確道歉、承認責任,使用者會更滿意,也更可能容忍這次錯誤。這對高風險情境尤其重要,因為 trust 一旦受損通常比建立更難修復。另一個很實際的含義是:不必過度追求外觀或人格設定上的擬人化,只要在回應語氣與責任表述上做對,AI 也能建立關係性信號。
10. 研究限制
限制方面,第一,研究基於情境式線上實驗,而不是真實長期使用脈絡,因此外部效度仍有限。第二,樣本中的女性比例偏高,人口結構不完全均衡。第三,文化差異未被納入,然而道歉與責任承擔在不同文化裡可能有不同社會規範。第四,本文把 satisfaction 作為主要中介,但沒有更進一步拆 trust、perceived authenticity 或 competence threat 等其他可能機制。第五,文章聚焦使用者已明確察覺錯誤的情境,對於使用者尚未察覺 hallucination 時的回應策略,仍有待後續研究。
11. 對我研究的啟發
這篇對我很有用,因為它把我最近累積的 anthropomorphism / empathy / trust / human-GenAI interaction 文獻,再往更微觀的 error-management 情境推進。我前面讀過 privacy calculus、AI sensation、dependency、cognitive style 與 algorithmic management,這篇剛好補上一個關鍵細節:當 AI 協作失敗時,我不是只看錯得多嚴重,也看 AI 怎麼回應這個錯。這對我後續若要研究 human-GenAI collaboration 的 sustained use、trust repair 或 knowledge work interaction 很重要,因為它提醒我:人機協作的關鍵不只在 task fit,也在 post-error communication design。若把這篇和前面 anthropomorphism 文獻放在一起,我可以開始問:不同 anthropomorphic cue、責任表述與情感語氣,是否會系統性改變我對 AI 的寬容、依賴或警覺。
12. 整體評價
我認為這篇很值得在 backlog 中優先讀,因為它直接處理生成式 AI 最現實的一個痛點:hallucination 無法完全消失,那出錯後該怎麼設計回應。它的強項是問題意識非常明確、實驗設計乾淨、結果可操作,而且和我目前的人機協作主線高度兼容。若要挑剔,就是它還停在 scenario-based experiment,離真實長期互動與高風險任務脈絡仍有距離;但作為我文獻池裡處理 AI trust repair 與 social response 的橋梁文,我認為很有價值。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。