文獻筆記・
什麼時候我們想要掌控 AI:自主性悖論
這篇文章要處理的核心問題是:人們明明常說重視自主性與掌控感,為什麼在某些 AI 情境下會因為「控制權被削弱」而排斥 AI,但在另外一些情境下卻願意把決策權交給 AI。作者把問題收斂成兩層。第一層是…
- 論文
- When do you want more control over AI? The paradox of autonomy, task stakes, and distrust in AI aversion
- 作者
- Md Jabir Rahman, Huigang Liang(2026)
- 期刊
- International Journal of Information Management, 89, 103060
- DOI
- 10.1016/j.ijinfomgt.2026.103060
- 分類
- 管理
2. 研究問題
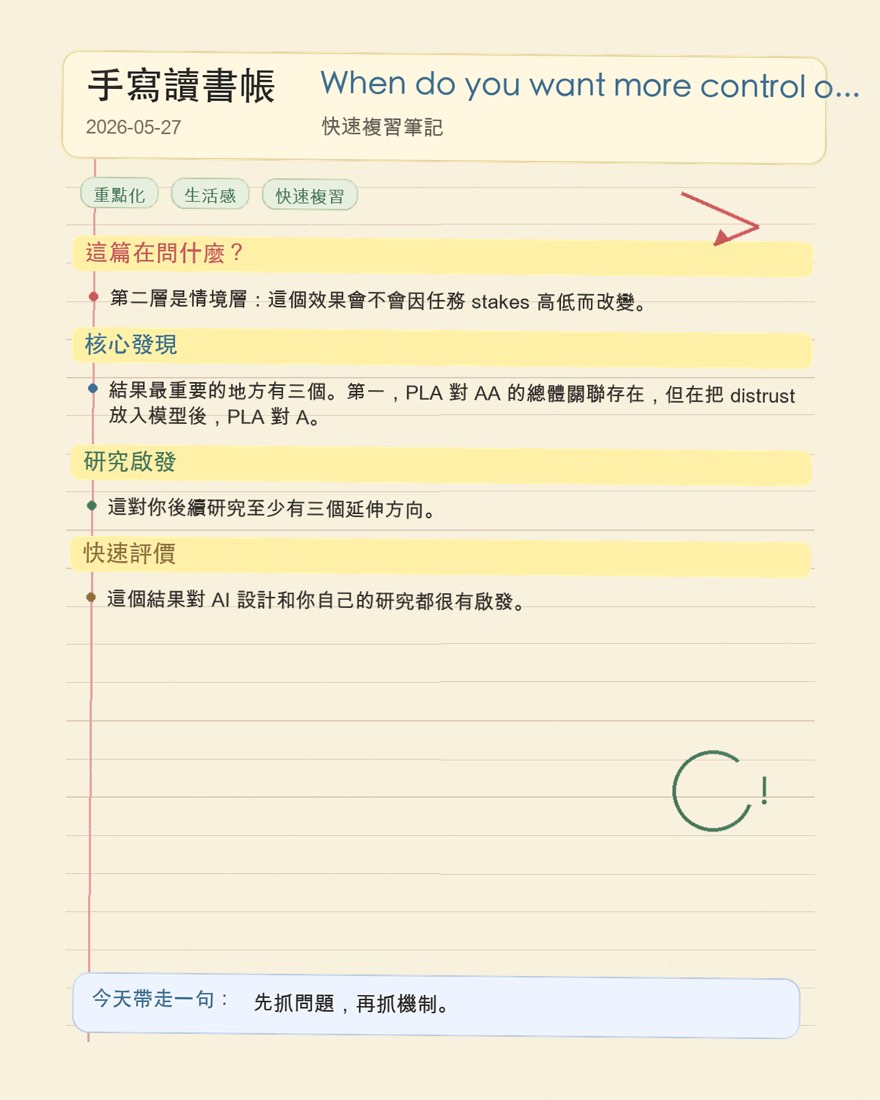
這篇文章要處理的核心問題是:人們明明常說重視自主性與掌控感,為什麼在某些 AI 情境下會因為「控制權被削弱」而排斥 AI,但在另外一些情境下卻願意把決策權交給 AI。作者把問題收斂成兩層。第一層是機制層:perceived lack of autonomy(PLA)究竟如何轉化成 AI aversion(AA)。第二層是情境層:這個效果會不會因任務 stakes 高低而改變。研究因此不是只問「控制權重要嗎」,而是問「控制權何時重要、透過什麼心理機制重要」。
3. 理論基礎
理論核心是 Psychological Reactance Theory(PRT)。PRT 主張,當人感覺自己的自由與選擇權被限制時,會出現一種想恢復自由的防衛性反應,這種 reactance 可以表現為負面情緒、認知抗拒、懷疑與拒用。作者認為既有 TAM、UTAUT 或風險/威嚇類框架較偏功利性評估,難以解釋「即使 AI 很有用,人仍因為被它干預而反感」這件事,因此改用 autonomy threat 作為理論起點。更重要的是,作者把 distrust 當成獨立於 trust 的負向心理狀態,而不是只是 trust 不夠高,這使模型能更精準解釋 autonomy loss 如何一路推到 aversion。
4. 研究架構
研究架構是一個 moderated mediation model。自變項是 perceived lack of autonomy,依變項是 AI aversion,中介變項是 distrust,調節變項則是 task stakes。作者預期,PLA 會先提升使用者對 AI 的 distrust,而 distrust 再進一步推升 aversion;同時,這條間接效果會因任務 stakes 高低而改變。也就是說,這篇把「控制權受威脅」視為心理起點,把「distrust」視為關鍵傳遞機制,再把「任務後果是否重大」視為邊界條件。
5. 假設邏輯
本文是標準假設檢驗研究,共有三條主假設。H1 主張 PLA 會正向影響 AI aversion,因為控制權受限會引發 reactance。H2 主張 distrust 中介 PLA 與 AI aversion 的關係,理由是當使用者感覺 AI 讓自己失去調整、拒絕或改寫系統的能力時,會先懷疑 AI 是否值得信任,再進一步表現為排斥。H3 原本預期 task stakes 越高,這條效果越強,因為高風險決策理應讓 autonomy threat 更敏感。也就是說,作者一開始押的是「高 stakes 會放大 autonomy loss 的負面效果」,但後面結果其實推翻了這個方向。
6. 方法
研究採 randomized controlled online experiment,使用 Qualtrics 與 Prolific 蒐集美國成年樣本。最終有效樣本為 383 人,低 stakes 組 195 人、高 stakes 組 188 人;年齡 19 到 77 歲,平均 35.3 歲,約 75% 有某種 AI 使用經驗。低 stakes 任務是電影推薦,高 stakes 任務是股票投資建議。兩組都被告知自己在使用 AI 工具,但不提供太多技術細節,以免先入為主。操弄 autonomy loss 的方式,是讓參與者只能接受單一 AI 工具輸出、無法調整底層模型或參數,只能接受建議、要求換一個建議,或改找人類顧問。高 stakes 條件下另給 100 美元假想本金與額外 10 美元獎勵誘因,提高決策後果感。量表方面,PLA、distrust、AI aversion 都採既有文獻改編的多題項 Likert 尺度,分析以 PROCESS Model 4 與 Model 7、5000 次 bootstrap 檢驗中介與調節式中介。
7. 結果
結果最重要的地方有三個。第一,PLA 對 AA 的總體關聯存在,但在把 distrust 放入模型後,PLA 對 AA 的直接效果變得不顯著,表示 distrust 支撐了完整中介路徑。第二,PLA 顯著提升 distrust,而 distrust 顯著提升 AI aversion,H1 與 H2 因而獲得支持。第三,也是最有意思的結果,task stakes 的調節方向與原假設相反:PLA 經由 distrust 影響 AA 的間接效果,在 low-stake 情境顯著,在 high-stake 情境反而不顯著。換句話說,人不是在高 stakes 時更在意 AI 奪走控制權,而是在低 stakes 情境下更容易覺得「你沒必要管我這麼多」,因此對 AI 產生更強 distrust 與 aversion。
8. 理論貢獻
這篇最主要的理論貢獻,是把 autonomy 問題真正放進 AI aversion 的核心機制裡,而且不是只停在直接效果。第一,它澄清了先前文獻對 autonomy 與 aversion 關係不一致的原因:不是 autonomy loss 一定直接造成 aversion,而是要先經過 distrust。第二,它把 distrust 當成獨立且理論上重要的負向構念,強化了 trust literature 在 AI 情境中的辨識度。第三,它提出一個很有價值的 boundary condition:task stakes 並不是單純放大 autonomy threat,而是會改變使用者願不願意為了結果把控制權讓出去。這讓 human-AI interaction 不再只是「越有掌控越好」的線性命題,而變成一個 context-sensitive 的 trade-off 問題。
9. 實務意涵
對 AI 產品與服務設計來說,這篇的訊息很直接。若你的 AI 用在低 stakes、日常型、偏偏好導向的任務,例如內容推薦、生活建議、購物輔助,過度替使用者做主很可能適得其反,因為使用者會覺得這種介入不必要、甚至冒犯。因此這類場景更該強化可調參數、可拒絕、可切換、可說明、可覆核。相反地,在高 stakes 場景,例如投資、醫療、風控或重大商業決策,只要能讓使用者相信 AI 的分析能力與可靠性,使用者對 autonomy loss 的敏感度可能沒有想像中那麼高。管理上更關鍵的是設計「可接受的委託」與「可理解的監督」機制,而不是一味把全部控制權交還使用者。
10. 研究限制
這篇限制也很清楚。第一,樣本只來自美國,文化差異可能明顯影響 autonomy 與 trust 的關係,外推到東亞情境時要保守。第二,這是單次、橫斷式的線上實驗,無法觀察長期互動後的信任演化。第三,為了維持內部效度,作者把高 stakes AI 輸出標準化成正向投資建議,這雖然有利 isolating autonomy effect,但也可能讓部分受試者把反應混入對 recommendation valence 的判斷。第四,文中的 AI 是以單次互動、預訓練代理人形式呈現,並沒有真正操弄「可觀察的動態學習」,因此對 adaptive AI 的外推仍有限。第五,電影推薦與股票投資雖然能代表低/高 stakes,但 stakes 與任務類型幾乎綁在一起,仍難完全切開任務性質本身的影響。
11. 對我研究的啟發
這篇對我非常有用,因為它正好把我一直在追的幾條線接起來:Human-GenAI collaboration、cognition、trust 與 knowledge creation。我前面讀過的文很多在談 GenAI 如何提升創意、知識搜尋、探索或工作輸出,但這篇提醒了一件更前提的事:協作效果不是只看 AI 能不能做,而是要看人是否覺得自己仍保有「可決定、可修正、可拒絕」的位置。這對我後續研究至少有三個延伸方向。第一,我可以把 autonomy perception 當成 human-GenAI collaboration 成敗的前置條件,而不是附帶變項,去問不同 cognitive style 的人是否對控制權喪失特別敏感。第二,這篇把 distrust 拉成一個獨立機制,很適合跟我關心的 knowledge creation 文獻結合,因為知識共創裡一旦我覺得 AI 不透明、太強勢,可能不是效率下降而已,而是整個探索意願、試錯意願與創意 ownership 都會被壓縮。第三,這篇的 low-stake / high-stake 差異很值得我轉寫成創意或研究工作流程中的 phase logic:在發想、探索、草稿階段,人可能比在驗證、精修、判斷階段更在意 autonomy 受到干預,這跟我前面讀到的 creative phases 那篇可以直接互補。
12. 整體評價
我認為這篇是非常值得先讀的一篇 IJIM 實證文,因為它不只是在舊題目上再做一次「AI aversion 會不會發生」,而是真的把 autonomy、distrust 與 task context 之間的關係講得更細。最強的地方有兩個:一是用 PRT 把 autonomy threat 的心理路徑說清楚,二是得到一個很有解釋力的反直覺結果,也就是 low-stake 情境其實更容易激發因 autonomy loss 而生的排斥。這個結果對 AI 設計和我自己的研究都很有啟發。不過它仍是相對乾淨的實驗情境,現實裡 AI 系統的能力、透明度、互動輪次、品牌信任與任務歷史都更複雜,所以這篇更像提供一個很好的機制框架,而不是最終定論。就 backlog 優先序來看,它兼具期刊品質、理論厚度與和我研究主線的貼合度,優先讀是合理的。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。