文獻筆記・
CORE 沙盒:組織如何安全試驗生成式 AI
這篇文章真正要處理的,不是「企業要不要導入 GenAI」這種後設問題,而是更前一階段、更實務也更理論化的問題:在高度不確定、技術快速變動、風險與機會同時擴大的情況下,組織要怎麼有系統地學習 Gen…
- 論文
- Organizational learning for exploring Generative AI: CORE-sandbox experiments
- 作者
- Dov Te’eni, Myriam Raymond, Frantz Rowe, Etienne Thénoz, Philippe Trimborn(2026)
- 期刊
- International Journal of Information Management, 87, 103029
- DOI
- 10.1016/j.ijinfomgt.2026.103029
- 分類
- 管理
2. 研究問題
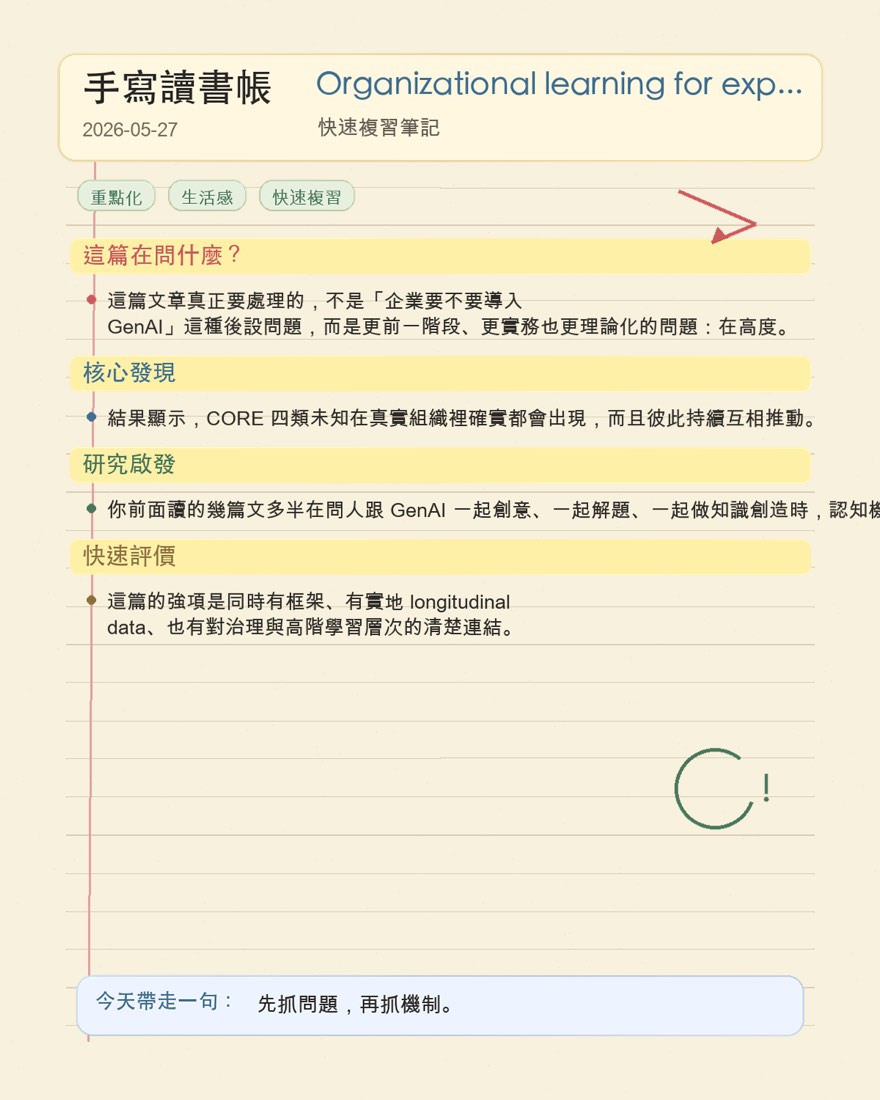
這篇文章真正要處理的,不是「企業要不要導入 GenAI」這種後設問題,而是更前一階段、更實務也更理論化的問題:在高度不確定、技術快速變動、風險與機會同時擴大的情況下,組織要怎麼有系統地學習 GenAI 對自己的影響。作者明確區分「探索 GenAI」與「正式部署 GenAI」不是同一件事,前者面臨的是不知道要學什麼、怎麼學、哪些風險會在本地情境裡浮現。核心研究問題因此被定義為:組織如何在高度不確定與快速變動條件下,系統性學習 GenAI 對組織的影響,並把這種學習轉化為後續導入與治理的依據。
3. 理論基礎
本文的理論基礎主要來自三條線。第一條是 organizational learning 文獻,特別是把學習視為經驗轉化、知識流動與集體 sensemaking 的觀點。第二條是 dynamic capabilities theory,作者借用 sensing, seizing, reconfiguring 的邏輯,說明組織不能只知道 GenAI 有哪些功能,還要把這些功能轉化成可辨識機會與可治理風險。第三條則是 social-practice 與 situated learning 的視角,也就是知識不只是外部下載進來,而是必須在特定工作脈絡裡透過實作、互動、反思與跨部門協商被建構出來。作者由此主張,傳統 OL 理論偏靜態、偏慢、偏抽象,已不足以處理 GenAI 帶來的互動性、速度性與脈絡依賴性。
4. 研究架構
作者提出一個名為 CORE 的學習框架,四個字母分別代表 Capabilities、Opportunities、Risks、Ecosystem。它不是單純列清單,而是把組織在探索 GenAI 時最重要的四類未知,整理成可反覆迭代的學習結構。配套方法則是「CORE-sandbox experiments」:用受控制但能真實接觸工作情境的 sandbox,讓組織一邊吸收外部知識(ex-situ learning),一邊在本地工作場景中做 in-situ learning。整個框架強調四件事:未知之間會互相牽動;外部學習與內部實驗要來回切換;個人學習需要被轉成組織層級的知識;探索過程本身也需要治理與反思。這使得文章不只是提出「要多學習」,而是提出「要用什麼結構學習」。
5. 假設邏輯
這篇不是傳統假設檢驗型研究,但它有非常清楚的推論邏輯。作者認為,當技術本身還在快速演化時,組織最缺的不是 adoption intention 這類後測指標,而是前期探索方法。若組織只靠一般市場資訊或抽象訓練,會知道一些通用能力,卻無法理解本公司的工作流程、倫理限制、部門差異與價值鏈後果。反過來,如果只做零散試用,又會缺少統整結構與跨案例可比性。因此作者推論,最合理的做法是把「學什麼」先收斂成 CORE 四類未知,再透過 sandbox 進行受控制、可回饋、可治理的循環式探索。這樣一來,能力探索可以帶出機會辨識,機會實驗又會暴露風險,而風險與法規、供應商更新、產業生態又會回頭改寫能力與機會的判讀。
6. 方法
研究採 18 個月的單一大型國際服務企業縱向個案,期間從 2023 年 2 月到 2024 年 6 月,在多個校區執行 8 個 sandbox。研究聚焦四類 job family:資訊系統開發、客戶關係、支援職能(如行銷、HR、法務)與主要營運部門。工具面涵蓋 MS365 Copilot、GitHub Copilot、ChatGPT 類工具、影像生成、CRM 視覺化與票務/知識搜尋等多種 GenAI package。資料蒐集採混合方法:10 週連續 weekly questionnaire、3 次 monthly questionnaire、一次公司級問卷(1786 份回覆)、60 場半結構式訪談、8 次沉浸式現場觀察,另有 18 位高階主管與工會代表訪談以界定 ecosystem 與治理脈絡。研究設計分成四步:scoping CORE unknowns、把未知放回公司 ecosystem contextualize、執行多個 sandbox、最後整合結果並回饋治理與擴散建議。
7. 結果
結果顯示,CORE 四類未知在真實組織裡確實都會出現,而且彼此持續互相推動。Capabilities 面向,員工很快發現 prompt engineering 只是起點,真正關鍵的是 task-specific、use-case-specific 的在地技能;GitHub Copilot 的 10 週追蹤中,平均感知生產力到第 8 週達高峰並維持高檔。Opportunities 面向,GenAI 最明顯的價值是卸載重複低價值工作、縮短搜尋與寫作時間、降低影像素材成本,但這些效益在不同工作族群之間差異很大,且工具「好用」不等於會被大規模採納。Risks 面向,研究抓到幾個非常關鍵的現象:47.8% 的受訪者擔心技能過時;20.8% 的棄用者把不信任與答案不可靠列為原因;64.4% 的非使用者擔心自己會把 hallucination 不自覺帶進工作。除此之外,還浮現過度依賴、繞過同事專業、社交隔離、IP 與倫理風險。Ecosystem 面向,模型與功能更新太快,會讓教程和累積經驗迅速過時,供應商鎖定、token / bandwidth / pricing 限制與法規差異,也都會直接影響組織怎麼學、能學到哪裡。
8. 理論貢獻
這篇的理論價值很高,因為它把 organizational learning 從「採用後學習」往前推到「採用前探索學習」。第一,它提出 CORE 作為 GenAI 時代的中層學習結構,把能力、機會、風險與 ecosystem 的未知整合起來,而不是只談 adoption 或 performance。第二,它把 ex-situ learning 與 in-situ learning 的互補關係講清楚,指出外部知識提供起點與邊界,但只有在地實驗才能揭露情境性風險、工作重組與知識轉移問題。第三,它展示了 GenAI 探索不只產生 first-loop learning,也會進入 double-loop 與 triple-loop learning,因為組織最後會修改的不只是操作技巧,還包括規則、倫理程序、審查流程與治理結構。換句話說,這篇把 GenAI 探索從工具學習提升成制度與知識生成問題。
9. 實務意涵
對企業來說,這篇最直接的訊息是:不要把 GenAI 試用做成零散 demo,也不要太早把導入決策建立在供應商簡報或市場 hype 上。更務實的做法,是建立一套有治理、有限度、能留痕的 sandbox 機制,讓不同 job family 在真實工作裡探索。第二個實務訊息是,管理者不能只訓練 prompt 技巧,還要設計任務脈絡中的 use case、驗證方式與風險檢查點,否則員工只會學到表面操作。第三,風險治理要跟著實驗一起長,不是等全面部署後才補規範。文中公司就是在 sandbox 過程中逐步形成 AI charter、風險評估、資料禁用規則與影像生成邊界。最後,若組織真的想把 GenAI 轉成 business value,就必須有機制把個人摸索轉成共享知識,否則學習只會停在少數 enthusiastic users 身上。
10. 研究限制
這篇研究限制也很清楚。首先,它是單一大型歐洲服務企業個案,雖然深度很強,但外推到製造業、SME、平台企業或公共部門時要保守。第二,sandbox 的參與包含志願參與與管理層分配 license,樣本本身可能帶有選擇偏誤,較積極或較有數位能力的人更可能被觀察到。第三,文章強調的是探索學習與治理形成,較少給出標準化、可跨組織直接比較的績效指標,因此比較像建立框架與機制,不是提供普遍效益大小。第四,生態系統變動太快,某些發現本身會有時效性,例如某些 prompt 技巧、供應商差異或特定工具限制,這也意味著框架可能比具體做法更可遷移。
11. 對我研究的啟發
這篇對我特別重要,因為它幫我把 Human-GenAI collaboration、knowledge creation、cognition 這條線,從個體互動層級拉到組織學習層級。我前面讀的幾篇文多半在問人跟 GenAI 一起創意、一起解題、一起做知識創造時,認知機制怎麼運作;這篇則補上更上游的問題:組織要怎麼設計一個環境,讓這些人機互動可以被安全地觀察、比較、放大、制度化。對我未來研究,至少有三個可直接延伸的方向。第一,我可以把 CORE 轉譯成 knowledge creation 的組織版架構,例如能力未知對應 epistemic affordances,機會未知對應新知應用場景,風險未知對應 trust、error、deskilling 問題,ecosystem 未知則對應平台依賴與制度壓力。第二,這篇很適合跟我關心的 cognitive style 文獻結合,去問不同認知風格的員工是否在 sandbox 裡學得不同、信任不同、過度依賴風險不同。第三,它提供了一個很好的 bridge,讓我未來不只研究「人怎麼跟 GenAI 合作」,而是研究「組織如何設計條件,讓這種合作變成可持續的知識創造機制」。
12. 整體評價
我認為這篇是 backlog 裡非常值得優先讀的理論型實證文,而且它的價值不只在題目新,而在它真的抓到目前多數 GenAI 組織研究最缺的一塊:探索期的方法論。很多文章不是停在 adoption intentions,就是直接談 implementation outcomes,中間這段「企業到底怎麼摸清楚自己該不該、怎麼樣、在哪裡用 GenAI」常常被跳過。這篇的強項是同時有框架、有實地 longitudinal data、也有對治理與高階學習層次的清楚連結。它不是最精準估計效果大小的文章,但非常適合當成我未來討論 organizational learning、dynamic capabilities、human-GenAI collaboration 與 knowledge creation 之間關係的橋梁文獻。若要挑缺點,就是它的單一個案限制仍在,且部分 findings 偏管理報告式而非嚴格比較設計;但即便如此,作為概念框架加深描個案,它仍然很強。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。