文獻筆記・
素養悖論:AI 素養反而放大對 AI 新聞的偏見
本文要回答兩個核心問題。第一,AI literacy 是否會和新聞類型產生交互作用,改變人們對 AI 生成新聞的 message credibility 與 source credibility。…
- 論文
- The literacy paradox: How AI literacy amplifies biases in evaluating AI-generated news articles
- 作者
- WooJin Kim, Yuhosua Ryoo(2026)
- 期刊
- International Journal of Information Management, 86, 102992
- DOI
- 10.1016/j.ijinfomgt.2025.102992
- 分類
- 管理
1. 基本資訊
這篇文章由 WooJin Kim 與 Yuhosua Ryoo 發表於 2026 年的 International Journal of Information Management,題目是〈The literacy paradox: How AI literacy amplifies biases in evaluating AI-generated news articles〉,DOI 為 10.1016/j.ijinfomgt.2025.102992。作者關心的是,當人們更了解 AI 如何生成新聞之後,這份理解究竟會讓他們更批判、更平衡,還是反而更容易用對 AI 既有的刻板印象來做判斷。
2. 研究問題
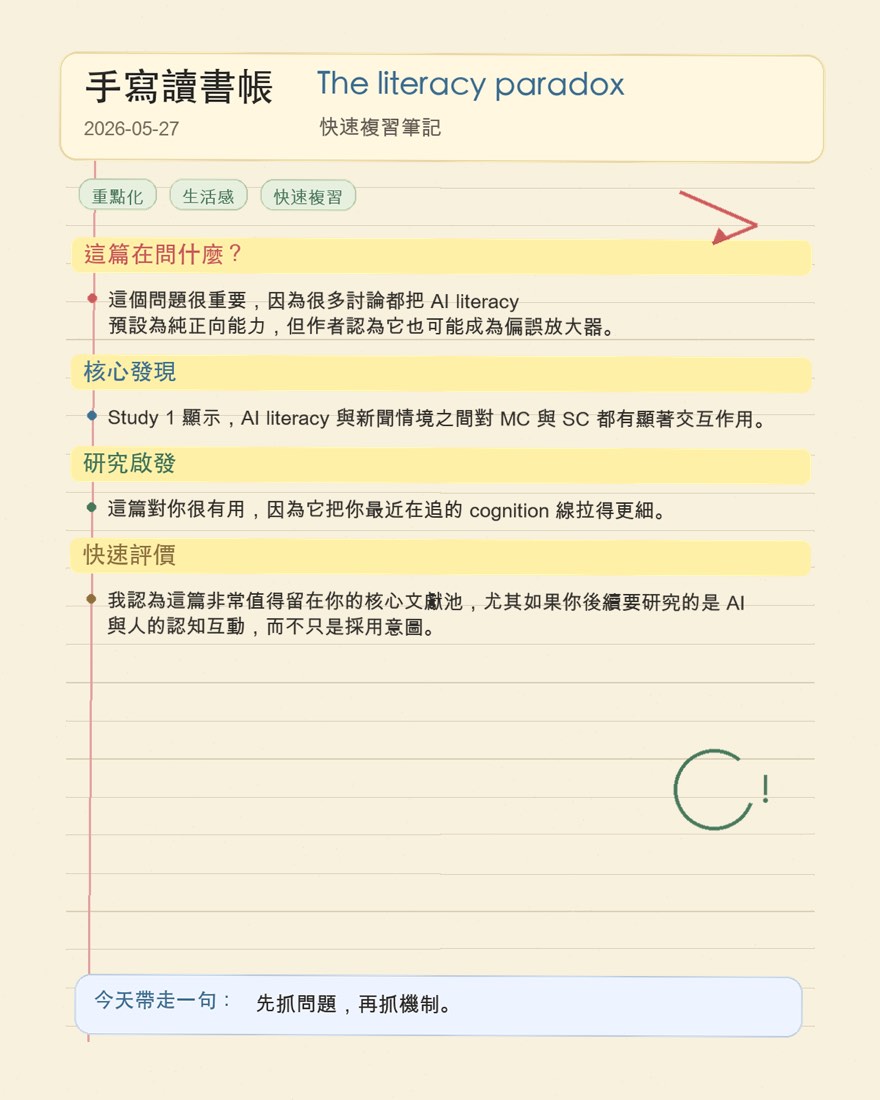
本文要回答兩個核心問題。第一,AI literacy 是否會和新聞類型產生交互作用,改變人們對 AI 生成新聞的 message credibility 與 source credibility。第二,這個效果是否是透過兩種相反的認知捷思發生,也就是 automation bias 與 algorithmic aversion。這個問題很重要,因為很多討論都把 AI literacy 預設為純正向能力,但作者認為它也可能成為偏誤放大器。
3. 理論基礎
理論上,本文結合 AI literacy、confirmation bias 與 machine heuristics。作者認為,AI literacy 並不會自動帶來更中性的判斷,反而可能讓個體更有系統地確認自己對 AI 的既有印象。若面對 data-driven news,受眾會更容易啟動 automation bias,將 AI 視為客觀、精準、擅長處理數據的系統;若面對 interpretive news,受眾則更容易啟動 algorithmic aversion,認為 AI 缺乏情感理解、價值判斷與脈絡敏感度。
4. 研究架構
作者把新聞內容分成兩類。第一類是 data-driven news,重在數據、事實、統計與客觀呈現;第二類是 interpretive news,重在評論、脈絡、情感與主觀判斷。AI literacy 作為主要自變項,會依新聞類型不同,分別推動 automation bias 或 algorithmic aversion,再影響對 message credibility 與 source credibility 的評價。整體模型很清楚:不是 AI literacy 直接造成單向信任,而是 AI literacy 讓人更依賴自己對 AI 擅長什麼、不擅長什麼的認知圖式。
5. 假設邏輯
H1 主張 AI literacy 與 news context 之間存在交互作用。對 data-driven articles 而言,較高 AI literacy 會提高對訊息與來源的可信度;對 interpretive articles 而言,較高 AI literacy 反而會降低兩者可信度。H2 則進一步指出中介路徑:在 data-driven news 情境下,AI literacy 會提升 automation bias;在 interpretive news 情境下,AI literacy 會提升 algorithmic aversion。作者的邏輯不是「了解愈多愈理性」,而是「了解愈多,愈容易把 AI 放進既有能力刻板印象中」。
6. 方法
研究一共做了三個 study,先用 pretest 驗證 AI literacy 操弄與新聞情境操弄是否有效。Study 1 以社會福利新聞為情境,採線上實驗設計,納入 211 位 MTurk 參與者,以連續量測的 AI literacy 搭配 data-driven / interpretive 兩種新聞,檢驗 credibility 差異。Study 2 改用 cyberbullying 主題,納入 242 位參與者,直接操弄高低 AI literacy 與兩類新聞情境,驗證 H1 的穩健性。Study 3 再把設計推到更真實的互動場景:建立 Facebook Messenger 上的 AI news chatbot,以運動新聞情境測試 moderated mediation,檢驗 automation bias 與 algorithmic aversion 是否真的是中介機制。主要依變項是 message credibility 與 source credibility。
7. 結果
結果非常一致。Study 1 顯示,AI literacy 與新聞情境之間對 MC 與 SC 都有顯著交互作用;高 AI literacy 在 data-driven news 下會提高對內容與來源的可信度,但在 interpretive news 下會降低可信度。Study 2 重現了同樣圖形,而且效果量不小:在 data-driven news 中,高 AI literacy 者的 message credibility 平均數約 6.05,高於低 literacy 組的 5.44;source credibility 約 6.07,高於 5.51。相反地,在 interpretive news 中,高 literacy 組的 message credibility 約 4.88,低於低 literacy 組的 5.59;source credibility 約 5.06,低於 5.68。Study 3 進一步證明,這個交互作用是透過兩條不同中介路徑發生:data-driven news 主要經由 automation bias 提高 credibility,interpretive news 則主要經由 algorithmic aversion 降低 credibility。
8. 理論貢獻
這篇最大的理論價值,是把 AI literacy 從單向正向資源改寫成雙面刃。第一,它挑戰「提升 AI literacy 就會帶來更成熟判斷」的常見假設,指出 literacy 本身可能放大偏誤。第二,它把 confirmation bias 與 machine heuristics 明確接到 AI journalism 的情境裡,說明人們不是在真空中評估 AI,而是透過對 AI 能力的刻板分類來判斷。第三,它提供了一個很可重用的情境化框架:AI 的評價效果會受 task / content type 調節,不能把所有 AI 應用混在一起看。
9. 實務意涵
對新聞平台或內容設計者而言,這篇有很實際的提醒。若 AI 主要產出數據型、事實型內容,適度揭露 AI 如何處理資料、如何運作,反而有助於強化信任;但若是評論型、情感型、價值判斷型內容,過度強調「這是 AI 做的」與其演算法邏輯,可能會激起反感與懷疑。換句話說,透明不是萬用解方,要看內容類型與受眾認知。對做 AI literacy 教育的人來說,也不能只教技術理解,還要教人辨識自己對 AI 的能力刻板印象。
10. 研究限制
限制主要有幾個。第一,樣本多來自 MTurk,雖然方便取得較大樣本,但未必完全代表一般大眾。第二,Study 1 與 Study 2 雖然主題換了社福與網路霸凌,Study 3 也換到運動,但畢竟都仍屬新聞消費情境,外推到其他 AI 內容場景要保守。第三,AI literacy 的短期操弄雖然有效,但和真實世界長期累積的素養不完全等同。第四,Study 3 需要參與者能登入 Facebook Messenger,可能排除了某些媒體使用型態不同的人。
11. 對我研究的啟發
這篇對我很有用,因為它把我最近在追的 cognition 線拉得更細。第一個可直接延伸方向,是把這個 literacy paradox 轉到 human-GenAI collaboration 任務裡,去問對 AI 更熟的人,是不是反而更容易在某些任務上過度信任、在另一些任務上過度排斥。第二個方向,是把 AI literacy 與 cognitive style 接起來,例如分析型與直覺型個體,是否會以不同方式啟動 automation bias 或 algorithmic aversion。第三個方向,是把這篇和我前面讀過的 anchoring、trust、reasoning transparency 文獻整合,形成一個更完整的模型:人不是單純「知道 AI 更多」就更會用 AI,而是會在不同內容與任務脈絡下,用不同認知捷思重新校準信任與拒斥。
12. 整體評價
我認為這篇非常值得留在我的核心文獻池,尤其如果我後續要研究的是 AI 與人的認知互動,而不只是採用意圖。它的強項是問題設定很準,知道今天真正值得問的不是「AI literacy 有沒有幫助」,而是「它在什麼條件下會幫助,什麼條件下反而加劇偏誤」。三個 study 的設計也讓論點從 scenario 一路推到較真實的 chatbot 互動,說服力夠。若要挑剔,就是它的依變項仍集中在 credibility perception,而不是更長期的行為採納或知識創造結果;但作為我建立 AI literacy × cognition × task-context 機制模型的橋梁文,這篇很強。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。