文獻筆記・
知識工作者會不會聽 AI 的建議
這篇文章要回答的核心問題,不只是知識工作者會不會使用 GenAI,而是當他們在高複雜、專業型任務裡收到 GenAI 建議時,實際上會不會比收到人類專家的建議更願意採納。作者把問題拆成三層。第一層是…
- 論文
- Knowledge workers’ trust and reception of generative AI’s advice in complex tasks
- 作者
- Alireza Amrollahi, Jiaqi Yang, Syed Muhammad Fazal-e-Hasan, Basma Badreddine(2026)
- 期刊
- International Journal of Information Management, 88, 103031
- DOI
- 10.1016/j.ijinfomgt.2026.103031
- 分類
- 管理
2. 研究問題
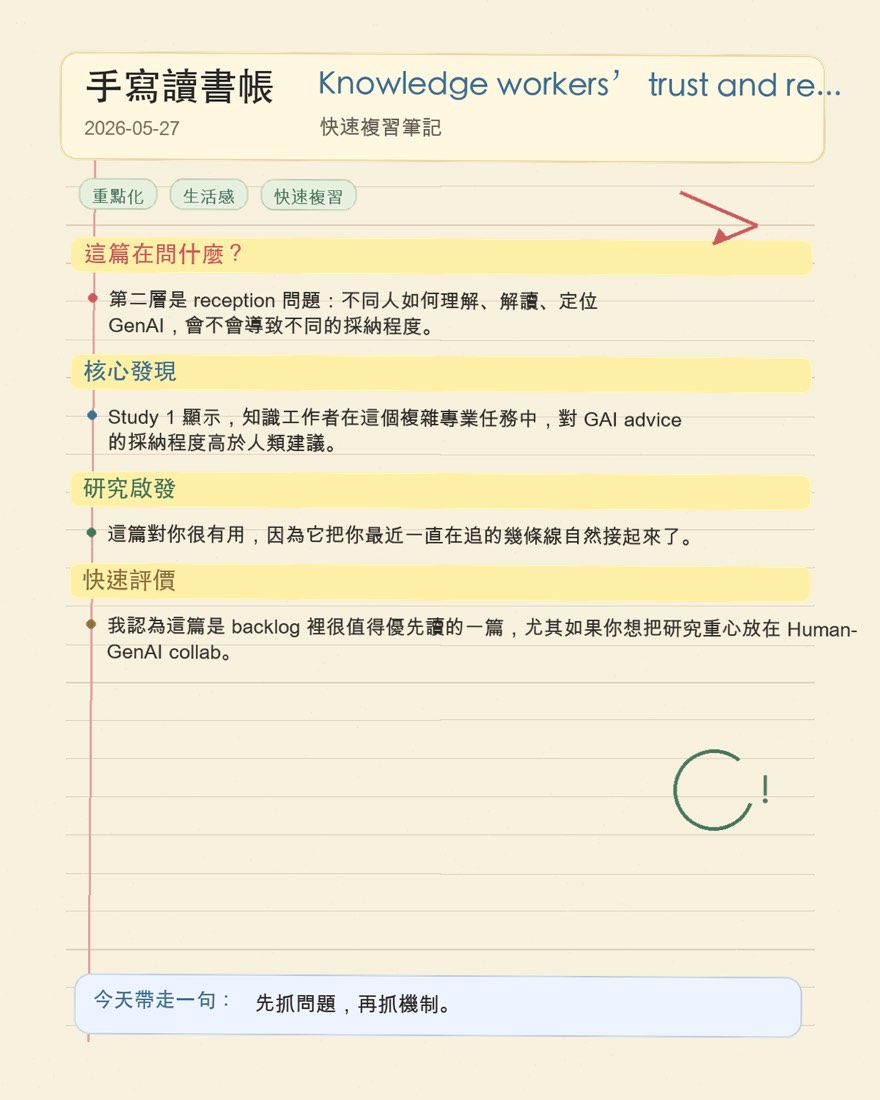
這篇文章要回答的核心問題,不只是知識工作者會不會使用 GenAI,而是當他們在高複雜、專業型任務裡收到 GenAI 建議時,實際上會不會比收到人類專家的建議更願意採納。作者把問題拆成三層。第一層是最直接的比較:知識工作者在複雜任務中,對 GenAI 建議與人類專家建議的 advice-taking 行為是否不同。第二層是 reception 問題:不同人如何理解、解讀、定位 GenAI,會不會導致不同的採納程度。第三層則是機制問題:technological innovativeness 是否會透過 competence-based trust、integrity-based trust 與 emotional trust 影響實際 advice-taking。換句話說,作者不是停在 adoption intention,而是把焦點放到更接近真實協作的「你最後有沒有真的把 AI 建議拿來改判斷」。
3. 理論基礎
本文主要結合兩條理論線。第一條是 trust theory,特別是 IS 文獻中把信任拆成 competence-based trust、integrity-based trust 與 emotional trust 的做法。作者認為,知識工作者是否採納 GenAI 的建議,不是單看它看起來聰不聰明,而是要區分他們是否相信 AI 有能力、是否覺得它做事有原則,以及是否在情感上願意安心依賴它。第二條則是 reception theory。這原本多用在媒體與文化研究,強調使用者不是被動接收訊息,而是會依自己的背景、經驗與價值觀主動詮釋技術。作者把 reception 分成 dominant、negotiated、oppositional 三類,用來理解同樣一個 GenAI 建議,為什麼有人會積極採納、有人邊用邊保留、有人則先天抗拒。再加上 technological innovativeness 這個個人特質變項,文章就把「願不願意吃 AI 建議」從單一態度問題,提升成結合個人傾向、詮釋框架與信任形成的完整模型。
4. 研究架構
整體設計是三段式 multi-study。Study 1 用實驗比較知識工作者在複雜專業任務中,面對 GAI 建議與人類建議時的 weight-on-advice(WOA)差異,用來回答 RQ1。Study 2 聚焦在 GAI 情境本身,透過 reception survey 加上 K-means clustering,把受試者分成 dominant、negotiated、oppositional 三群,再比較各群的 WOA,用來回答 RQ2。Study 3 則用問卷模型檢驗 innovativeness 如何透過 competence-based trust、integrity-based trust、emotional trust 影響 advice-taking,並進一步檢查這條機制在不同 reception 群體之間是否有 path variance。除此之外,作者還補做了一個 configurational analysis,以 fsQCA 檢查 task complexity、perceived security risk、past exposure 這些情境因素如何組合成高或低 trust。這讓整篇文章同時具備行為比較、心理機制與情境組態三種層次。
5. 假設邏輯
作者的推論很清楚。首先,GenAI 已經不再只是規則式或窄功能的傳統演算法,而是能處理含糊、非結構化、帶創造性與專業判斷的任務,因此過去「知識工作者通常排斥演算法建議」的結論可能不再穩定成立。這構成 H1 的基礎,也就是知識工作者在複雜任務中可能反而更欣賞 GAI advice。其次,根據 reception theory,不同人不是只是多一點或少一點採納意願,而是用不同詮釋框架看待 GAI:dominant reception 的人傾向把 GAI 視為有價值且可合作的對象,oppositional reception 的人則更容易用懷疑與抵抗的方式解碼它,因此 H2 預期不同 reception group 會有不同 advice-taking 程度。第三,作者認為 innovativeness 會先影響 trust formation,再影響是否採納建議。高 innovativeness 的人較可能先建立 competence-based trust,進而推動 integrity-based trust 與 emotional trust;最後由 emotional trust 最直接帶動 advice-taking。H4 則更進一步主張,這套機制在不同 reception 群體之間不會完全一樣,因為相同的信任訊號,會被不同群體用不同方式解讀。
6. 方法
Study 1 招募了 259 位美國專業程式設計師,平均年齡 32 歲、平均工作經驗約 2 年,隨機分派到 human advice 與 GAI advice 兩組。任務是閱讀一段由 junior programmer 撰寫的 Python 程式碼,估計其中的錯誤數量;之後再得知「GitHub Copilot」或「一位資深程式設計師」判斷有 9 個錯誤,並據此修正自己的原判斷。研究用 WOA 衡量受試者採納建議的程度。Study 2 招募 148 位美國程式設計師,只保留 GAI 情境,先做 reception 問卷,再用 K-means 分成三群:N1=51、N2=45、N3=52,接著比較不同群的 WOA。Study 3 使用 175 位美國專業程式設計師的問卷資料,量測 innovativeness 與三種信任構面,採三步驟分析:CFA、path analysis、group moderation。補充的 configurational study 同樣使用 175 位樣本,加入 past exposure、task complexity、perceived security risk,使用 fsQCA 分析高信任與低信任的組態。
7. 結果
Study 1 顯示,知識工作者在這個複雜專業任務中,對 GAI advice 的採納程度高於人類建議。清理資料後 human 組為 111 人、GAI 組為 148 人;由於 WOA 分布不正常,作者使用 Wilcoxon rank sum test,比較結果達顯著(W = 6978, p = .028),平均 WOA 為 MHuman = 0.56、MGAI = 0.68,效果量 r = 0.14。這表示至少在程式審查這種複雜任務裡,受試者並沒有表現出傳統文獻常說的 algorithm aversion,反而更願意往 GAI 建議靠攏。Study 2 顯示 reception 確實會影響 advice-taking。三群的 WOA 差異在 Kruskal-Wallis test 下達顯著(statistic = 7.99, p = .018, ε² = 0.041);pairwise comparison 中,dominant group 的 WOA 顯著高於 oppositional group(Bonferroni corrected p = .019783),但 negotiated group 與另外兩群的差異不顯著。Study 3 則支持大多數信任路徑:innovativeness 顯著提升 competence-based trust(β = .412, z = 4.753),但對 integrity-based trust 的直接效果不顯著(β = .041, ns);competence-based trust 顯著提升 integrity-based trust(β = .762)與 emotional trust(β = .324),integrity-based trust 也顯著提升 emotional trust(β = .616),而 emotional trust 進一步正向影響 WOA(β = .151, z = 1.997)。Reception group moderation 顯示至少三條路徑具有群間差異:innovativeness → competence-based trust、competence-based trust → integrity-based trust、integrity-based trust → emotional trust。補充的 fsQCA 則發現,高 competence-based trust 常由兩種配置產生:一是高 task complexity 加上 past exposure 的「Cognitive Load Relief」,二是 past exposure 加上低 perceived security risk 的「Safe Familiarity」;而低 trust 則常來自「Unfamiliarity Effect」與「Unneeded and Unsafe」。
8. 理論貢獻
這篇文章的第一個理論價值,是它正面挑戰了「knowledge workers 對演算法建議通常較排斥」這條常見敘事。作者指出,在 GenAI 時代,尤其當 AI 已能處理高階、模糊、非例行的專業任務時,algorithm aversion 未必仍是預設結論。第二個貢獻,是把 reception theory 有效帶進 IS / human-AI interaction 文獻。很多研究會談 trust、adoption、intention,但較少真正處理「使用者如何主動解讀 AI」;這篇補上了詮釋層,讓 dominant / negotiated / oppositional 不只是態度標籤,而是與 advice-taking 行為直接相關的分析架構。第三個貢獻,是把 innovativeness 與多維 trust 串成序列性機制,指出真正驅動 advice-taking 的,不只是對技術新奇性的開放,而是這種開放如何先轉成 competence judgment,再推進到 integrity 與 emotional reliance。最後,fsQCA 的補充讓文章不只是一條線性 SEM 模型,而是補出了 trust 形成的情境組合邏輯。
9. 實務意涵
對組織來說,這篇最重要的提醒是:在知識工作場景裡,不要預設員工一定會抗拒 GenAI,也不要反過來假設大家都會自然接受。真正關鍵的是 reception segmentation 與 trust design。若組織只做一套通用導入方案,dominant 使用者可能很快擴大採用,但 oppositional 使用者會留在低採納狀態,形成內部落差。第二,管理者若希望員工在複雜任務中有效利用 GAI,應優先設計能建立 competence-based trust 的使用情境,例如讓使用者在高複雜任務中看到 AI 的具體幫助,而不是只做抽象宣傳。第三,past exposure 很重要。安全、低風險、可逐步熟悉的使用經驗,會比空泛的倡議更能建立 trust。第四,安全風險認知也不能忽略;若員工覺得任務不複雜、又認為 AI 不安全,就很容易落入「Unneeded and Unsafe」的低信任配置。換句話說,GAI 導入應該是差異化、分群化、情境化,而不是一刀切。
10. 研究限制
這篇有幾個明顯限制。第一,三個 study 都以美國專業程式設計師為主,雖然這群人是很好的 knowledge worker 代表,但外推到教師、顧問、研究人員、設計師或跨部門管理工作者時仍要保守。第二,實驗任務是程式碼錯誤審查,雖然屬於複雜專業任務,但畢竟仍是單一情境,對其他型態的知識工作是否一樣成立還需要再驗證。第三,WOA 衡量的是根據建議修正判斷的程度,不等於長期信任、持續依賴或真實組織績效。第四,Study 3 的模型顯示 innovativeness 無法直接提升 integrity-based trust,這意味著信任形成仍可能受更複雜的倫理、透明度與控制感因素影響,但這篇沒有更細拆。第五,reception 群體差異雖然存在,但 negotiated group 和其他兩群差異不明顯,代表理論分類在實務上可能比想像中更模糊。
11. 對我研究的啟發
這篇對我很有用,因為它把我最近一直在追的幾條線自然接起來了。我前面讀的文多半在談 Human-GenAI collaboration 對 creativity、knowledge creation 或 organizational learning 的正負效果,但這篇補上了一個很關鍵的「前置條件」問題:人為什麼願意把 GenAI 建議真正納入自己的判斷。這對我後續做 AI × cognition × knowledge creation 很重要,因為知識創造不只取決於 AI 能產出什麼,也取決於人會不會接納、修改、重組、內化那些產出。第一個可直接延伸的方向,是把 reception 當成認知或解釋框架變項,去看不同認知風格的人是否更容易落在 dominant、negotiated 或 oppositional reception。第二個方向,是把本文的 trust sequence 接到 knowledge creation 流程裡,例如 competence-based trust 可能影響知識探索,integrity-based trust 可能影響知識驗證,而 emotional trust 可能影響最終是否把 AI 產出整合進工作成果。第三個方向,是把這篇和我前面讀過的創意階段、組織 sandbox、cognitive style 文章合在一起,形成一個更完整的 phase-based model:組織設計情境、個體帶著不同 reception 與 trust 進入人機互動,最後才影響知識創造與創新結果。這樣我未來的研究模型會比單純問「AI 有沒有幫助」更有理論厚度。
12. 整體評價
我認為這篇是 backlog 裡很值得優先讀的一篇,尤其如果我想把研究重心放在 Human-GenAI collaboration 的心理與組織機制,而不是只停在 adoption 或 performance。它的優點是問題抓得很準,知道在 GenAI 時代,真正值得問的不是「人喜不喜歡 AI」這種粗問題,而是「在複雜知識工作裡,人會不會真的根據 AI 建議改變判斷,以及這背後的 trust 與 reception 怎麼運作」。方法上它不只做單一 survey,而是用兩個行為實驗加上一個信任模型,再補一個 configurational analysis,說服力很夠。最值得保留的,是它把 reception theory 引進來,讓我在未來討論 AI 採納時,不必只用 TAM 或一般 trust 變項,而能更細地說明不同人如何解碼與定位 GenAI。若要挑缺點,就是樣本和任務仍偏向 programming context,且 WOA 雖然是很好的行為指標,但還不足以等同真實長期協作成效。不過整體來看,這篇非常適合當我後續建構 trust / cognition / knowledge creation bridge model 的關鍵文獻。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。