文獻筆記・
協作型 AI 如何提升組織績效
本文要處理的核心問題是:當組織把生成式 AI 當成協作工具導入工作流程時,哪些任務真的會被做得更好,這種提升又是來自 AI 本身、員工的 AI 使用經驗,還是兩者與任務特性之間的適配。作者把問題具…
- 論文
- Collaborative AI in the workplace: Enhancing organizational performance through resource-based and task-technology fit perspectives
- 作者
- Aleksandra Przegalinska, Tamilla Triantoro, Anna Kovbasiuk, Leon Ciechanowski, Richard B. Freeman, Konrad Sowa(2025)
- 期刊
- International Journal of Information Management, 81, 102853
- DOI
- 10.1016/j.ijinfomgt.2024.102853
- 分類
- 管理
1. 基本資訊
這篇文章是 Aleksandra Przegalinska、Tamilla Triantoro、Anna Kovbasiuk、Leon Ciechanowski、Richard B. Freeman 與 Konrad Sowa 發表於 2025 年《International Journal of Information Management》的研究,題目為〈Collaborative AI in the workplace: Enhancing organizational performance through resource-based and task-technology fit perspectives〉。從 PDF metadata 可辨識 DOI 為 10.1016/j.ijinfomgt.2024.102853。文章以 mixed-method design 結合實驗與文字分析,聚焦生成式 AI 在工作場域中的協作價值,而不是只從採用意願或主觀態度切入。
2. 研究問題
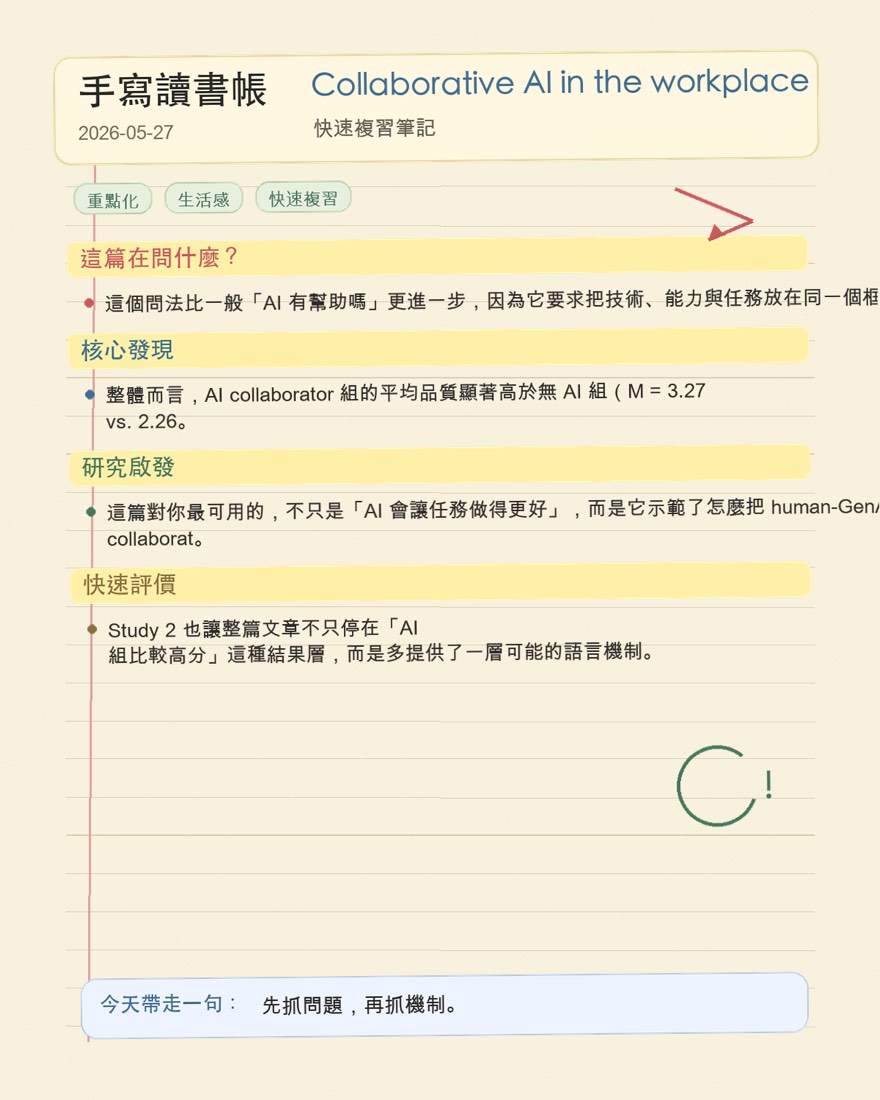
本文要處理的核心問題是:當組織把生成式 AI 當成協作工具導入工作流程時,哪些任務真的會被做得更好,這種提升又是來自 AI 本身、員工的 AI 使用經驗,還是兩者與任務特性之間的適配。作者把問題具體化成一條很實務也很理論化的研究主線,也就是在考慮人類技能與任務複雜度、創意需求之後,協作式 AI 如何優化 organizational performance。這個問法比一般「AI 有幫助嗎」更進一步,因為它要求把技術、能力與任務放在同一個框架裡一起看。
3. 理論基礎
理論上,本文把 Resource-Based View 與 Task-Technology Fit 結合。RBV 負責回答「為什麼 AI 能成為競爭優勢來源」,主張 AI 若要形成優勢,不能只被當成可買到的工具,而必須和組織中的互補性人力資本、流程與能力整合起來。TTF 則處理比較微觀的問題,也就是技術價值取決於它和任務需求是否真的匹配。作者因此不是把 AI 視為萬用生產力插件,而是視為一種必須和任務類型對齊的策略資源;這讓研究同時能談組織層級的 advantage,也能談任務層級的 performance。
4. 研究架構
研究架構可理解為一個「資源 × 任務」的雙軸模型。作者先用簡單/複雜、例行/創意兩條維度,把任務分成四類:automation、decision support、creation、innovation。接著主張,AI 資源與員工 AI 經驗會透過不同任務的適配程度,轉化為更高的任務品質與組織績效。實證上又分成兩個互補研究:Study 1 直接測試有無 AI 協作者時的任務品質差異;Study 2 分析人機互動文本的語言特徵,檢查 AI 的語氣、句構與詞彙是否揭示它在哪些任務上更有優勢。
5. 假設邏輯
本文是標準假設檢驗研究。H1 主張,具備進階生成式 AI 資源與能力、且能有效整合者,會有較高競爭優勢;在研究操作上,這被轉寫成有 AI 協作者的組別,整體任務品質高於無 AI 協作者組。H2 主張,員工越有 AI 使用經驗,越能把這種資源轉成更好的任務表現。H3a 到 H3d 則把 TTF 的邏輯拆進四種任務,預期 AI 導入後,persona ideation、competitive analysis、text-based ad 與 product naming 這四類任務的績效都會優於不使用 AI。也就是說,作者預期的不是單一場景的局部效果,而是 AI 在不同任務類型中都可能有增益,只是增益背後的理由不同。
6. 方法
研究採 mixed-methods。Study 1 是實體進行的 lab experiment,總樣本 94 人,去除缺漏後有效樣本為 AI collaborator 組 41 人、無 collaborator 組 48 人;參與者主要來自中歐一所大型商學院,包括管理學研究生與 Executive MBA 學員,多數有工作經驗且不少人具中高階管理背景。任務情境設定為一家功能性口香糖新品的行銷專案,受試者要完成四項任務:persona ideation、competitive analysis、text-based ad、product naming。研究團隊另外建了一個以 GPT-3.5 為基礎、經 instruction tuning 的對話式 marketing assistant,強調會追問、短答、協作,而不是單次長篇吐答案。任務成果由 3 位資深行銷專家/教授盲評,依 1 到 5 分評估品質。Study 2 則從 AI collaborator 組中選取至少 8 則訊息的人機對話 log 共 34 份,分析 sentiment、Flesch-Kincaid、Gunning Fog、lexical diversity、平均句長與 vocabulary level,並把使用者文本特徵與任務品質做關聯分析。
7. 結果
結果相當乾淨。整體而言,AI collaborator 組的平均品質顯著高於無 AI 組(M = 3.27 vs. 2.26;t(68.24) = 6.73,p < .001,d = 1.47),支持 H1。四項任務分別也都顯著提升:persona ideation(3.10 vs. 2.09;t = 5.02,p < .001,d = 1.09)、competitive analysis(3.33 vs. 2.06;t = 6.29,p < .001,d = 1.34)、text-based ad(3.16 vs. 2.04;t = 6.46,p < .001,d = 1.41)、product naming(3.49 vs. 2.82;t = 4.76,p < .001,d = 1.01),因此 H3a-H3d 全部獲得支持。H2 則只得到部分支持:較高的先前 AI 經驗會提升平均品質的迴歸預測,但在 AI 組內部細拆時,只對 persona ideation 與 competitive analysis 顯著,且一個有意思的反差是低經驗組在部分任務上反而高於高經驗組。Study 2 顯示 AI 產出的語氣更正向、句子更長、Gunning Fog 更高、詞彙等級更高,但 lexical diversity 較低;就人類使用者文本與任務品質的關聯來看,competitive analysis、text-based ad 與 product naming 的高品質表現,通常伴隨較高的句構複雜度與較長句子,persona ideation 則沒有明顯語言特徵對應。
8. 理論貢獻
這篇最大的理論價值,是把 RBV 與 TTF 真正做了可檢驗的整合,而不是只在文獻回顧裡並列兩個框架。第一,它把生成式 AI 從「普遍有用的工具」推進成「需與任務結構對齊的策略資源」,讓 competitive advantage 不再只是抽象口號。第二,它提出一個容易重用的任務分類框架,把工作拆成 routine/creative 與 simple/complex 四象限,對後續 human-AI collaboration 研究很有操作性。第三,Study 2 用語言特徵補強了 Study 1 的效果比較,讓 AI 為何在某些決策支援或創意任務中有優勢,不只是結果上的「有差」,而是能回到語言複雜度、細節處理與正向語氣等機制線索來理解。
9. 實務意涵
對組織管理者來說,這篇最直接的訊息是:導入 GenAI 不應該問「要不要全面上」,而是問「哪一類任務先上最划算」。作者建議企業把 AI 明確佈署在 routine automation、decision support、creative production 與 innovation ideation 等可見價值場景,同時持續投資員工的 AI 素養與協作能力,而不是把 AI 視為直接替代人力的黑箱工具。另一個實務重點是協作介面設計。本文使用的 assistant 不是單純 answer bot,而是會追問與共作的 dialogue-oriented assistant,這意味著人機協作品質不只取決於模型能力,也取決於互動結構是否鼓勵補充資訊、修正方向與共同建構。
10. 研究限制
限制至少有五個。第一,研究場景集中在商學院學員與行銷任務,外推到其他產業、職業與高風險決策環境時要保守。第二,使用的是特定時點的 GPT-3.5 與自建 assistant,模型世代快速變動,結果未必能無縫套用到後續更強模型。第三,評分雖由 3 位專家進行,但 Krippendorff’s alpha 約 0.464,顯示評審一致性只有中度。第四,Study 2 只分析 34 份對話,且排除了較短對話,因此比較像機制輔助證據,不是獨立的大樣本文本研究。第五,RBV 與 TTF 雖然能解釋資源與適配,但對個體差異、主觀知覺、權力關係與信任動態的捕捉仍有限。
11. 對我研究的啟發
這篇對我最可用的,不只是「AI 會讓任務做得更好」,而是它示範了怎麼把 human-GenAI collaboration 放進一個夠厚的組織與任務框架裡。我最近一直在追 cognition、knowledge seeking、knowledge creation 與 collaboration mechanism,這篇剛好補上了一塊常被忽略的中層結構:不同知識工作不是平的,AI 的作用會因任務是探索型、分析型、創意型還是命名型而改變。第一個可延伸方向,是把這套 simple/complex × routine/creative 任務分類,結合我關心的認知風格,去問不同 cognitive style 的人在哪一類 human-AI task fit 上最容易發揮知識創造。第二個方向,是把 Study 2 的語言特徵想法轉進 knowledge creation 過程研究,檢查人機共作中的提問密度、句子展開方式、詞彙層次與最終創意/洞察品質之間是否存在穩定關聯。第三個方向,是重新思考 AI personalisation 或 AI capability 不該只當刺激變項,而可以當作組織能力配置的一部分,去問組織如何透過 training、interface design 與 workflow governance,把人機協作導向更高品質的知識產出。
12. 整體評價
我認為這篇是 backlog 裡很值得優先讀的一篇,因為它兼具三個優點:題目貼近我目前主線、理論框架夠完整、方法上也不是只有概念評論。它的強項在於把協作式 AI 放進真實可操作的任務比較中,讓 RBV 與 TTF 不只是背景板,而是能對應到不同工作類型與實際績效差異。Study 2 也讓整篇文章不只停在「AI 組比較高分」這種結果層,而是多提供了一層可能的語言機制。不過它還是偏向任務績效與行銷情境,對我真正最在意的 deep knowledge creation、longitudinal collaboration 與個體異質性,只能算提供了一個非常好用的起點,而不是終點。就 backlog 清理順序來看,這篇作為「把組織資源配置、任務設計與 human-AI collaboration 接起來」的橋梁文,優先處理是合理的。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。