文獻筆記・
用 GPT 模擬受試者重做旅遊實驗
這篇文章要回答的核心問題是:大型語言模型是否能作為一種「AI 生成受試者」,在旅遊研究中的情境式實驗裡,重現原本人類受試者的主要效果方向,並作為前測、交叉驗證與方法輔助工具。作者並不是要宣稱 GP…
- 論文
- Understanding AI-Generated Experiments in Tourism: Replications Using GPT Simulations
- 作者
- Xiling Xiong, IpKin Anthony Wong, GuoQiong Ivanka Huang, Yixuan Peng(2024)
- 期刊
- Journal of Travel Research, 64(8), 1771-1787
- DOI
- 10.1177/00472875241275945
- 分類
- 觀光
2. 研究問題
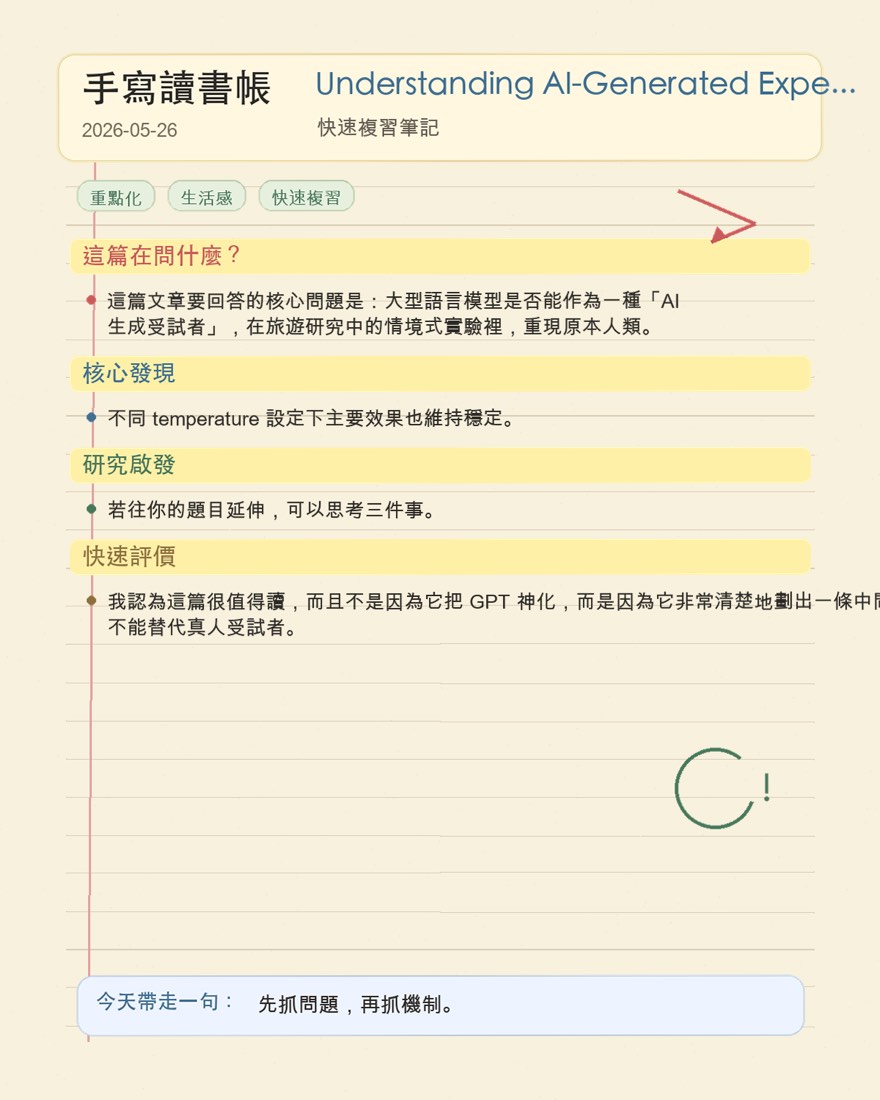
這篇文章要回答的核心問題是:大型語言模型是否能作為一種「AI 生成受試者」,在旅遊研究中的情境式實驗裡,重現原本人類受試者的主要效果方向,並作為前測、交叉驗證與方法輔助工具。作者並不是要宣稱 GPT 可以取代真人受試者,而是想測試它能否成為研究流程中的補充性方法資源,尤其是在成本高、招募慢、前測麻煩的情境式研究裡,先提供一個快速且有方向感的模擬層。
3. 理論基礎
本文的理論基礎不是單一管理理論,而是建構在三組文獻之上。第一,是情境式實驗與旅遊行為研究傳統,因為大量旅遊研究本來就依賴文字情境刺激,讓受試者想像自己處於特定旅遊脈絡後再作答。第二,是 LLM 可模擬平均人類判斷與行為偏誤的相關研究,包含 GPT 在人格量表、行為經濟、生成代理人等研究中的初步證據。第三,是方法論上對模擬、前測與 cross-validation 的需求,也就是當實證研究易受抽樣偏誤、成本與時程限制影響時,是否存在一種可先行驗證方向與邏輯的補充工具。
4. 研究架構
整體研究分成兩個層次。Study 1 先用單一已發表且 GPT 訓練資料不應完整覆蓋的旅遊情境實驗作為基準,檢驗 GPT 能否重現主效果、中介效果與調節效果。Study 2 再把範圍擴大到 15 篇來自 6 本主要旅遊/觀光/旅館期刊、且 2022 年後發表的文字型情境實驗,測試 GPT 在更大樣本與更異質的情境中,是否仍能重現原研究的效果方向。之後作者再做 robustness checks,分別改變溫度參數、LLM 種類、語言與角色設定,檢驗 AGS(AI-generative study)方法的穩定性。
5. 假設邏輯
本文不是典型先列 H1、H2 的假設檢驗格式,比較像方法論命題。其核心推論邏輯是:如果 GPT 所內含的語言與社會經驗表徵,足以近似一般人對文字型旅遊情境的判讀,那麼它在被要求扮演「旅客/學生/顧客」時,應能對相同刺激產生與原研究方向一致的反應。進一步說,如果這種一致性不只出現在單一研究,而能同時重現在主效果、中介、調節,以及不同模型、語言、角色與溫度設定中,則 AGS 就不只是偶然模仿,而可能構成一種可用於前測與交叉驗證的研究方法工具。
6. 方法
Study 1 以 Su et al. (2023) 的三個旅遊危機情境實驗為對象,因其同時含主效果、中介與調節效果,且發表時間晚於 GPT-3.5 的知識截止點。作者使用 GPT-3.5-turbo,溫度設為 0.6,把每一次獨立 query 視為一位獨立受試者,讓 GPT 依照原研究情境扮演 college student 或 tourist,以 7 點量表作答。為避免一次輸入太多題目造成回答聚集,作者分變數分批提問,再合併資料分析。
Study 2 先從 Google Scholar 以 “scenario-based experiment” 搜尋 2022 年後文獻,初步得到 619 篇,排除 review、meta-analysis、準實驗與多模態情境後,最後保留 15 篇純文字情境實驗,來自 Journal of Travel Research、Tourism Management、Annals of Tourism Research、International Journal of Hospitality Management、International Journal of Contemporary Hospitality Management、Current Issues in Tourism。分析目標是比較 AGS 與原研究在主要效果方向上的一致性。Study 2 每組樣本以 50 為原則,並用 100 組 API keys 確保 query 彼此獨立。額外 robustness tests 又檢查不同溫度、GPT-4 / Gemini、中文/德文,以及不同年齡與教育角色設定下的結果。
7. 結果
結果相當強。Study 1 中,GPT 不只通過 manipulation checks,也重現了原研究的主效果、中介效果與調節效果。外部危機相較內部危機會帶來更高的寬恕傾向,相關 ANOVA、bootstrapping mediation 與 moderation 結果都與原研究方向一致;不同 temperature 設定下主要效果也維持穩定。
Study 2 則顯示,在 15 篇情境式實驗中,GPT 所生成的 experimental group 與 control group 差異方向,與原始研究整體一致。作者以 paired t test 顯示兩組平均差異方向重現,且 AGS 與原研究在 experimental group 與 control group 的平均值之間分別有高線性相關(Pearson r = 0.85 與 0.83,皆達顯著)。在 robustness checks 中,不論換溫度、換 GPT-4 / Gemini、換中文或德文、或改變模擬角色,主要效果方向都沒有被推翻。也就是說,AGS 在「方向性重現」這件事上表現穩定,但分數平均與變異仍會隨設定變動。
8. 理論貢獻
本文最重要的理論貢獻,不是證明 AI 比人好,而是把 LLM 從「研究輔助寫作工具」推進成「方法論上的模擬受試者」。這讓 AI 在研究中的角色,從後端生產文字或整理資料,轉向前端參與研究設計、前測與交叉驗證。對旅遊與服務研究來說,這個貢獻特別關鍵,因為許多研究本來就建立在文字情境與感知反應之上,LLM 與這類設計天然相容。換句話說,作者提出的不只是某篇旅遊研究的技術操作,而是一種可被其他社會科學借用的方法想像。
9. 實務意涵
對研究者而言,AGS 可作為三種實務工具。第一,它能在正式收真人樣本前做前測,先看操弄方向與問卷邏輯是否合理。第二,它能作為 post-study cross-validation,幫助研究者判斷原始結果是否至少在方向上具有某種可重現性。第三,它能在高成本、倫理敏感或平台實驗風險過高的情境下,先跑模擬情境,降低直接在人身上測試的代價。對學術社群而言,作者也主張未來若用 GPT 當研究主體,應公開 prompts、維持程序透明,避免黑箱操作與為符合預期而微調 prompt 的問題。
10. 研究限制
作者很誠實地指出幾個限制。第一,GPT 生成資料的變異通常比真人小,因此容易得到更高統計力,這意味著「可重現方向」不等於「真實反映人類分布」。第二,GPT 扮演不同角色時,作答傾向會改變,因此其代表性仍受 prompt 設計影響。第三,本文主要驗證的是 anger、sympathy 這類較基礎的情緒反應,對懷舊、敬畏等更複雜情緒是否同樣成立,仍未知。第四,LLM 仍有知識截止、缺乏生態效度、難以捕捉個體差異與真實旅遊轉化歷程等問題,所以它最多只能是補充方法,不能替代真人研究。
11. 對我研究的啟發
這篇對我最有價值的地方,是它把「GenAI 能不能幫研究」從我態度或 adoption 問題,推到研究方法與知識生產機制層次。我近期關心的是 human-GenAI collaboration、knowledge creation、cognitive style 與創新機制,這篇剛好提供一個更底層的切口:GenAI 不只影響受試者或工作者,也可能改寫研究者本身如何產生、驗證與擴充知識。若往我的題目延伸,可以思考三件事。第一,當研究者把 LLM 納入前測、替代情境模擬與 cross-validation 時,這是否形成一種新的 knowledge-seeking routine?第二,不同 cognitive style 的研究者,會不會以不同方式信任或使用這種 AI 模擬證據,進而影響研究創意與嚴謹性的平衡?第三,若把 AGS 視為一種「人機共作的研究設計基礎設施」,那麼其價值也許不在取代人,而在於改變知識生成流程中的探索、篩選與驗證順序。這個角度很適合跟 organizational learning、sandbox experiment、methodological augmentation 連起來。
12. 整體評價
我認為這篇很值得讀,而且不是因為它把 GPT 神化,而是因為它非常清楚地劃出一條中間路線:LLM 不能替代真人受試者,但可以成為方法鏈中的高效率補充元件。文章最強的地方在於設計不只停在單一示範,而是先做深度 replication,再做跨 15 篇研究的廣度驗證,最後還補上不同模型、語言、角色、溫度的穩健性測試,說服力比單一 case 強很多。弱點則是它重視「效果方向」多於「心理真實性」,因此比較像方法 feasibility paper,而不是對人類行為機制的最終證據。即便如此,它仍然是很好的橋梁型論文,能幫我把 GenAI 研究從 adoption / attitude 類主題,進一步推往 methodology、knowledge creation 與 research augmentation 的討論。
這是我的個人閱讀筆記,整理論文重點與心得,內容以原文為準。全文請由 DOI 連結至期刊閱讀。